
维度数据建模
维度建模由 Ralph Kimball 开发。它是一种用于数据仓库数据存储的建模技术。其目的是通过优化数据库,使数据提取更快、更顺畅。维度模型用于分析,因为它可以读取、汇总和分析数据仓库中的数值数据。我们使用此模型是因为它使数据仓库数据的存储和检索更加便捷。维度模型有其独特的数据存储方式。许多 OLAP(联机分析处理)系统都使用它。
维度数据模型的元素
事实
事实是用作业务流程可衡量元素的数据。
示例:在商店中,事实可以是利润、售出商品或收入。
维度
维度是查找事实信息的路径。数据分类通过维度完成。维度被描述为一组属性。
示例:对于商品,属性可以是商品名称或价格。
属性
属性是数据建模中维度的特征,用于搜索和优化事实。
示例:对于位置,属性可以是国家/地区、州/省或地区。
事实表
事实表是由测量值组成的主表或中心表。事实表包含指向维度表的外键。
维度表
维度表描述测量值的属性。维度表引用事实,并通过外键进行连接。维度表是非规范化的表,可以具有一个或多个关系。
数据仓库模型中的维度类型
一致维度
扩展维度
收缩维度
角色扮演维度
维度到维度表
垃圾维度
退化维度
可交换维度
阶跃维度
创建维度数据建模的步骤
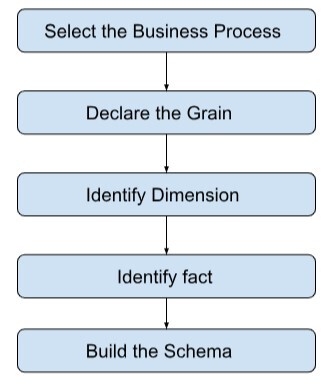
确定业务流程
首先要做的是根据组织的需求确定业务目标。业务流程的选择取决于为流程提供的数据质量类型。业务流程的描述可以使用纯文本或业务流程建模符号 (BPMN)。
确定粒度
为了确定数据仓库中任何表的最低信息级别,可以使用粒度。粒度还有助于描述任何业务问题的详细程度及其解决方案。
确定维度
维度是数据存储的位置。借助维度,我们可以通过描述数据仓库事实和度量来获得业务问题的期望输出。
识别事实
当用户访问数据仓库中存储的数据时,这些数据是可度量的。表中的行通常为数值。
构建模式
模式是一种数据库结构。维度模型的实现在此步骤中进行。以下两种模式是:
星型模式
它是最简单的数据仓库模式,具有简单的数据库设计。"星型"一词源于其结构类似于星型。模式的中心由事实表组成,事实表周围环绕着维度表。事实表和维度表之间的关系仅通过单连接来描述。
雪花型模式
它是星型模式的高级版本,因为它具有额外的维度。"雪花型"一词源于其结构类似于雪花。雪花结构由维度表包围,维度表又由维度表包围。雪花结构中使用了许多连接。雪花结构中的数据库设计非常复杂。
维度建模规则
将数据存储在维度结构中。
每个事实表都必须有一个对应的数据维度表。
确保单个事实表中每个事实的信息量或粒度相同。
必须确保在维度表中使用代理键。
创建在需求和现实之间取得平衡的业务解决方案,以协助他们做出决策
维度数据建模的优势
轻松的数据访问
维度数据建模通过简化数据访问来帮助用户。此外,它还能减少提取和分析数据的时间和精力。
增强的查询处理
维度数据建模的结构简单,可提高查询性能。
灵活性
维度数据建模提高了执行分析的灵活性,帮助用户轻松理解数据之间的关系。
数据质量
减少冗余和不一致性,从而提高数据质量。
维度数据建模的缺点
复杂性有限
维度数据建模结构简单,无法处理复杂的数据关系。
集成性有限
维度数据建模与其他数据模型(例如依赖于规范化过程的模型)的兼容性较差。
可扩展性有限
维度数据建模的可扩展性不如其他建模技术,例如用于海量数据集的建模技术。
历史跟踪有限
主要关注当前数据,因此能够跟踪数据历史的变化。
结论
本文介绍了用于数据存储的维度数据建模,并优化了数据库以提高性能。维度数据模型的元素包括事实、维度、属性、事实表和维度表。数据仓库模型中的维度类型包括一致维度、扩展维度、收缩维度、角色扮演维度、维度到维度表、垃圾维度、退化维度、可交换维度和步进维度。创建维度数据模型的步骤包括:识别业务流程,识别粒度、维度和事实,以及构建模式。维度建模的规则包括事实和维度、信息量以及代理键的使用。维度建模的优点包括:易于数据访问、查询性能增强、灵活性提高、数据质量提高以及易于理解。缺点包括:复杂性、集成度、可扩展性和历史记录跟踪能力有限。

