
使用布尔模型和向量空间模型进行文档检索
简介
机器学习中的文档检索是信息检索这一更大领域的一部分。在信息检索中,系统会尝试查找与搜索查询相关的文档,并按相关性或匹配度对其进行排序。
文档检索有多种方法,其中两种常用的方法如下:-
布尔模型
向量空间模型
让我们简要了解一下上述每种方法。
布尔模型
它是一个基于集合的检索模型。用户查询采用布尔形式。查询使用 AND、OR、NOT 等连接。文档可以可视化为关键字集合。根据查询结果,根据相关性检索文档。不支持部分匹配和排名。
示例(布尔查询)-
[[美国 & 法国] | [洪都拉斯 & 伦敦]] & 餐厅 &! 曼哈顿]
布尔模型的步骤和流程图
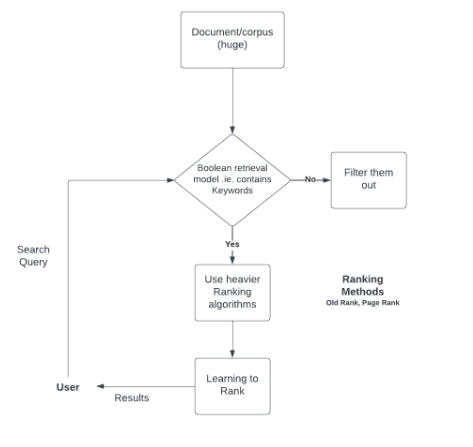
布尔模型是一种倒排索引搜索,用于查找文档是否相关。它不返回文档的排名。
术语矩阵将按如下方式创建。
term |
doc_1 |
doc_2 |
doc_3 |
|---|---|---|---|
taj |
1 |
0 |
0 |
mahal |
1 |
0 |
0 |
is |
1 |
1 |
0 |
a |
1 |
1 |
0 |
beautiful |
1 |
0 |
0 |
monument |
1 |
1 |
0 |
victoria |
0 |
1 |
0 |
memorial |
0 |
1 |
0 |
also |
0 |
1 |
0 |
i |
0 |
0 |
1 |
like |
0 |
0 |
1 |
to |
0 |
0 |
1 |
visit |
0 |
0 |
1 |
agra |
0 |
0 |
1 |
假设我们有一个类似"taj mahal agra"的查询
查询将创建为 −
taj [100] & mahal [100] & agra [001]
或 100 & 100 & 001 = 000,因此我们可以看到,使用 AND 操作后,所有文档都不相关。
然后,我们可以尝试添加其他运算符,例如 OR,或者使用其他关键字。
可以为该语料库创建倒排索引,如下所示 −
taj - set(1) |
mahal – set(1) |
is - set(1,2) |
a - set(1,2) |
beautiful - set(1) |
monument - set(1,2) |
victoria – set(2) |
memorial - set(2) |
also - set(2) |
i - set(3) |
like - set(3) |
to - set(3) |
visit - set(3) |
agra- set(3) |
向量空间模型
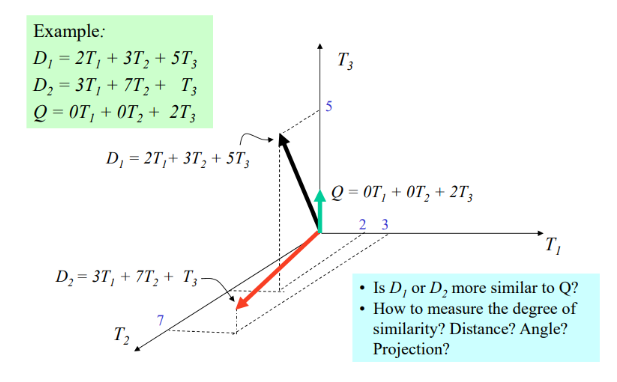
向量空间模型是一种统计检索模型。
在该模型中,文档被表示为一个词袋。
词袋允许单词出现多次
用户可以对搜索查询使用权重,例如 q = < 电子商务 0.5; 产品 0.8; 价格 0.2
它基于查询和文档之间的相似性。
输出是经过排序的文档。
它还可以包含单词的多次出现。
图形表示
示例
import pandas as pd
from contextlib import redirect_stdout
import math
trms = []
Keys = []
vector_dic = {}
dictionary_i = {}
random_list = []
t_frequency = {}
inv_doc_freq = {}
wt = {}
def documents_filter(docs, rw, cl):
   for i in range(rw):
      for j in range(cl):
         if(j == 0):
            Keys.append(docs.loc[i].iat[j])
         else:

            random_list.append(docs.loc[i].iat[j])

            if docs.loc[i].iat[j] not in trms:

                     trms.append(docs.loc[i].iat[j])

      listcopy = random_list.copy()
      dictionary_i.update({docs.loc[i].iat[0]: listcopy})
      random_list.clear()

def calc_weight(doccount, cls):
   for i in trms:
      if i not in t_frequency:
            t_frequency.update({i: 0})

      for key, val in dictionary_i.items():
         for k in val:
            if k in t_frequency:
               t_frequency[k] += 1
      inv_doc_freq = t_frequency.copy()
      for i in t_frequency:
         t_frequency[i] = t_frequency[i]/cls
      for i in inv_doc_freq:
         if inv_doc_freq[i] != doccount:
            inv_doc_freq[i] = math.log2(cls / inv_doc_freq[i])
         else:

            nv_doc_freq[i] = 0
      for i in inv_doc_freq:
         wt.update({i: inv_doc_freq[i]*t_frequency[i]})

      for i in dictionary_i:
         for j in dictionary_i[i]:
            random_list.append(wt[j])

      copy = random_list.copy()
      vector_dic.update({i: copy})
      random_list.clear()

def retrieve_wt_query(q):
   qFrequency = {}
   for i in trms:
      if i not in qFrequency:
         qFrequency.update({i: 0})
   for val in q:
      if val in qFrequency:
         qFrequency[val] += 1
   for i in qFrequency:
      qFrequency[i] = qFrequency[i] / len(q)

   return qFrequency

def compute_sim(query_Weight):
      num = 0
      deno1 = 0
      deno2 = 0
      sim= {}
      for doc in dictionary_i:
         for trms in dictionary_i[doc]:
            num += wt[trms] * query_Weight[trms]
            deno1 += wt[trms] * wt[trms]
            deno2 += query_Weight[trms] * query_Weight[trms]
         if deno1 != 0 and deno2 != 0:
            simi = num / (math.sqrt(deno1) * math.sqrt(deno2))
            sim.update({doc: simi})
            num = 0
            deno1 = 0
            deno2 = 0

      return (sim)

def pred(simi, doccount):

   with open('result.txt', 'w') as f:
      with redirect_stdout(f):
         ans = max(simi, key=simi.get)
         print(ans, "- most relevent document")
         print("documents rank")
         for i in range(doccount):
            ans = max(simi, key=lambda x: simi[x])
            print(ans, "ranking ", i+1)
            simi.pop(ans)

def main():
   docs = pd.read_csv(r'corpus_docs.csv')
   rw = len(docs)
   cls = len(docs.columns)
   documents_filter(docs, rw, cls)
   calc_weight(rw, cls)
   print("Input your query")
   q = input()
   q = q.split(' ')
   q_wt = retrieve_wt_query(q)
   sim = compute_sim(q_wt)
   pred(sim, rw)
main()
输出
Input your query
hockey
{'doc2': 0.4082482904638631}
doc2 - most relevent document
documents rank
doc2 ranking 1
结论
文档检索是当今所有搜索任务的核心。无论是搜索、数据库检索还是通用信息检索,我们都能找到布尔和向量空间等模型的应用。

