
早期数据库模型
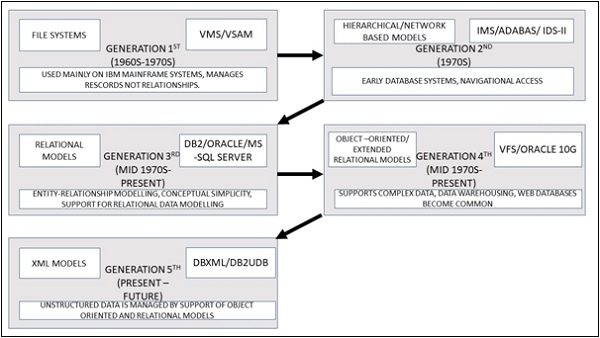
数据库模型决定了数据库的逻辑结构,并从根本上决定了数据的存储、组织和操作方式。在数据库设计出来之前,数据存储的唯一方式是文件存储,这增加了复杂性,因为程序员必须费尽心思提取数据,并且他们的程序必须执行复杂的解析和关联操作。
像 Perl 这样的各种语言,由于其强大的正则表达式,可以更轻松地处理文本。然而,从文件访问数据仍然是一项复杂的任务。由于没有访问数据的标准方法,系统更容易出错、开发速度更慢、维护更困难。存在数据冗余(数据不必要地重复)和数据完整性差(数据并非在所有位置都进行更改,导致提供错误或过时的数据)的问题。
为了解决这些问题,开发了数据库管理系统 (DBMS),它提供了一种标准且可靠的数据访问和更新方法。应用程序和数据之间有一个中间层,程序员可以专注于应用程序开发,而不必担心数据访问问题。
因此,我们可以将数据库模型定义为一种逻辑模型,它关注数据的表示方式。数据库设计人员关注更高、更概念化的层面,而不是担心数据的物理存储,从而缩小了应用程序开发所针对的实际问题与技术实现之间的差距。
数据模型用于组织数据元素并标准化数据元素之间的关系。由于数据元素用于记录现实生活中的人物、地点和事物,它们之间的事件代表着现实,例如,一栋建筑有很多窗户,或者一只狗有两只眼睛。模型有助于构建数据,同时它还定义了一组可对数据执行的操作。给定的 DBMS 可能提供多个模型。最佳结构取决于应用程序的数据自然组织方式以及相关应用程序的需求,其中一些因素是−
- 事务速率(速度),
- 可靠性,
- 可维护性,
- 可扩展性,
- 成本。
扁平(或表)模型是最传统和简单的数据模型,它由一个二维数据元素数组组成,其中给定列的所有成员表示相似的值,而一行的所有成员表示彼此之间的关系。例如,系统安全数据库的一部分列用于存储用户名和密码。每行包含与特定用户关联的特定密码。表的列包含一种类型,该类型定义字符数据、日期或时间信息、整数或浮点数。
现在我们可以说平面文件数据库是一种存储普通非结构化文件(也称为"平面文件")的数据库。该文件完全存储在计算机内存中,因此在计算机系统上访问数据结构及其操作变得容易。数据库操作完成后,文件将从计算机系统中移出并传输到主机的文件系统中。这种模式被称为"平面",因为它没有索引结构,并且记录之间通常没有结构关系。
这种平面模型最适合小型、简单的数据库。随着数据量的增长,内存访问变得困难,需要更复杂的数据库。手写姓名、联系电话、地址和城市列表是平面文件数据库。如果将相同的信息记录在电子表格中,则可以在线使用,从而提高搜索能力。还可以使用平面文件数据库模型传输数据。
示例数据库
以下示例说明了平面文件数据库的基本元素。它由一系列列和行组成,并组织成一个表。
列包括姓名(人名,第二列);团队(该人支持的运动队名称,第三列);以及数字唯一 ID(用于唯一标识记录,第一列)。
以下类型的数据表示对于平面文件数据库来说是相当标准的。 −
| ID | NAME | TEAM |
|---|---|---|
| 101 | Abhinav | Blues |
| 102 | Aditya | Blues |
| 103 | Anjali | Pink |
| 104 | Bhavna | Pink |
| 105 | Charu | Pink |
| 106 | Divy | Blues |
| 107 | Disha | Pink |
| 108 | Eashan | Blues |
| 109 | Gauri | Pink |

