
如何在 Pandas 中对多索引进行 groupby?
pythonserver side programmingprogramming更新于 2025/10/20 20:28:17
多索引数据框是具有多个索引的数据框。假设以下是我们存储在桌面上的 csv −
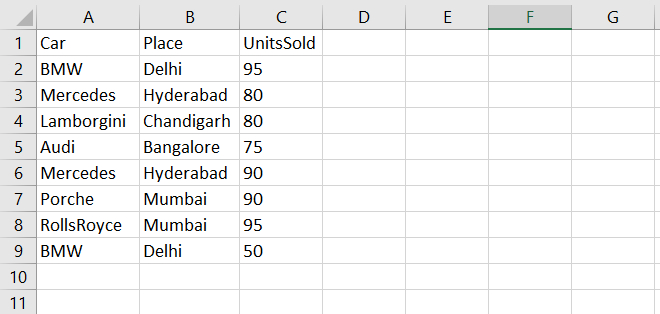
首先,导入 pandas 库并读取上述 CSV 文件 −
import pandas as pd

df = pd.read_csv("C:/Users/amit_/Desktop/sales.csv") print(df)
我们将形成‘Car‘和 ‘Place‘ 的 Dataframe 列作为索引 −
df = df.set_index([&39;Car&39;, &39;Place&39;])
DataFrame 现在是一个多索引 DataFrame,具有 ‘Car‘ 和 ‘Place‘列作为索引。
现在,让我们在多索引数据框上使用 groupby:
res = df.groupby(level=['Car'])['UnitsSold'].mean() print(res)
示例
以下是代码 −
import pandas as pd

df = pd.read_csv("C:/Users/amit_/Desktop/sales.csv")
print(df)

# 将 DataFrame 的 Car 和 Place 列设置为索引
df = df.set_index(['Car', 'Place'])

# 排序
df.sort_index()

# groupby on多索引数据帧
res = df.groupby(level=['Car'])['UnitsSold'].mean()
print(res)
输出
这将产生以下输出 −
          Car         Place       Sold
0         BMW         Delhi         95
1    Mercedes     Hyderabad         80
2  Lamborgini    Chandigarh         80
3        Audi     Bangalore         75
4    Mercedes     Hyderabad         90
5     Porsche        Mumbai         90
6  RollsRoyce        Mumbai         95
7         BMW         Delhi         50
Car
Audi       75.8
BMW        72.5
Lamborgini 80.0
Mercedes   85.0
Porsche    90.0
RollsRoyce 95.0
Name: UnitsSold, dtype: float64
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

