
如何将目录下的所有 excel 文件读取为 Pandas DataFrame?
pythonserver side programmingprogramming更新于 2025/11/16 23:40:17
要读取目录中的所有 excel 文件,请使用 Glob 模块和 read_excel() 方法。
假设以下是目录中的 excel 文件 −
Sales1.xlsx
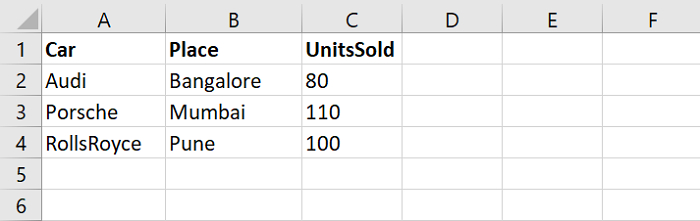
Sales2.xlsx
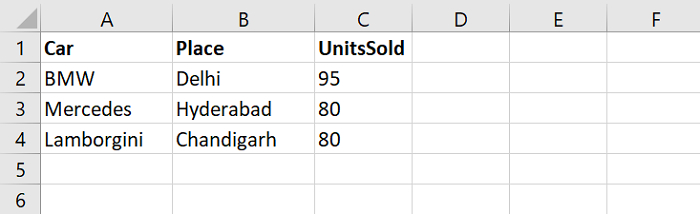
首先,设置所有 excel 文件所在的路径。获取 excel 文件并使用 glob − 读取它们
path = "C:\Users\amit_\Desktop\"

filenames = glob.glob(path + "\*.xlsx")
print('File names:', filenames)
接下来,使用 for 循环迭代并读取特定目录中的所有 excel 文件。我们还使用 read_excel()−
for file in filenames:
   print("Reading file = ",file)
   print(pd.read_excel(file))
示例
以下是完整代码 −
import pandas as pd
import glob

# 从目录桌面获取 excel 文件
path = "C:\Users\amit_\Desktop\"

# 读取所有扩展名为 .xlsx 的文件,即 excel
filenames = glob.glob(path + "\*.xlsx")
print('File names:', filenames)

# for 循环迭代所有 excel 文件
for file in filenames:
   # reading excel files
   print("Reading file = ",file)
   print(pd.read_excel(file))
输出
这将产生以下输出 −
File names:['C:\Users\amit_\Desktop\Sales1.xlsx','C:\Users\amit_\Desktop\Sales2.xlsx']

Reading file = C:\Users\amit_\Desktop\Sales1.xlsx
          Car      Place   UnitsSold
0        Audi  Bangalore          80
1     Porsche     Mumbai         110
2  RollsRoyce       Pune         100

Reading file = C:\Users\amit_\Desktop\Sales2.xlsx
          Car      Place   UnitsSold
0         BMW      Delhi         95
1    Mercedes  Hyderabad         80
2  Lamborgini Chandigarh         80
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

