
如何使用 Matplotlib 绘制 PySpark SQL 结果?
pythonserver side programmingprogramming更新于 2025/8/7 18:52:17
要使用 Matplotlib 绘制 PySpark SQL 结果,我们可以采取以下步骤−
- 设置图形大小并调整子图之间和周围的填充。
- 获取作为 Spark 功能主要入口点的实例。
- 获取与存储在 Hive 中的数据集成的 Spark SQL 变体的实例。
- 将记录列表作为元组。
- 分发本地 Python 集合以形成 RDD。
- 将列表记录映射为 DB 模式。
- 获取模式实例以将其输入到"my_table"。
- 将记录插入表。
- 读取 SQL 查询,检索记录。
- 将获取的记录转换为数据框。
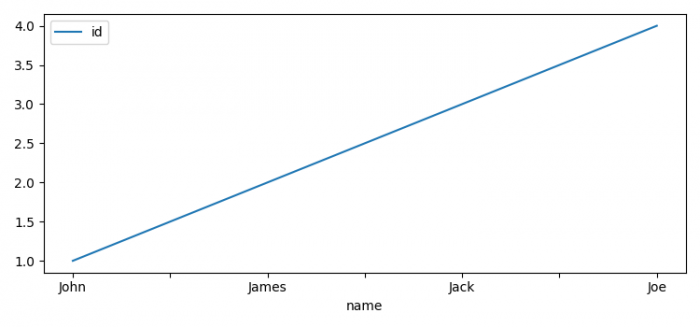
- 使用 name 属性设置索引并绘制它们。
- 要显示图形,请使用 show() 方法。
示例
from pyspark.sql import Row
from pyspark.sql import HiveContext
import pyspark
import matplotlib.pyplot as plt

plt.rcParams["figure.figsize"] = [7.50, 3.50]
plt.rcParams["figure.autolayout"] = True

sc = pyspark.SparkContext()
sqlContext = HiveContext(sc)

test_list = [(1, 'John'), (2, 'James'), (3, 'Jack'), (4, 'Joe')]
rdd = sc.parallelize(test_list)
people = rdd.map(lambda x: Row(id=int(x[0]), name=x[1]))
schemaPeople = sqlContext.createDataFrame(people)
sqlContext.registerDataFrameAsTable(schemaPeople, "my_table")

df = sqlContext.sql("Select * from my_table")
df = df.toPandas()
df.set_index('name').plot()

plt.show()
输出
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

