
使用 Google 的 Teachable Machine 进行图像分类
在本文中,您将了解机器学习、图像分类以及如何使用 Google 的 Teachable Machine 训练模型。
机器学习
机器学习是 AI(人工智能)的一个子集,用于开发模型和算法,使用这些模型和算法,我们可以让计算机学习并做出决策,而无需明确编程。这是一种教机器从给定数据中学习并随时间提高性能的有效方法。计算机可以学习任务并进行预测或使用数据找到任何模式,这些数据显示了我们下一步应该采取什么行动的情景。
图像分类
图像分类是一种机器学习过程,我们使用它为图像分配标签。这在计算机视觉领域非常流行。通过对图像进行分类,我们可以使用模型来识别对象、活动、图像和场景。图像分类用于各种任务,如人脸识别、物体检测。您可以从 kaggle 平台查看一些图像数据集。
Google 的 Teachable Machine
Google 的 Teachable Machine 为我们提供了一个基于 Web 的界面和工具,我们可以使用这些界面和工具训练机器学习模型以对图像进行分类。
我们使用这些工具来识别对象、图像、场景和声音分类。该平台为我们提供了训练模型并将其导出到本地系统的功能,或者我们也可以免费在线发布它以使用基于 URL 的服务器架构。
使用 Google Teachable Machine 创建图像分类项目的步骤
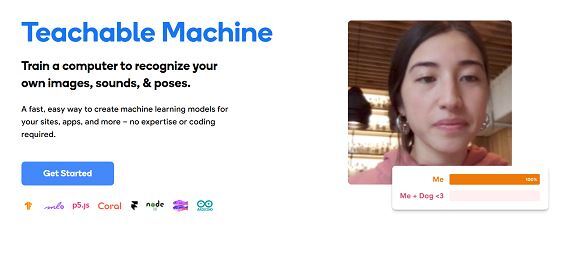
要使用 Teachable Machine,您首先需要创建一个项目。要创建项目,我们将访问 Google 的 Teachable Machine 网站并单击"开始"。
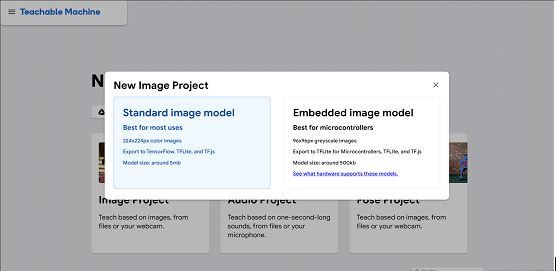
完成此步骤后,将打开新窗口,其中将显示三种项目类型:图像项目、音频项目和姿势项目。因此,我们要创建图像分类模型,因此我们将选择图像项目选项。它会询问我们是否需要标准图像模型或嵌入式图像模型,因此我们将选择标准图像模型。这里,标准图像模型将创建 Tensorflow 和移动机器学习模型,而嵌入式模型将创建微控制器等嵌入式系统的模型。
下一步,我们将创建与分类相关的不同类。我们必须为该类添加名称并提供与该类相关的图像。举个例子:我们想要创建猫类,所以我们将提供猫的图像,同样,对于狗类,我们将提供与狗相关的图像。
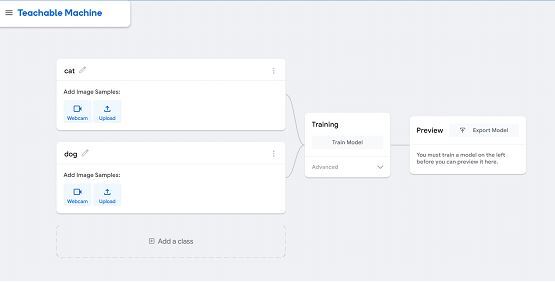
在这里,我们创建了猫和狗类,您还可以根据需要添加更多类。现在我们将为该模型提供可训练的图像。对于这个模型,我通过浏览网站保存了一些猫和狗的图像,并将其存储在本地计算机的不同文件夹中。
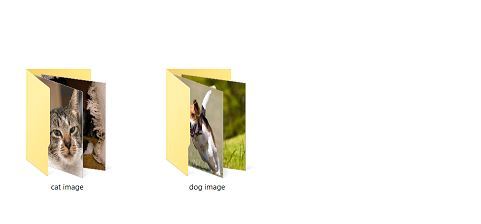
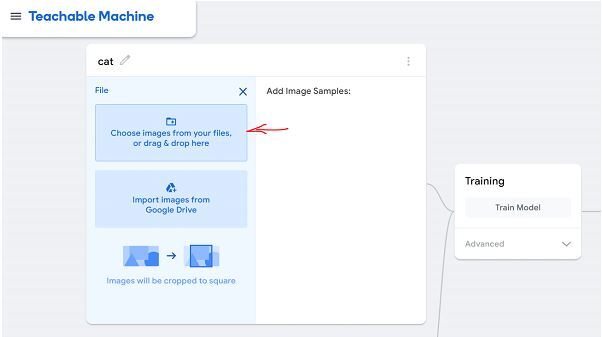
现在我们将使用上传按钮并使用从文件中选择图像的选项,然后上传猫和狗的可用图像,我们将选择所有图像文件并上传该特定类别的所有图像。就像猫一样,我们将仅上传与猫相关的图像,以便正确标记图像。
从下图中您可以看到,我们通过从文件中选择图像上传了两个类中的图像。该模型将标记类名中给出的图像。
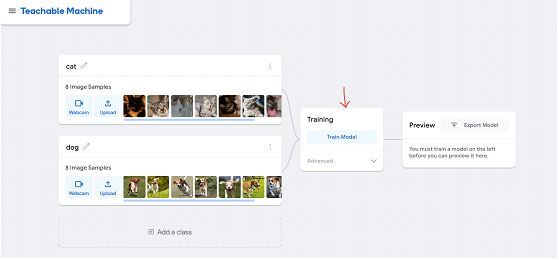
现在我们将使用训练模型按钮开始根据提供的图像训练模型,Teachable Machine 将自动生成模型。我们还可以单击并自定义训练要求,当我们从训练选项中选择高级下拉菜单时,它会要求自定义 Epochs、Batch Size、学习率。
Epochs - 一个 epoch 意味着训练数据集中的每个样本至少被输入一次。例如,如果 epochs 为 20,则模型将通过整个数据集进行 20 次训练。因此,我们可以说,更大的 epochs 将更好地训练模型以预测图像。
Batch Size - 批处理大小是一组样本图像,用于一次迭代/遍历中的训练。例如,我们有 50 张图像,批处理大小为 10,那么它将被分成 50/10=5 次迭代。意味着在一次迭代中它将使用 10 张图像来训练模型。一旦所有 5 个批次都完成,它将被视为 1 个时期完成。
学习率 - 这是一个超参数,用于控制神经网络的权重。
之后,我们将点击训练模型选项,开始训练模型需要一些时间。
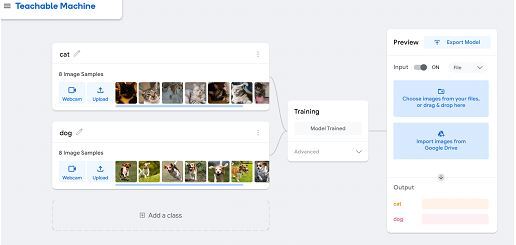
现在它将提供通过将模型导出到我们的本地文件中来预览模型的选项。要检查模型的运行情况,我们可以使用从文件中选择的选项或使用相机选项。因此,我选择文件选项并选择一张狗图像,它将预测输出为狗。
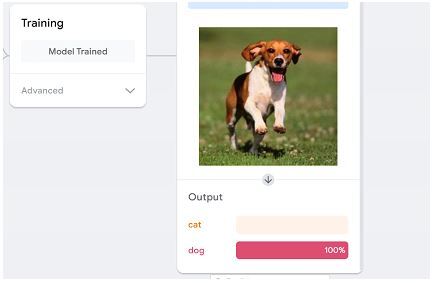
从上图中,您可以看到我们使用从文件选项中选择来选择狗图像,它将输出预测为狗,置信度为 100%。
注意 - 如果我们对模型的性能不满意,那么我们可以继续我们的模型训练,直到它预测得更好。训练结束后,我们可以下载模型或使用链接
以下是使用 Teachable Machine 的一些技巧 -
使用高质量图像。我们应该为模型提供高质量的图像,图像质量越好,模型的性能就越好。
标记图像。我们应该仔细地用正确的类别标记我们的数据图像。
对我们的模型进行更长时间的训练。正如您所了解的,最大时期数越多,我们的模型性能就越好。
经常测试我们的模型。我们应该对我们的模型进行测试,以了解它的性能,我们也可以根据需要进行调整。
结论
所以,我们了解了机器学习,它使我们的计算机能够学习,图像分类使我们可以使用它训练模型来识别对象,我们学习使用 Google Teachable Machine。这个平台使构建自定义图像分类的过程变得非常简单。没有广泛编码知识的人也可以制作他们的模型。我们可以标记图像,训练模型并在 Python 应用程序中使用它来制作非常有效的图像识别系统。我们通过遵循它们看到了所有过程。我们创建了我们的模型,并使用一个示例检查了我们的模型准确性。您还可以向该项目中添加更多类别,并提供与该特定类别相关的图像,这些图像将用作附加标签。使用 Google Teachable Machine,我们还可以创建其他模型,例如可用于构建语音识别应用程序的基于音频的模型,我们还可以创建可用于识别不同身体姿势(如瑜伽或身体运动)的姿势基础模型。因此,您学会了如何创建自己的模型,而无需繁琐的编码过程。
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

