
在 Python 编程中使用 lxml 实现网页抓取
pythonserver side programmingprogramming更新于 2025/11/16 17:48:17
在本文中,我们将学习使用 Python 中提供的 lxml 模块的网页抓取技术。
什么是网页抓取?
网页抓取用于借助爬虫/扫描仪从网站获取数据。网页抓取可以方便地从不提供 API 功能的网页中提取数据。在 Python 中,可以借助 Beautiful Soup、Scrappy 和 lxml 等各种模块进行网页抓取。
在这里,我们将讨论使用 lxml 模块的网页抓取。
为此,我们首先需要安装 lxml。
在终端或命令提示符中输入 −
>>> pip install lxml
这里使用 xpath 来访问数据。
在本文中,我们将从名为 steam 的网站中提取包含有关不同游戏的信息的数据。
https://store.steampowered.com/genre/Free%20to%20Play/
在页面上,我们将尝试从热门新版本部分中提取信息。在这里,我们将提取名称、价格、相关标签 &目标平台。
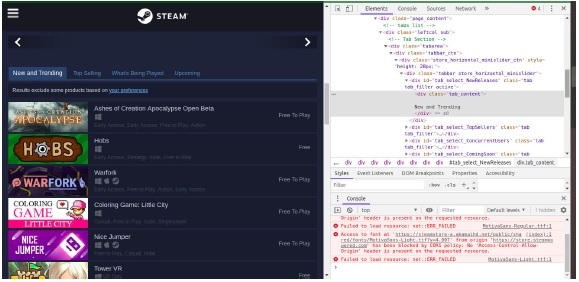
在页面上,使用 chrome 中的检查元素功能查看新版本选项卡的 Html 代码。在这里,我们将了解哪个标签存储了所需的信息。
在此网站中;每个列表元素都封装在一个 div 标签 id=tab_content 中,该标签进一步封装在
div 标签 id=tab_select_newreleases
现在让我们看看实现
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

