
使用 Python 中的 Scikit-Learn 对手写数字数据进行 K-Means 聚类
简介
聚类是基于共同特征对相似数据进行分组,是无监督机器学习中的一种重要技术。K-Means 聚类是一种流行的聚类算法。使用迭代 K-Means 技术将数据划分为 K 个聚类,其中 K 是预定数字。该过程最小化了聚类质心与数据点之间的平方距离之和。在本文中,我们将介绍如何使用 Python Scikit-Learn 包对手写数字数据进行 K-Means 聚类。
定义
一种简单而有效的无监督学习方法,称为 K-Means 聚类,旨在将数据集划分为 K 个唯一的、不重叠的聚类。每个数据点都会被赋予其最接近的质心,即分配给该簇的所有点的算术平均值,这就是它的运作方式。为了减少数据点与其对应质心之间的平方距离之和,该算法会迭代地改变质心。重复该操作,直至收敛或达到预定的迭代次数。
语法
from sklearn.cluster import KMeans

# 加载数字数据集
from sklearn.datasets import load_digits
digits = load_digits()

# 创建 K-Means 聚类模型
kmeans = KMeans(n_clusters=K)

# 将模型拟合到数据
kmeans.fit(digits.data)

# 预测数据的聚类标签
labels = kmeans.predict(digits.data)
引入所需的库。从 sklearn.cluster 包中,我们导入 KMeans 类。我们还通过 sklearn.datasets 包中的 load_digits 方法导入手写数字数据集。
使用 load_digits 函数加载手写数字数据集。此集合包括手写数字的图片,每个数字都是 8x8 像素图像。
初始化 KMeans 类实例以生成 K-Means 聚类模型。我们希望生成的聚类数量 (K) 由 n_clusters 参数指定。根据数据集和问题,我们可以选择任何 K 值。
调用 fit 方法,传递数据集,将 K-Means 模型拟合到数据。在此步骤中确定聚类质心,并将每个数据点映射到最近的质心。
利用预测方法,预测数据点聚类的标签。每条数据都被赋予一个与其所属聚类相对应的标签。
算法
步骤 1 - 应随机或使用指定的初始化方法初始化 K 个聚类质心。
步骤 2 - 根据欧几里得距离,将每个数据点放置在其最近的质心旁边。
步骤 3 - 计算分配给每个聚类的所有数据点的平均值以更新质心。
步骤 4 - 直到收敛或达到分配的迭代次数,根据需要重复步骤 2 和 3。
步骤 5 - 我们得到最终的聚类作业。
方法
方法 1 - 聚类手写数字数据
方法 2 - 评估聚类性能
方法 1:聚类手写数字数据
示例
# 导入必要的库
from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
import matplotlib.pyplot as plt

# 加载数字数据集
digits = load_digits()

# 创建 K-Means 聚类模型
kmeans = KMeans(n_clusters=10)

# 将模型拟合到数据
kmeans.fit(digits.data)

# 预测数据的聚类标签
labels = kmeans.predict(digits.data)

# 可视化聚类质心
fig, ax = plt.subplots(2, 5, figsize=(8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centers):
    axi.set(xticks=[], yticks=[])
    axi.imshow(center, interpolation='nearest', cmap=plt.cm.binary)

# 显示图表
plt.show()
输出
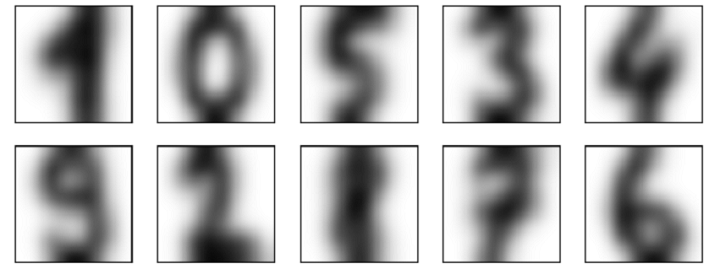
由于数据集中有 10 个不同的数字 (0-9),我们接下来通过使用 n_clusters=10 初始化 KMeans 类的实例来建立 K-Means 聚类模型。
然后,使用拟合方法(确定聚类质心并将每个数据点与其最近的质心相对应)将模型拟合到数据。
我们将聚类中心调整为 8x8 图像并绘制它们使用 matplotlib 来查看聚类质心。结果图中显示了每个聚类的代表性照片。
这里我们使用 plt.show() 在程序结束时显示图表。
代码的输出是一个以 2x5 网格组织 10 个子图的图表。对于给定的数字,每个子图对应一个聚类质心。由于初始化都是随机的,因此给定程序的输出每次执行时可能会有所不同。灰度质心图像描绘了每个聚类的平均数字图像。由于聚类质心的初始位置是随机选择的,因此聚类结果可能会略有不同。因此,生成的聚类质心及其在图中排列的方式可能会在不同运行之间发生变化。
方法 2:评估聚类性能
示例
# 导入必要的库
# Import the necessary libraries
from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
from sklearn.metrics import silhouette_score

# 加载数字数据集
digits = load_digits()

# 创建 K-Means 聚类模型
kmeans = KMeans(n_clusters=10)

# 将模型拟合到数据
kmeans.fit(digits.data)

# 预测数据的聚类标签
labels = kmeans.predict(digits.data)

# 评估聚类性能
score = Silhouette_score(digits.data, labels)
print("Silhouette Score:", score)
输出
Silhouette Score: 0.18185624794421412
之后,我们将 n_clusters 设置为 10,并将 K-Means 聚类模型拟合到数据中。
然后将数据点的预测聚类标签添加到标签变量中。
我们利用 sklearn.metrics 中的 Silhouette_score 函数来评估聚类的性能。此统计数据的值评估数据点的聚类紧密程度,范围从 -1 到 1。值越大表示聚类性能越好。
为了评估聚类结果的质量,我们在最后一步发布了 Silhouette 分数。
输出显示在冒号后,将显示实际分数值。Silhouette 量表上的分数越高(范围从 -1 到 1),表示分组结果越好。它评估与其他簇相比,数据集中的每个样本与其分配的簇的匹配程度。得分越接近 1,簇就越突出,分离度就越好。运行代码时,将使用 K-Means 算法对数字数据集的聚类来获取轮廓得分。输出将是分数,它将打印到控制台。
结论
K-Means 聚类是一种灵活的方法,可用于查找隐藏的模式并将相关数据点组合成各种形式的数据。通过理解和使用 K-Means 聚类,您可以从数据中提取重要见解并做出明智的判断。
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

