
在 Scikit-learn 中构建学习模型:一个 Python 机器学习库
pythonserver side programmingprogramming更新于 2025/10/24 11:24:17
在本文中,我们将了解在 Scikit-learn 中构建学习模型:一个 Python 机器学习库。
这是一个免费的机器学习库。它支持各种算法,如随机森林、向量机和 k-最近邻,并直接使用 numpy 和 scipy 实现。
导入数据集
import pandas
Url = < 在此处指定您的 URL>
data=pandas.rad_csv(url)
数据探索和清理
我们可以使用 head 方法根据需要指定/过滤记录。
data.head()
data.head(n=4) # 限制记录为 4
我们还可以实现数据集的最后几条记录
data.tail()
data.tail(n=4) # 限制记录为 4
现在到了数据可视化阶段
为此,我们使用 Seaborn 模块和 matplotlib 来可视化我们的数据
import seaborn as s
import matplotlib.pyplot as plt
sns.set(style="whitegrid", color_codes=True)
# 创建计数图
sns.countplot('Route To Market',data=sales_data,hue = 'Opportunity Result')
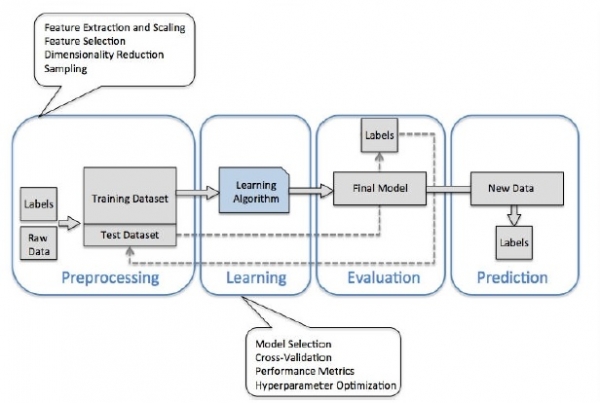
预处理数据
from sklearn import preprocessing
le = preprocessing.LabelEncoder()
# 将列转换为数值
encoded_value = le.fit_transform(list of column names)
print(encoded_value)
最后,我们通过训练数据集进入模型构建阶段。
结论
在本文中,我们了解了 scikit-learn(Python 中可用的库)中的模型构建。
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

