
使用 Python 中的机器学习进行医疗保险价格预测
与许多其他行业一样,预测分析在金融和保险行业也非常有用。使用这种机器学习技术,我们可以找到有关任何保险单的有用信息,从而节省大量资金。在这里,我们将使用这种预测分析方法处理医疗保险数据集。
这里的问题陈述是,我们有一个具有某些属性的人的数据集。使用 Python 中的机器学习,我们必须从这个数据集中找出相关信息,还必须预测一个人必须支付的保险价格。
算法
步骤 1 - 导入 numpy、pandas、matplotlib、seaborn 和 sklearn 等库,并将数据集加载为 pandas 数据框。
步骤 2 − 为了清理数据,首先检查是否有空值。如果发现空值,则查找各个特征之间的关系并估算空值。如果没有,那么我们就可以开始了。
步骤 3 − 现在执行 EDA,即检查各个独立变量之间的关系。
步骤 4 − 查找异常值并进行调整。
步骤 5− 绘制热图以找出高度相关的变量。
步骤 6 − 将数据集拆分为测试集和训练集,并使用 StandardScaler 对数据进行规范化。
步骤 7 − 现在在这些数据上训练一些机器学习模型,并使用 mape 检查哪个模型最有效最好。
示例
在此示例中,我们将采用您可以在此处找到的医疗保险数据集,然后,我们将执行预测一个人必须为某种医疗保险支付的保险价格所需的各种步骤。
#导入所需的库
import numpy as np
import pandas as pd
import seaborn as sb
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.metrics import mean_absolute_percentage_error as mape
from sklearn.linear_model import LinearRegression, Lasso, Ridge
from xgboost import XGBRegressor
from sklearn.ensemble import RandomForestRegressor, AdaBoostRegressor

import warnings
warnings.filterwarnings('ignore')

#加载并打印数据集
df = pd.read_csv('insurance_dataset.csv')
df.head()
df.shape
df.info()
df.describe()

#检查空值
df.isnull().sum()

#查看独立特征之间的关系
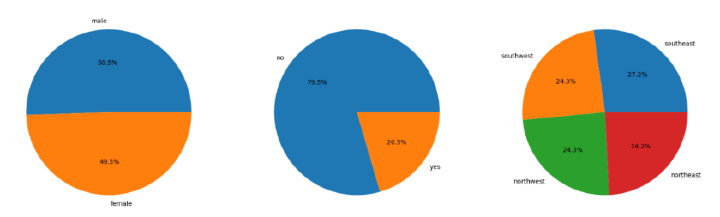
#饼图
features = ['sex', 'smoker', 'region']

plt.subplots(figsize=(20, 10))
for i, col in enumerate(features):
    plt.subplot(1, 3, i + 1)

    x = df[col].value_counts()
    plt.pie(x.values, labels=x.index, autopct='%1.1f%%')

plt.show()

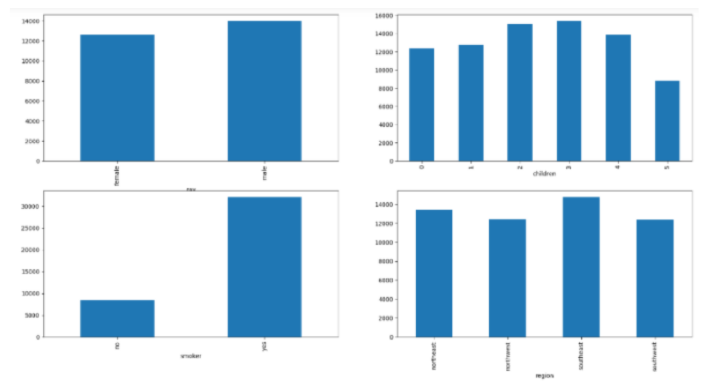
#条形图
features = ['sex', 'children', 'smoker', 'region']

plt.subplots(figsize=(20, 10))
for i, col in enumerate(features):
    plt.subplot(2, 2, i + 1)
    df.groupby(col).mean()['charges'].plot.bar()
plt.show()

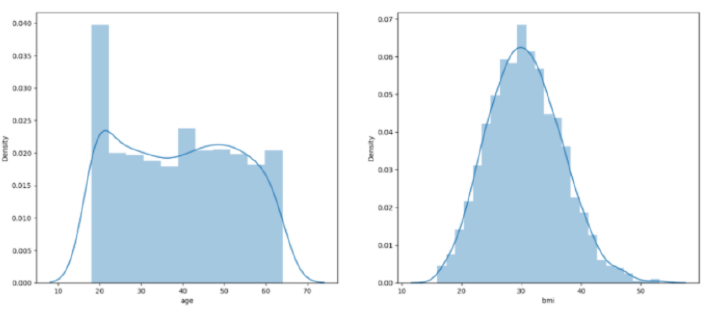
#图
features = ['age', 'bmi']

plt.subplots(figsize=(17, 7))
for i, col in enumerate(features):
    plt.subplot(1, 2, i + 1)
    sb.distplot(df[col])
plt.show()

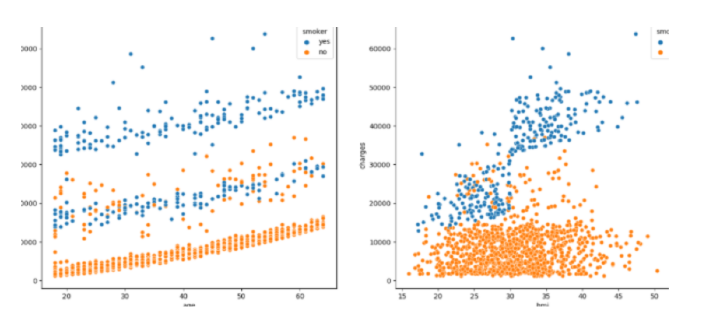
#散点图
features = ['age', 'bmi']

plt.subplots(figsize=(17, 7))
for i, col in enumerate(features):
    plt.subplot(1, 2, i + 1)
    sb.scatterplot(data=df, x=col, y='charges', hue='smoker')
plt.show()

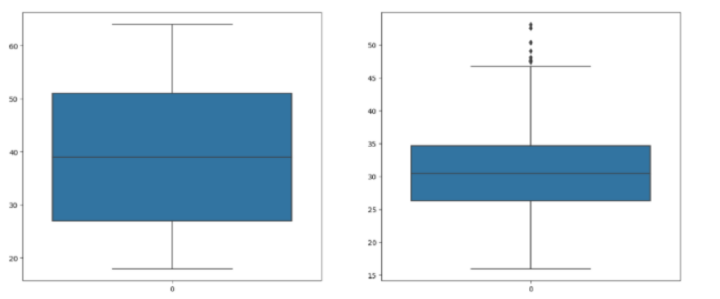
#检查异常值
features = ['age', 'bmi']

plt.subplots(figsize=(17, 7))
for i, col in enumerate(features):
    plt.subplot(1, 2, i + 1)
    sb.boxplot(df[col])
plt.show()

#调整异常值
df.shape, df[df['bmi']<45].shape
df = df[df['bmi']<50]
for col in df.columns:
    if df[col].dtype == object:
        le = LabelEncoder()
        df[col] = le.fit_transform(df[col])

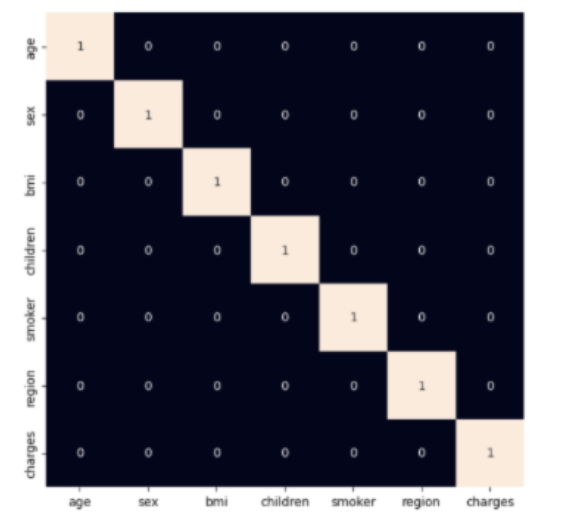
#使用热图查看高度相关的变量
plt.figure(figsize=(7, 7))
sb.heatmap(df.corr() > 0.8, annot=True, cbar=False)
plt.show()

#将数据集拆分为训练集和测试集
features = df.drop(['charges'], axis=1)
target = df['charges']

X_train, X_val,\
    Y_train, Y_val = train_test_split(features, target, test_size=0.1, random_state=22)

X_train.shape, X_val.shape

#拟合数据
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_val = scaler.transform(X_val)

#查找各种模型的性能
models = [LinearRegression(), XGBRegressor(),
          RandomForestRegressor(), AdaBoostRegressor(),
          Lasso(), Ridge()]

for i in range(6):
    models[i].fit(X_train, Y_train)

    print(f'{models[i]} : ')
    pred_train = models[i].predict(X_train)
    print('Training Error : ', mape(Y_train, pred_train))

    pred_val = models[i].predict(X_val)
    print('Validation Error : ', mape(Y_val, pred_val))
    print()
导入所需的库后,数据集将存储到 Python 数据框中。然后,代码检查数据集中的空值,并相应地绘制饼图和条形图,以可视化数据集中性别、地区和吸烟者列的分布和比例。
然后,显示直方图和散点图,以可视化年龄和体重指数与费用变量的分布和关系。检查年龄和体重指数列,并通过过滤掉极值进行修改。之后,将性别、吸烟者和地区列中的值转换为数字形式,并创建热图以可视化数据集中各列之间的关系。
然后将数据集分为训练集和验证集。根据训练集和验证集上的平均绝对百分比误差训练和评估各种回归模型。
输出
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1338 entries, 0 to 1337
Data columns (total 7 columns):
 #   Column    Non-Null Count  Dtype
---  ------    --------------  -----
 0   age       1338 non-null   int64
 1   sex       1338 non-null   object
 2   bmi       1338 non-null   float64
 3   children  1338 non-null   int64
 4   smoker    1338 non-null   object
 5   region    1338 non-null   object
 6   charges   1338 non-null   float64
dtypes: float64(2), int64(2), object(3)
memory usage: 73.3+ KB
LinearRegression() −
Training Error :  0.42160312973300035
Validation Error :  0.36819643775368394
XGBRegressor() −
Training Error :  0.07414118093426757
Validation Error :  0.43487251393507226
RandomForestRegressor() −
Training Error :  0.11931475932482996
Validation Error :  0.33574049059141486
AdaBoostRegressor() −
Training Error :  0.6166709629183661
Validation Error :  0.5758503954769271
Lasso() −
Training Error :  0.42160217445355996
Validation Error :  0.36821456297631355
Ridge() −
Training Error :  0.42182509871430085
Validation Error :  0.3685041955294438
您可以看到 XGBRegressor 给出的 MAPE(平均绝对百分比误差)值最小。这意味着该模型预测的价格非常接近实际价格,因此可以被视为该项目的最佳模型。
结论
要进行医疗保险价格预测,您还可以使用任何其他模型,如 K 最近邻 (KNN)、支持向量机 (SVM)、随机森林 (RF) 和朴素贝叶斯等。此外,这里的数据大多经过预处理。但是,您可以根据需要自行预处理。此外,也可以以相同的方式对具有其他几个特征的数据集进行类似的预测。
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

