
使用 Python 中的 TensorFlow 检测皮肤癌
任何疾病(尤其是癌症)的早期发现对于治疗阶段都至关重要。在这方面做出的一项努力是使用机器学习算法在 Tensorflow 等机器学习框架的帮助下检测和诊断皮肤癌。
传统的癌症检测方法非常耗时,需要专业的皮肤科医生。然而,在 TensorFlow 的帮助下,这个过程不仅可以快速进行,而且更准确、更高效。此外,无法及时联系医生和皮肤科医生的人也可以使用它。
算法
步骤 1 - 导入 numpy、pandas、matplotlib 和 seaborn 等库,并加载图像数据集并将其存储为列表。
步骤 2 − 将此图像列表加载为 pandas 数据框,并为列表中的每个图像提取两个标签。
步骤 3 − 为简单起见,将标签转换为符号 0 和 1,并借助饼图比较每个标签下的图像数量。
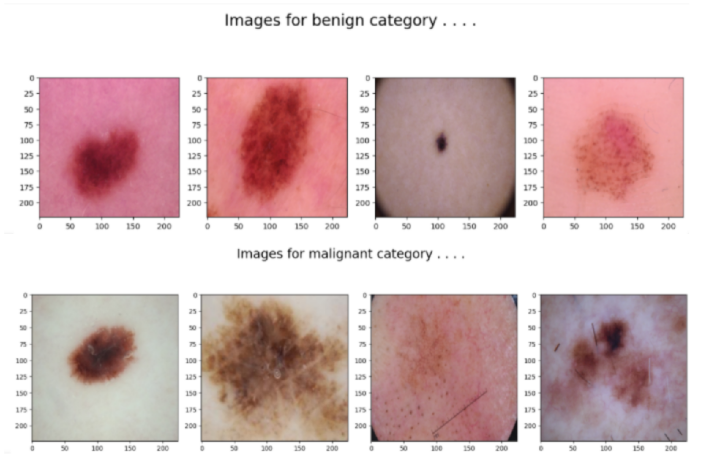
步骤 4 − 如果没有不平衡,则为每个标签打印一些图像。
步骤 5 − 将数据集拆分为训练集和测试集。
步骤 6 − 创建用于图像输入的管道。
步骤7 − 使用 EfficientNet 架构创建并编译模型。
步骤 8 − 对模型进行至少 5 个 epoch 的训练。
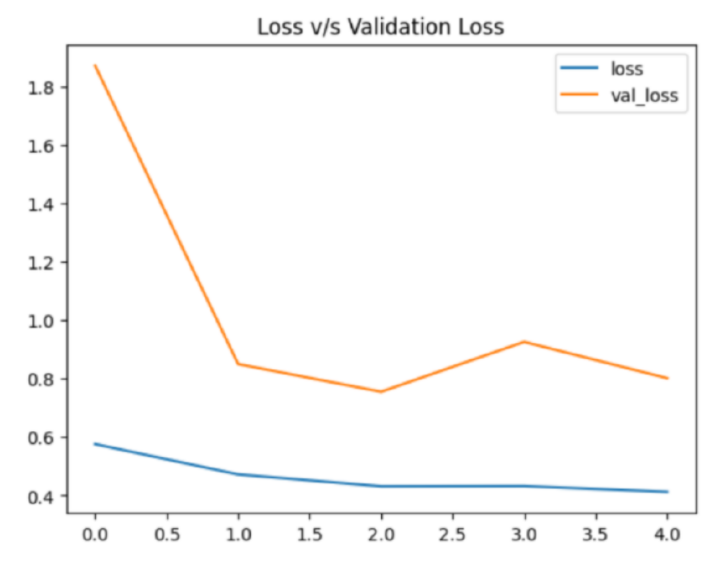
步骤 9 − 可视化训练损失和验证损失之间的差异。
示例
在此示例中,我们将采用包含两种图像的皮肤癌数据集,您可以在此处找到。然后,我们将在 TensorFlow 的帮助下开发一个模型,以在无需大量训练的情况下获得所需的结果。为此,我们还将利用 EfficientNet 架构来获得预训练的权重。
#导入所需的库
import numpy as np
import pandas as pd
import seaborn as sb
import matplotlib.pyplot as plt

from glob import glob
from PIL import Image
from sklearn.model_selection import train_test_split

import tensorflow as tf
from tensorflow import keras
from keras import layers
from functools import partial

AUTO = tf.data.experimental.AUTOTUNE
import warnings
warnings.filterwarnings('ignore')

#加载数据集
images = glob('train/*/*.jpg')
len(images)

#创建数据集并提取标签
images = [path.replace('', '/') for path in images]
df = pd.DataFrame({'filepath': images})
df['label'] = df['filepath'].str.split('/', expand=True)[1]
print(df.head())

df['label_bin'] = np.where(df['label'].values == 'malignant', 1, 0)
df.head()

#检查两种文件类型在数量上是否相同
x = df['label'].value_counts()
plt.pie(x.values,
    labels=x.index,
    autopct='%1.1f%%')
plt.show()

#打印图像两大类别
for cat in df['label'].unique():
    temp = df[df['label'] == cat]

    index_list = temp.index
    fig, ax = plt.subplots(1, 4, figsize=(15, 5))
    fig.suptitle(f'Images for {cat} category . . . .', fontsize=20)
    for i in range(4):
        index = np.random.randint(0, len(index_list))
        index = index_list[index]
        data = df.iloc[index]

        image_path = data[0]

        img = np.array(Image.open(image_path))
        ax[i].imshow(img)
plt.tight_layout()
plt.show()

#将数据集分为训练和测试
features = df['filepath']
target = df['label_bin']

X_train, X_val,\
    Y_train, Y_val = train_test_split(features, target,
                                      test_size=0.15,
                                      random_state=10)

X_train.shape, X_val.shape

def decode_image(filepath, label=None):

    img = tf.io.read_file(filepath)
    img = tf.image.decode_jpeg(img)
    img = tf.image.resize(img, [224, 224])
    img = tf.cast(img, tf.float32) / 255.0

    if label == None:
        return img

    return img, label

#创建图像输入管道
train_ds = (
    tf.data.Dataset
    .from_tensor_slices((X_train, Y_train))
    .map(decode_image, num_parallel_calls=AUTO)

    .batch(32)
    .prefetch(AUTO)
)

val_ds = (
    tf.data.Dataset
    .from_tensor_slices((X_val, Y_val))
    .map(decode_image, num_parallel_calls=AUTO)
    .batch(32)
    .prefetch(AUTO)
)

#使用 Keras API 构建模型架构
from tensorflow.keras.applications.efficientnet import EfficientNetB7

pre_trained_model = EfficientNetB7(
    input_shape=(224, 224, 3),
    weights='imagenet',
    include_top=False
)

for layer in pre_trained_model.layers:
    layer.trainable = False

from tensorflow.keras import Model

inputs = layers.Input(shape=(224, 224, 3))
x = layers.Flatten()(inputs)

x = layers.Dense(256, activation='relu')(x)
x = layers.BatchNormalization()(x)
x = layers.Dense(256, activation='relu')(x)
x = layers.Dropout(0.3)(x)
x = layers.BatchNormalization()(x)
outputs = layers.Dense(1, activation='sigmoid')(x)

model = Model(inputs, outputs)
model.compile(
    loss=tf.keras.losses.BinaryCrossentropy(from_logits=True),
    optimizer='adam',
    metrics=['AUC']
)

#训练模型 5 个周期
history = model.fit(train_ds,
                    validation_data=val_ds,
                    epochs=5,
                    verbose=1)

#检查损失
hist_df = pd.DataFrame(history.history)
hist_df.head()

#绘制线图
hist_df['loss'].plot()
hist_df['val_loss'].plot()
plt.title('Loss v/s Validation Loss')
plt.legend()
plt.show()
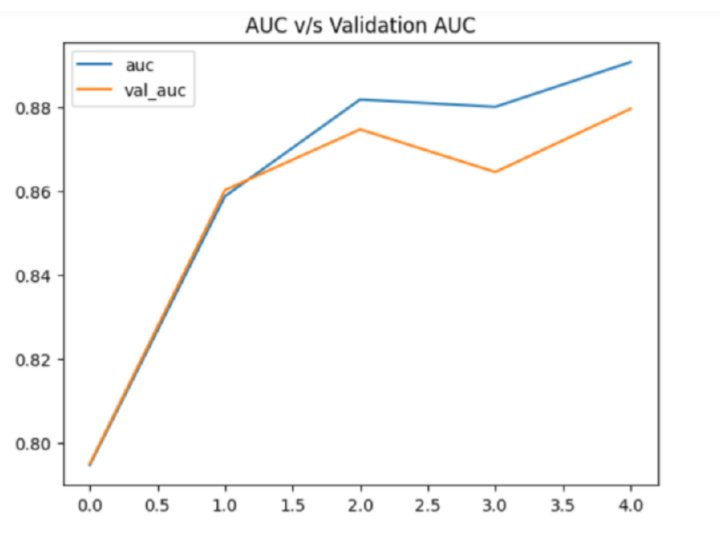
hist_df['auc'].plot()
hist_df['val_auc'].plot()
plt.title('AUC v/s Validation AUC')
plt.legend()
plt.show()
我们首先加载存储在本地系统中的图像,然后创建一个数据框来存储所有文件路径和加载的标签。存储的标签将转换为二进制格式,这样恶性表示 1,其他标签表示 0。
然后,代码的后半部分绘制了一个饼图,该饼图可视化了标签类别的分布并计算了每个类别的出现次数。
然后,我们从每个类别中随机选择 4 张图像,并使用 Matplotlib 将它们打印在 1x4 网格中。decode_image() 函数读取图像文件,对其进行解码并调整图像大小。然后使用 fit() 方法训练模型并执行训练。然后使用 fit() 方法返回的历史记录对象来提取训练和验证损失。然后将这些值存储在数据框中。
使用 Python 中的 Matplotlib 库绘制损失和验证损失值
输出
               filepath   label
0   train/benign/100.jpg  benign
1  train/benign/1000.jpg  benign
2  train/benign/1001.jpg  benign
3  train/benign/1002.jpg  benign
4  train/benign/1004.jpg  benign
周期 1/5
71/71 [==============================] - 28s 356ms/step - loss: 0.5760 - auc: 0.7948 - val_loss: 1.8715 - val_auc: 0.7951
周期 2/5
71/71 [==============================] - 25s 348ms/step - loss: 0.4722 - auc: 0.8587 - val_loss: 0.8500 - val_auc: 0.8602
周期 3/5
71/71 [==============================] - 24s 336ms/step - loss: 0.4316 - auc: 0.8818 - val_loss: 0.7553 - val_auc: 0.8746
周期 4/5
71/71 [==============================] - 24s 331ms/step - loss: 0.4324 - auc: 0.8800 - val_loss: 0.9261 - val_auc: 0.8645
周期 5/5
71/71 [==============================] - 24s 344ms/step - loss: 0.4126 - auc: 0.8907 - val_loss: 0.8017 - val_auc: 0.8795
结论
虽然 TensorFlow 在皮肤癌检测模型中表现足够好,但它也有自己的缺点,例如使用高计算能力或使用大量内存。因此,尝试其他框架(如 PyTorch、Keras 和 MXNet 等)也不失为一个好主意,以便在使用机器学习进行皮肤癌检测领域探索更多可能性。
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

