
Python 中的统计模拟
统计模拟是利用基于计算机的方法从概率分布中生成随机样本的任务,以便我们可以对表现出随机行为的复杂系统进行建模和分析。在本文中,我们将了解如何利用 Python 中的这个强大工具进行预测、生成见解以及评估统计算法的性能。
统计模拟有多种类型,如下所示:
蒙特卡洛模拟 - 从概率分布中生成随机样本,以估计函数的预期值。
Bootstrap - 重采样技术,通常用于估计估计量的采样分布。
马尔可夫链蒙特卡洛 (MCMC) - 用于估计复杂概率分布参数的算法类。
随机过程模拟 - 随时间推移的随机行为模拟。股票价格或天气模式预测就是一些例子。
统计模拟广泛应用于金融、工程、物理、生物和社会科学等众多领域,用于对复杂系统进行建模和分析、做出预测和产生见解。使用基于计算机的方法可以高效准确地模拟大量场景,这些场景可用于量化不确定性、估计风险和做出数据驱动的决策。
蒙特卡罗模拟
蒙特卡罗模拟是一种统计模拟,涉及从概率分布中生成随机样本,以估计函数的预期值或对表现出随机行为的复杂系统进行建模和分析。"蒙特卡罗"这个名字源于位于摩纳哥的蒙特卡罗赌场,随机性是赌博游戏中的关键因素,准确地说是赌博游戏。
蒙特卡罗模拟的准确性取决于生成的随机样本数量以及所分析模型或系统的质量。有了足够的样本和良好的模型,蒙特卡罗模拟可以提供有价值的见解并帮助决策者做出明智的选择。
示例
import numpy as np

# 定义要评估的函数
def function(x):
   return x**2

# 从 0 到 1 之间的均匀分布中生成随机样本
samples = np.random.uniform(0, 1, size=10000)

# 评估每个样本处的函数
values = function(samples)

# 计算函数值的平均值
mean_value = np.mean(values)

print("函数的平均值: ", mean_value)
输出
函数的平均值:0.3326046914715845
上面的代码演示了一个非常简单的例子,说明我们如何利用蒙特卡洛模拟来估计函数的平均值。通过生成大量随机样本,然后在每个样本处评估函数,我们可以轻松获得平均值的近似值。估计的准确性在很大程度上取决于生成的样本数量以及我们将要评估的函数的复杂性。
Bootstrap
Bootstrap 是一种统计方法,用于通过重新采样数据来估计估计量的抽样分布。它是一种强大的技术,可用于估计估计量的变异性并构建置信区间。该方法最初由 Bradley Efron 先生于 1979 年提出。
当样本量较小,或者总体分布未知或复杂,而中心极限定理等传统方法不适用时,Bootstrap 特别有用。
Bootstrap 的基本步骤是:
收集数据样本。
从原始样本中抽取大量 bootstrap 样本(有替换)。
为每个 bootstrap 样本计算感兴趣的估计量(例如平均值、标准差等)。
使用从 bootstrap 样本计算出的估计量的分布对总体进行推断。
Bootstrap 可以应用于各种估计量,包括平均值、标准差、回归系数等。它还可用于估计检验统计量的分布,例如 t 统计量,可用于检验有关总体参数的假设。
以下是使用 bootstrap 方法估计数据样本的标准差并构建 95% 置信区间的示例。
示例
import numpy as np

# 原始样本
data = [1, 2, 3, 4, 5]

# bootstrap 样本数
n_samples = 1000

# 用于存储 bootstrap 样本标准差的数组
std_devs = np.empty(n_samples)

# 生成 bootstrap 样本
for i in range(n_samples):
   sample = np.random.choice(data, size=len(data), replace=True)
   std_devs[i] = np.std(sample)

# 计算置信区间的下限和上限
alpha = 0.05
lower = np.percentile(std_devs, alpha/2*100)
upper = np.percentile(std_devs, (1-alpha/2)*100)

print(f'Confidence interval: [{lower}, {upper}]')
输出
Confidence interval: [0.4898979485566356, 1.7435595774162693]
在此示例中,我们从原始样本中抽取 1000 个引导样本,并计算每个样本的标准差。然后,我们使用标准差分布,使用 np.percentile() 函数计算 95% 置信区间的下限和上限。
马尔可夫链蒙特卡罗 (MCMC)
马尔可夫链蒙特卡罗 (MCMC) 是一类用于估计复杂概率分布参数的算法。这些算法构建一个马尔可夫链,该链以所需的概率分布作为其平衡分布。通过模拟该链,可以从该分布中生成样本,然后可用于统计推断。
MCMC 的基本思想是构建一个马尔可夫链,该链以目标分布作为其平稳分布。然后运行该链许多步,并定期收集样本。然后使用这些样本来估计目标分布的参数。
以下是如何使用 Metropolis-Hastings 算法(MCMC 的子部分)从正态分布中抽样的示例。
示例
import numpy as np

# 目标分布
mean = 0
std = 1
target = lambda x: 1/(std * np.sqrt(2 * np.pi)) * np.exp(-(x - mean)**2 / (2 * std**2))

# 提议分布
proposal_mean = 0
proposal_std = 2
proposal = lambda x: 1/(proposal_std * np.sqrt(2 * np.pi)) * np.exp(-(x - proposal_mean)**2 / (2 * proposal_std**2))

# 初始状态
x = 0

# 样本数
n_samples = 10000

# 存储样本的数组
samples = [x]

# Metropolis-Hastings 算法
for i in range(n_samples):
   x_new = np.random.normal(x, proposal_std)
   acceptance_prob = min(1, target(x_new) / target(x))
   if np.random.rand() < acceptance_prob:
      x = x_new
   samples.append(x)

# 绘制样本
import matplotlib.pyplot as plt
plt.hist(samples, bins=50, density=True)
plt.show()
输出
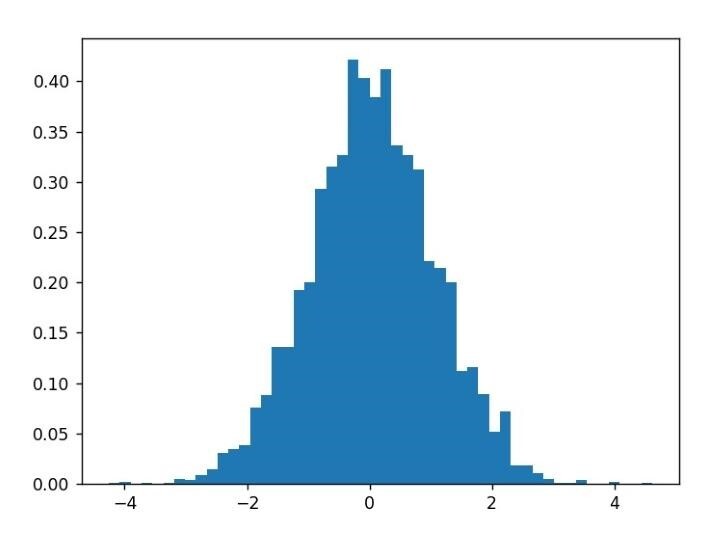
此脚本使用 Metropolis-Hastings 算法从均值为 0、标准差为 1 的正态分布生成样本序列,使用均值为 0、标准差为 2 的正态提议分布。该算法从初始状态(在本例中为 0)开始,然后通过从提议分布中提出新值来生成新状态。新值的接受概率由接受概率决定,该概率是根据目标和提议分布的比率计算得出的。
随机过程模拟
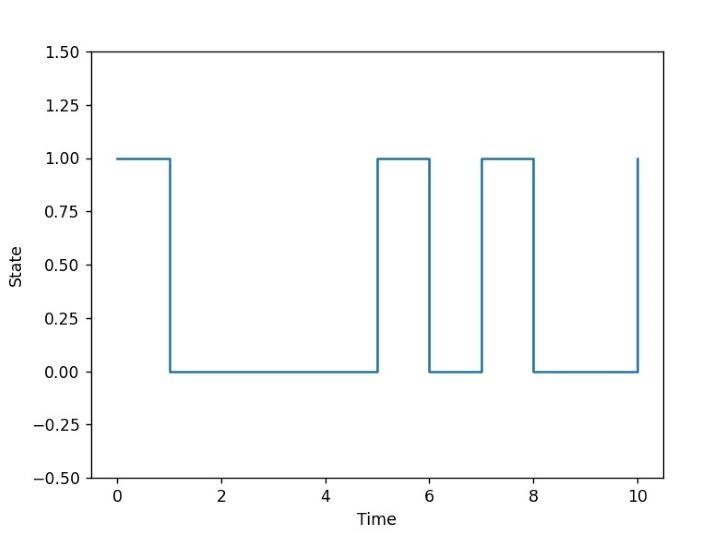
随机过程模拟是一类统计模拟,涉及随时间推移的随机行为模拟。它们用于对表现出随机性的复杂系统进行建模和分析,例如股票价格、天气模式和生物种群。
随机过程是一种数学模型,用于描述行为受随机性影响的系统。
示例
import numpy as np
import matplotlib.pyplot as plt

# 参数
p = 0.5  # 硬币正面朝上的概率
T = 10  # 定义时间步长数

# 初始状态
x = 1

# 随机数生成器
np.random.seed(0)

# 用于存储状态的数组
states = [x]

# 简单随机过程模拟
for t in range(T):
    x = 1 if np.random.rand() < p else 0
    states.append(x)

print(states)

# 绘制状态
plt.step(range(T+1), states, where='post')
plt.xlabel('Time')
plt.ylabel('State')
plt.ylim(-0.5,1.5)
plt.show()
输出
[1, 0, 0, 0, 0, 1, 0, 1, 0, 0, 1]
其他基本示例
这是一个模拟掷骰子的示例。
示例
import numpy as np

# 从 1 到 6 之间的均匀分布生成随机样本
samples = np.random.randint(1, 7, size=10000)

# 计算样本的平均值和标准差
sample_mean = np.mean(samples)
sample_std = np.std(samples)

print("样本平均值: ", sample_mean)
print("样本标准差: ", sample_std)
输出
样本平均值:3.4946
样本标准差:1.7094358250604205
结论
统计模拟是一种强大的工具,有助于理解和分析复杂的系统和过程。 Python 为我们提供了一系列工具和库,使我们可以轻松实现和执行统计模拟。
统计模拟的主要好处是它不仅能够对复杂的系统和过程进行建模,还能研究不同参数和变量对结果的影响。它的应用对几乎所有领域都有帮助。
NumPy、SciPy 和 Pandas 是一些库的示例,它们可用于生成随机样本、评估函数和执行统计分析。
总体而言,统计模拟是任何从事数据科学或相关领域工作的人的必备工具,而 Python 为实现这些模拟提供了一个灵活而强大的平台。通过利用统计模拟的力量,我们可以对复杂的系统和过程获得新的见解,并根据我们的分析做出更明智的决策。
相关文章
有用资源
python 参考教程 - 该教程包含有关 python 的更多信息:https://www.cainiaomax.com/python/

