
解释 2PL 中多粒度锁定的调度以及树下调度(DBMS)
dbmsdatabasebig data analytics更新于 2026/1/13 0:52:17
数据库的锁定和解锁应以不一致性、死锁和饥饿的方式进行。
2PL 锁定协议
每个事务都会在两个不同的阶段锁定和解锁数据项。
增长阶段 − 所有锁都在此阶段发出。所有数据项更改提交后,不会释放任何锁,然后开始第二阶段(收缩阶段)。
收缩阶段 −此阶段不发出任何锁,所有对数据项的更改都会被记录(存储),然后释放锁。
考虑如下树形结构数据库 −
A -> B -> C
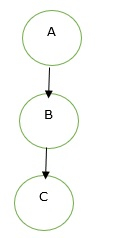
现在让我们了解一下在具有多粒度锁定的2PL下不可能实现的调度,以及在树协议下可能实现的调度。
事务Ti的第一个锁定可以是图上的任何项。
然后,假设X的父级当前已被Ti锁定,则事务Ti可以锁定数据项X。
之前锁定的数据项可以随时解锁。
| T1 | T2 |
|---|---|
| 锁定(A) | |
| 锁定(B) | |
| 解锁(A) | |
| 锁定(A) | |
| 锁定(C) | < br> |
| 解锁(B) | |
| 锁定(B) | |
| 解锁(A) | |
| 解锁(B) | |
| 解锁(C) |
这里,
在事务 T1
- 增长阶段包含步骤 1-3。
- 收缩阶段包含步骤 5-6。
- 锁定点位于步骤 3。
现在,让我们了解在具有多粒度锁定的 2PL 下可以实现的调度,以及在树协议下无法实现的调度。
- 它分两个阶段执行。
- 锁定在增长阶段完成。
- 解锁在收缩阶段完成。
- 锁定点是增长阶段结束的时间点。
| T1 | T2 |
|---|---|
| 锁定(A) | |
| 锁定(B) | |
| 锁定(C) | |
| 解锁(B) | |
| 解锁(A) | |
| 解锁(B) |
此处,
在事务 T2
中- 增长阶段处于步骤 2。
- 收缩阶段处于步骤4.
- 锁定点为 2

