
解释并发控制(DBMS)中的主要问题
dbmsdatabasebig data analytics更新于 2026/1/13 1:52:17
并发可以简单地理解为同时执行多个事务。它需要提高时间效率。如果多个事务尝试访问相同的数据,就会出现不一致的情况。并发控制需要维护数据的一致性。
例如,如果我们使用ATM机,并且不使用并发,那么多个人就无法在不同的地方同时取款。这就是我们需要并发的地方。
优点
使用并发控制的优点如下 −
- 等待时间减少。
- 响应时间减少。
- 资源利用率提高。
- 系统性能和效率提高。
为了并发运行事务,我们将它们的操作交错执行。每个事务都会获得一部分计算时间。
这会导致以下问题 −
丢失更新问题(写-写冲突)
临时更新或脏读问题(写-读冲突)。
不可重复读取或错误分析问题(读写冲突)。
所有这些问题的出现都是因为隔离被打破。
丢失更新问题
一个事务进行了一些更改,另一个事务删除了这些更改。一个事务使另一个事务的更新无效。
两个事务 T1 和 T2 以交错的方式读取、修改和写入同一个数据项,导致 x 中存储了错误的值。 T2 在 T1 修改 X 的值之前就读取了它,因此 T1 更新后的值丢失了。
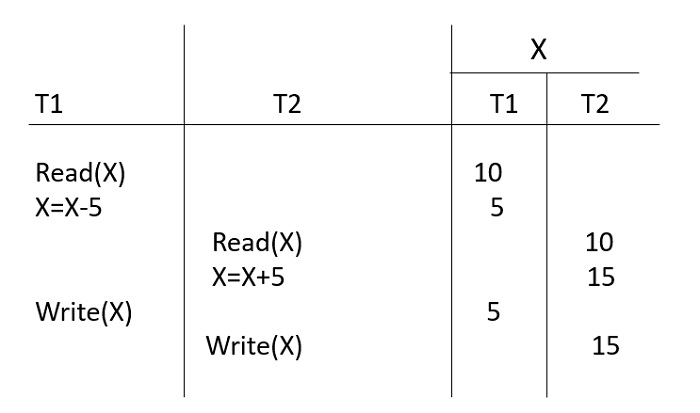
x 的最终值为 15,这是错误的。
临时更新问题或脏读问题
一个事务中更新了一个变量,与此同时,另一个事务启动并删除了该变量的值,而该变量并没有被更新或提交。这在第一个事务中已经发生过;这会导致错误值或变量的先前值;这是一个严重的问题。
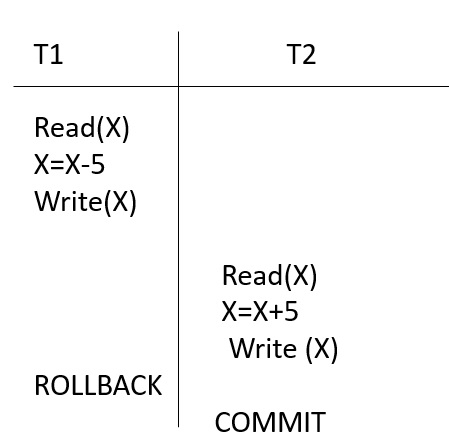
T2 读取了 T1 对 X 的更新值,但 T1 失败并回滚。因此,T2 读取了错误的 X 值。
不可重复读取或分析错误问题
一个事务正在更新多个不同的变量,而另一个事务也正在更新这些变量。问题在于同一变量在不同实例中的不一致。
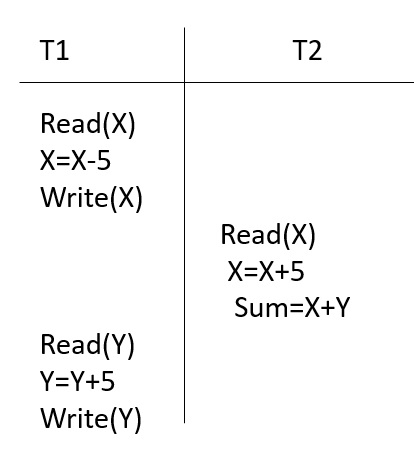
T1 由两部分组成:从 X 中减去 5,并将 Y 加 5。
在 T2 中,X 的值已更新,但 Y 的值未更新。sum 变量存储了错误的值。以下协议用于控制并发性并保持一致性。

