AVRO - 通过生成类进行序列化
可以通过生成与模式对应的类或使用解析器库将 Avro 模式读入程序。本章介绍如何通过生成类读取模式并使用 Avr 序列化数据。
通过生成类进行序列化
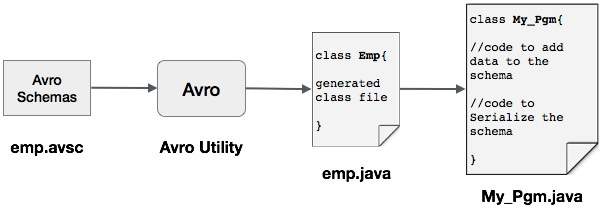
要使用 Avro 序列化数据,请按照以下步骤操作 −
编写 Avro 模式。
使用 Avro 实用程序编译模式。您将获得与该架构对应的 Java 代码。
使用数据填充架构。
使用 Avro 库对其进行序列化。
定义架构
假设您想要一个具有以下详细信息的架构 −
| Field | Name | id | age | salary | address |
| type | String | int | int | int | string |
创建一个 Avro 模式,如下所示。
将其保存为 emp.avsc。
{
   "namespace": "tutorialspoint.com",
   "type": "record",
   "name": "emp",
   "fields": [
      {"name": "name", "type": "string"},
      {"name": "id", "type": "int"},
      {"name": "salary", "type": "int"},
      {"name": "age", "type": "int"},
      {"name": "address", "type": "string"}
   ]
}
编译模式
创建 Avro 模式后,您需要使用 Avro 工具编译创建的模式。 avro-tools-1.7.7.jar 是包含工具的 jar。
编译 Avro 模式的语法
java -jar <path/to/avro-tools-1.7.7.jar> compile schema <path/to/schema-file> <destination-folder>
在主文件夹中打开终端。
创建一个新目录以使用 Avro,如下所示 −
$ mkdir Avro_Work
在新创建的目录中,创建三个子目录 −
第一个名为 schema,用于放置架构。
第二个名为 with_code_gen,用于放置生成的代码。
第三个名为 jars,用于放置 jar 文件。
$ mkdir schema
$ mkdir with_code_gen
$ mkdir jars
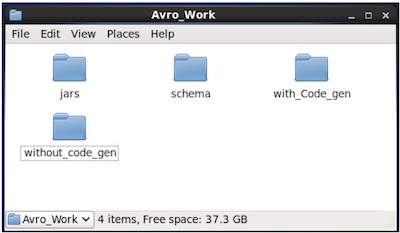
以下屏幕截图显示了您的创建所有目录后,Avro_work 文件夹应如下所示。
现在 /home/Hadoop/Avro_work/jars/avro-tools-1.7.7.jar 是您下载 avro-tools-1.7.7.jar 文件的目录的路径。
/home/Hadoop/Avro_work/schema/ 是存储模式文件 emp.avsc 的目录的路径。
/home/Hadoop/Avro_work/with_code_gen 是您希望存储生成的类文件的目录。
现在编译模式,如下所示−
$ java -jar /home/Hadoop/Avro_work/jars/avro-tools-1.7.7.jar compile schema /home/Hadoop/Avro_work/schema/emp.avsc /home/Hadoop/Avro/with_code_gen
编译后,在目标目录中创建一个根据模式名称空间的包。在此包中,创建具有模式名称的 Java 源代码。此生成的源代码是给定模式的 Java 代码,可直接在应用程序中使用。
例如,在此实例中,创建了一个名为 tutorialspoint 的包/文件夹,其中包含另一个名为 com 的文件夹(因为名称空间是 tutorialspoint.com),您可以在其中观察到生成的文件 emp.java。以下快照显示 emp.java −
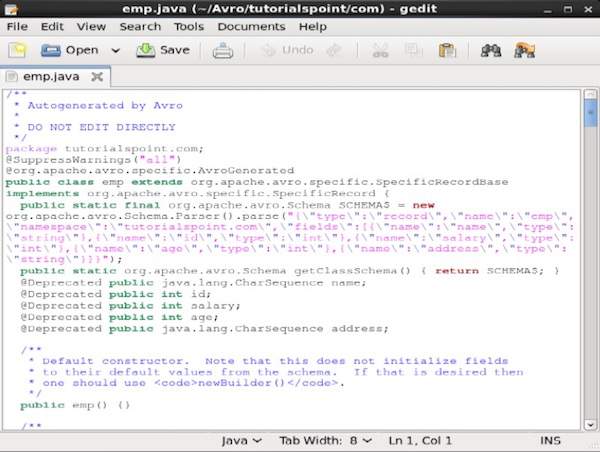
此类可用于根据架构创建数据。
生成的类包含 −
- 默认构造函数和参数化构造函数,它们接受架构的所有变量。
- 架构中所有变量的 setter 和 getter 方法。
- 返回架构的 Get() 方法。
- 构建器方法。
创建和序列化数据
首先,将本项目中使用的生成 java 文件复制到当前目录中,或从其所在位置导入它。
现在我们可以编写一个新的 Java 文件并在生成的文件 (emp) 中实例化该类,以将员工数据添加到模式。
让我们看看使用 apache Avro 根据模式创建数据的过程。
步骤 1
实例化生成的 emp 类。
emp e1=new emp( );
步骤 2
使用 setter 方法插入第一个员工的数据。例如,我们创建了名为 Omar 的员工的详细信息。
e1.setName("omar");
e1.setAge(21);
e1.setSalary(30000);
e1.setAddress("Hyderabad");
e1.setId(001);
同样,使用 setter 方法填写所有员工详细信息。
步骤 3
使用 SpecificDatumWriter 类创建 DatumWriter 接口的对象。这会将 Java 对象转换为内存中的序列化格式。以下示例为 emp 类实例化 SpecificDatumWriter 类对象。
DatumWriter<emp> empDatumWriter = new SpecificDatumWriter<emp>(emp.class);
步骤 4
为 emp 类实例化 DataFileWriter。此类将符合架构的序列化数据记录以及架构本身写入文件中。此类需要 DatumWriter 对象作为构造函数的参数。
DataFileWriter<emp> empFileWriter = new DataFileWriter<emp>(empDatumWriter);
步骤 5
使用 create() 方法打开一个新文件以存储与给定模式匹配的数据。此方法需要模式以及要存储数据的文件的路径作为参数。
在以下示例中,使用 getSchema() 方法传递模式,数据文件存储在路径 − /home/Hadoop/Avro/serialized_file/emp.avro.
empFileWriter.create(e1.getSchema(),new File("/home/Hadoop/Avro/serialized_file/emp.avro"));
步骤 6
使用 append() 方法将所有创建的记录添加到文件中,如下所示 −
empFileWriter.append(e1);
empFileWriter.append(e2);
empFileWriter.append(e3);
示例 – 通过生成类进行序列化
以下完整程序展示了如何使用 Apache Avro 将数据序列化到文件中 −
import java.io.File;
import java.io.IOException;

import org.apache.avro.file.DataFileWriter;
import org.apache.avro.io.DatumWriter;
import org.apache.avro.specific.SpecificDatumWriter;

public class Serialize {
   public static void main(String args[]) throws IOException{

      //Instantiating generated emp class
      emp e1=new emp();

      //Creating values according the schema
      e1.setName("omar");
      e1.setAge(21);
      e1.setSalary(30000);
      e1.setAddress("Hyderabad");
      e1.setId(001);

      emp e2=new emp();

      e2.setName("ram");
      e2.setAge(30);
      e2.setSalary(40000);
      e2.setAddress("Hyderabad");
      e2.setId(002);

      emp e3=new emp();

      e3.setName("robbin");
      e3.setAge(25);
      e3.setSalary(35000);
      e3.setAddress("Hyderabad");
      e3.setId(003);

      //Instantiate DatumWriter class
      DatumWriter<emp> empDatumWriter = new SpecificDatumWriter<emp>(emp.class);
      DataFileWriter<emp> empFileWriter = new DataFileWriter<emp>(empDatumWriter);

      empFileWriter.create(e1.getSchema(), new File("/home/Hadoop/Avro_Work/with_code_gen/emp.avro"));

      empFileWriter.append(e1);
      empFileWriter.append(e2);
      empFileWriter.append(e3);

      empFileWriter.close();

      System.out.println("data successfully serialized");
   }
}
浏览放置生成的代码的目录。在本例中,位于 home/Hadoop/Avro_work/with_code_gen。
在终端中 −
$ cd home/Hadoop/Avro_work/with_code_gen/
在 GUI 中 −
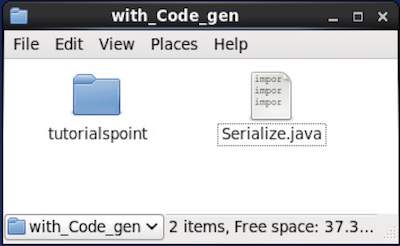
现在将上述程序复制并保存在名为 Serialize.java
的文件中编译并执行它,如下所示 −
$ javac Serialize.java
$ java Serialize
输出
数据已成功序列化
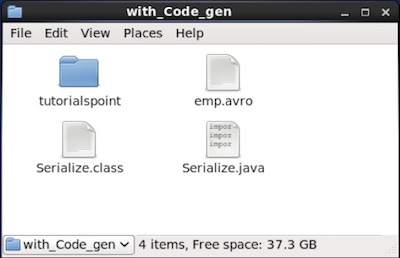
如果您验证了给出的路径程序中,您可以找到生成的序列化文件,如下所示。