
DocumentDB SQL - Joins 连接
在关系数据库中,Joins 子句用于组合数据库中两个或多个表中的记录,在设计规范化模式时,跨表连接的需求非常重要。 由于 DocumentDB 处理无模式文档的非规范化数据模型,因此 DocumentDB SQL 中的 JOIN 在逻辑上相当于"自连接"。
让我们像前面的示例一样考虑这三个文档。
以下是AndersenFamily文档。
{
   "id": "AndersenFamily",
   "lastName": "Andersen",

   "parents": [
      { "firstName": "Thomas", "relationship":  "father" },
      { "firstName": "Mary Kay", "relationship":  "mother" }
   ],

   "children": [
      {
         "firstName": "Henriette Thaulow",
         "gender": "female",
         "grade": 5,
         "pets": [ { "givenName": "Fluffy", "type":  "Rabbit" } ]
      }
   ],

   "location": { "state": "WA", "county": "King", "city": "Seattle" },
   "isRegistered": true
}
以下是SmithFamily文档。
{
   "id": "SmithFamily",

   "parents": [
      { "familyName": "Smith", "givenName": "James" },
      { "familyName": "Curtis", "givenName": "Helen" }
   ],

   "children": [
      {
         "givenName": "Michelle",
         "gender": "female",
         "grade": 1
      },

      {
         "givenName": "John",
         "gender": "male",
         "grade": 7,

         "pets": [
            { "givenName": "Tweetie", "type": "Bird" }
         ]
      }
   ],

   "location": {
      "state": "NY",
      "county": "Queens",
      "city": "Forest Hills"
   },

   "isRegistered": true
}
以下是WakefieldFamily文档。
{
   "id": "WakefieldFamily",

   "parents": [
      { "familyName": "Wakefield", "givenName": "Robin" },
      { "familyName": "Miller", "givenName": "Ben" }
   ],

   "children": [
      {
         "familyName": "Merriam",
         "givenName": "Jesse",
         "gender": "female",
         "grade": 6,

         "pets": [
            { "givenName": "Charlie Brown", "type": "Dog" },
            { "givenName": "Tiger", "type": "Cat" },
            { "givenName": "Princess", "type": "Cat" }
         ]
      },

      {
         "familyName": "Miller",
         "givenName": "Lisa",
         "gender": "female",
         "grade": 3,

         "pets": [
            { "givenName": "Jake", "type": "Snake" }
         ]
      }
   ],

   "location": { "state": "NY", "county": "Manhattan", "city": "NY" },
   "isRegistered": false
}
让我们看一个示例来了解 JOIN 子句的工作原理。
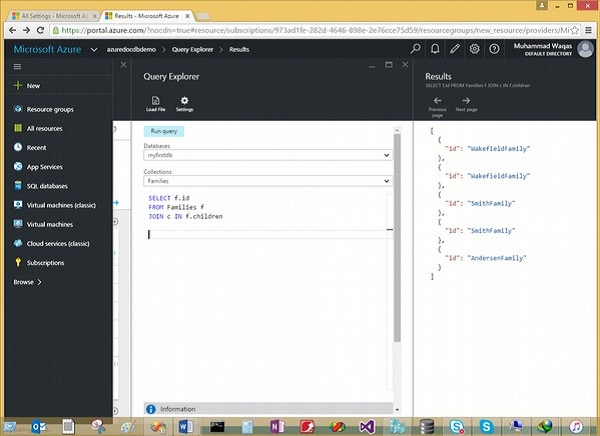
以下是将根目录连接到子文档的查询。
SELECT f.id
FROM Families f
JOIN c IN f.children
执行上述查询时,将产生以下输出。
[
   {
      "id": "WakefieldFamily"
   },

   {
      "id": "WakefieldFamily"
   },

   {
      "id": "SmithFamily"
   },

   {
      "id": "SmithFamily"
   },

   {
      "id": "AndersenFamily"
   }
]
在上面的示例中,联接位于文档根和子根之间,这在两个 JSON 对象之间生成叉积。 以下是一些需要注意的地方−
在 FROM 子句中,JOIN 子句是一个迭代器。
前两个文档 WakefieldFamily 和 SmithFamily 包含两个子文档,因此结果集还包含叉积,该叉积为每个子文档生成一个单独的对象。
第三个文档 AndersenFamily 仅包含一个子文档,因此只有一个对象与该文档对应。
让我们看一下同一个示例,但是这次我们还检索子名称,以便更好地理解 JOIN 子句。
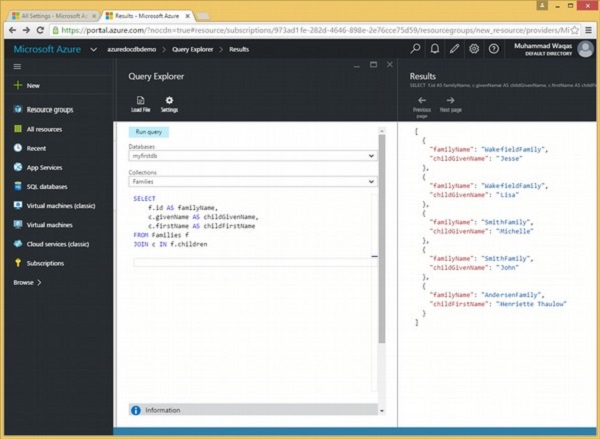
以下是将根目录连接到子文档的查询。
SELECT
   f.id AS familyName,
   c.givenName AS childGivenName,
   c.firstName AS childFirstName
FROM Families f
JOIN c IN f.children
执行上述查询时,会产生以下输出。
[
   {
      "familyName": "WakefieldFamily",
      "childGivenName": "Jesse"
   },

   {
      "familyName": "WakefieldFamily",
      "childGivenName": "Lisa"
   },

   {
      "familyName": "SmithFamily",
      "childGivenName": "Michelle"
   },

   {
      "familyName": "SmithFamily",
      "childGivenName": "John"
   },

   {
      "familyName": "AndersenFamily",
      "childFirstName": "Henriette Thaulow"
   }
]

