PDFBox - 拆分 PDF 文档
在上一章中,我们了解了如何将 JavaScript 添加到 PDF 文档。现在让我们学习如何将给定的 PDF 文档拆分为多个文档。
拆分 PDF 文档中的页面
您可以使用名为 Splitter 的类将给定的 PDF 文档拆分为多个 PDF 文档。此类用于将给定的 PDF 文档拆分为几个其他文档。
以下是拆分现有 PDF 文档的步骤
步骤 1:加载现有 PDF 文档
使用 PDDocument 类的静态方法 load() 加载现有 PDF 文档。此方法接受文件对象作为参数,因为这是一个静态方法,您可以使用类名调用它,如下所示。
File file = new File("文档路径")
PDDocument document = PDDocument.load(file);
步骤 2:实例化 Splitter 类
名为 Splitter 的类包含拆分给定 PDF 文档的方法,因此,实例化此类,如下所示。
Splitter splitter = new Splitter();
步骤 3:拆分 PDF 文档
您可以使用 Splitter 类的 Split() 方法拆分给定的文档。此方法接受 PDDocument 类的对象作为参数。
List<PDDocument> Pages = splitter.split(document);
split() 方法将给定文档的每一页拆分为单独的文档,并以列表的形式返回所有这些文档。
步骤 4:创建迭代器对象
为了遍历文档列表,您需要获取上一步获取的列表的迭代器对象,您需要使用 listIterator() 方法获取列表的迭代器对象,如下所示。
Iterator<PDDocument> iterator = Pages.listIterator();
步骤 5:关闭文档
最后,使用 PDDocument 类的 close() 方法关闭文档,如下所示。
document.close();
示例
假设,在路径 C:\PdfBox_Examples\ 中有一个名为 sample.pdf 的 PDF 文档,该文档包含两页 — 一页包含图像,另一页包含文本,如下所示。
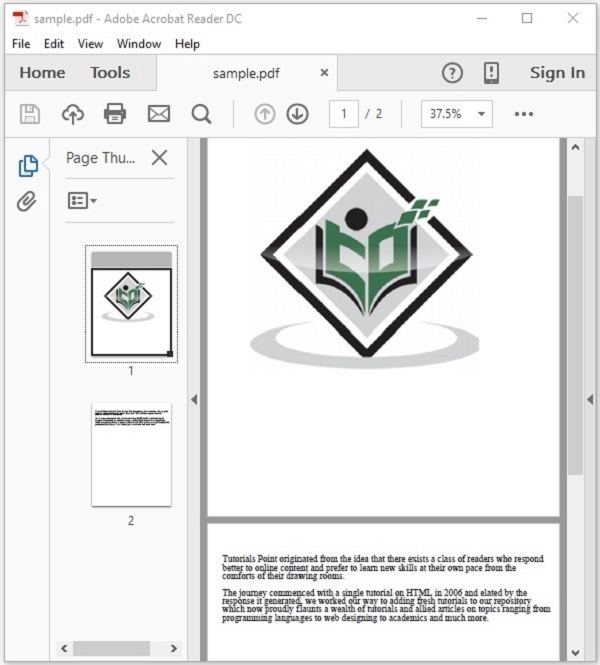
此示例演示如何拆分上述 PDF 文档。在这里,我们将把名为 sample.pdf 的 PDF 文档拆分为两个不同的文档 sample1.pdf 和 sample2.pdf。将此代码保存在名为 SplitPages.java 的文件中。
import org.apache.pdfbox.multipdf.Splitter;
import org.apache.pdfbox.pdmodel.PDDocument;

import java.io.File;
import java.io.IOException;
import java.util.List;
import java.util.Iterator;

public class SplitPages {
   public static void main(String[] args) throws IOException {

        //加载现有 PDF 文档
        File file = new File("C:/PdfBox_Examples/sample.pdf");
        PDDocument document = PDDocument.load(file);

        //实例化 Splitter 类
        Splitter splitter = new Splitter();

        //拆分 PDF 文档的页面
        List<PDDocument> Pages = splitter.split(document);

        //创建迭代器
        Iterator<PDDocument> iterator = Pages.listIterator();

        //将每页保存为单独的文档
        int i = 1;
        while(iterator.hasNext()) {
         PDDocument pd = iterator.next();
         pd.save("C:/PdfBox_Examples/sample"+ i++ +".pdf");
        }
        System.out.println("Multiple PDF’s created");
        document.close();
   }
}
使用以下命令从命令提示符编译并执行已保存的 Java 文件
javac SplitPages.java
java SplitPages
执行后,上述程序将加密给定的 PDF 文档,并显示以下消息。
Multiple PDF's created
如果验证给定的路径,您可以观察到创建了多个 PDF,名称分别为 sample1 和 sample2,如下所示。