
TIKA - 内容提取
Tika 使用各种解析器库从给定的解析器中提取内容。它选择正确的解析器来提取给定的文档类型。
对于解析文档,通常使用 Tika Facade 类的 parseToString() 方法。下面显示了解析过程中涉及的步骤,这些步骤由 Tika ParsertoString() 方法抽象出来。
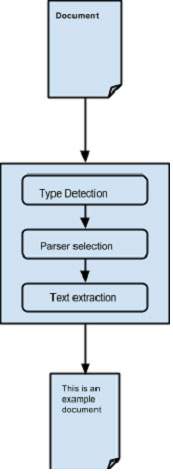
抽象解析过程 −
最初,当我们将文档传递给 Tika 时,它会使用可用的合适类型检测机制并检测文档类型。
一旦知道文档类型,它就会从其解析器存储库中选择合适的解析器。解析器存储库包含使用外部库的类。
然后传递文档以选择解析器,该解析器将解析内容,提取文本,并对不可读格式抛出异常。
使用 Tika 提取内容
下面给出的是使用 Tika 外观类从文件中提取文本的程序 −
import java.io.File;
import java.io.IOException;

import org.apache.tika.Tika;
import org.apache.tika.exception.TikaException;

import org.xml.sax.SAXException;

public class TikaExtraction {

   public static void main(final String[] args) throws IOException, TikaException {

      //假设sample.txt位于当前目录中
      File file = new File("sample.txt");

      //实例化Tika外观类
      Tika tika = new Tika();
      String filecontent = tika.parseToString(file);
      System.out.println("Extracted Content: " + filecontent);
   }
}
将上述代码保存为 TikaExtraction.java 并从命令提示符运行 −
javac TikaExtraction.java
java TikaExtraction
下面给出的是 sample.txt 的内容。
Hi students welcome to tutorialspoint
它为您提供以下输出 −
Extracted Content: Hi students welcome to tutorialspoint
使用解析器接口提取内容
Tika 的解析器包提供了几个接口和类,我们可以使用这些接口和类来解析文本文档。下面是 org.apache.tika.parser 包的框图。
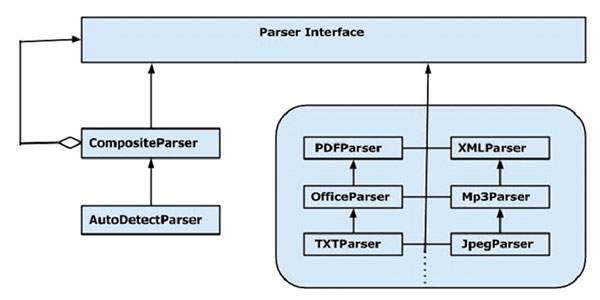
有多个解析器类可用,例如 pdf 解析器、Mp3Passer、OfficeParser 等,用于单独解析各个文档。所有这些类都实现了解析器接口。
CompositeParser
给定的图表显示了 Tika 的通用解析器类:CompositeParser 和 AutoDetectParser。由于 CompositeParser 类遵循复合设计模式,因此您可以将一组解析器实例用作单个解析器。 CompositeParser 类还允许访问实现解析器接口的所有类。
AutoDetectParser
这是 CompositeParser 的子类,它提供自动类型检测。使用此功能,AutoDetectParser 会使用复合方法自动将传入的文档发送到适当的解析器类。
parse() 方法
除了 parseToString() 之外,您还可以使用解析器接口的 parse() 方法。此方法的原型如下所示。
parse(InputStream stream, ContentHandler handler, Metadata metadata, ParseContext context)
下表列出了它接受作为参数的四个对象。
| Sr.No. | 对象和说明 |
|---|---|
| 1 |
InputStream 流 任何包含文件内容的 Inputstream 对象 |
| 2 |
ContentHandler 处理程序 Tika 将文档作为 XHTML 内容传递给此处理程序,然后使用 SAX API 处理该文档。它提供了对文档内容的有效后处理。 |
| 3 |
元数据元数据 元数据对象既用作文档元数据的源,也用作文档元数据的目标。 |
| 4 |
ParseContext 上下文 此对象用于客户端应用程序想要自定义解析过程的情况。 |
示例
下面给出了一个示例,展示了如何使用 parse() 方法。
步骤 1 −
要使用解析器接口的 parse() 方法,实例化任何提供此接口实现的类。
有单独的解析器类,例如 PDFParser、OfficeParser、XMLParser 等。您可以使用任何这些单独的文档解析器。或者,您可以使用 CompositeParser 或 AutoDetectParser,它们在内部使用所有解析器类并使用合适的解析器提取文档的内容。
Parser parser = new AutoDetectParser();
   (or)
Parser parser = new CompositeParser();
   (or)
object of any individual parsers given in Tika Library
步骤 2 −
创建一个处理程序类对象。下面给出了三个内容处理程序 −
| Sr.No. | 类和说明 |
|---|---|
| 1 |
BodyContentHandler 此类选择 XHTML 输出的正文部分并将该内容写入输出编写器或输出流。然后它将 XHTML 内容重定向到另一个内容处理程序实例。 |
| 2 |
LinkContentHandler 此类检测并选择 XHTML 文档的所有 H-Ref 标签,并转发这些标签以供网络爬虫等工具使用。 |
| 3 |
TeeContentHandler 此类有助于同时使用多个工具。 |
由于我们的目标是从文档中提取文本内容,因此实例化 BodyContentHandler,如下所示 −
BodyContentHandler handler = new BodyContentHandler( );
步骤 3 −
创建 Metadata 对象,如下所示 −
Metadata metadata = new Metadata();
步骤 4 −
创建任何输入流对象,并将应提取的文件传递给它。
FileInputstream
通过将文件路径作为参数传递来实例化文件对象,并将此对象传递给 FileInputStream 类构造函数。
注意 − 传递给文件对象的路径不应包含空格。
这些输入流类的问题在于它们不支持随机访问读取,而这是有效处理某些文件格式所必需的。为了解决这个问题,Tika 提供了 TikaInputStream。
File  file = new File(filepath)
FileInputStream inputstream = new FileInputStream(file);
   (or)
InputStream stream = TikaInputStream.get(new File(filename));
步骤 5 −
创建一个解析上下文对象,如下所示 −
ParseContext context =new ParseContext();
步骤 6 −
实例化解析器对象,调用解析方法,并传递所需的所有对象,如下面原型所示 −
parser.parse(inputstream, handler, metadata, context);
下面给出了使用解析器接口进行内容提取的程序 −
import java.io.File;
import java.io.FileInputStream;
import java.io.IOException;

import org.apache.tika.exception.TikaException;
import org.apache.tika.metadata.Metadata;
import org.apache.tika.parser.AutoDetectParser;
import org.apache.tika.parser.ParseContext;
import org.apache.tika.parser.Parser;
import org.apache.tika.sax.BodyContentHandler;

import org.xml.sax.SAXException;

public class ParserExtraction {

   public static void main(final String[] args) throws IOException,SAXException, TikaException {

      //假设sample.txt位于当前目录中
      File file = new File("sample.txt");

      //解析方法参数
      Parser parser = new AutoDetectParser();
      BodyContentHandler handler = new BodyContentHandler();
      Metadata metadata = new Metadata();
      FileInputStream inputstream = new FileInputStream(file);
      ParseContext context = new ParseContext();

      //解析文件
      parser.parse(inputstream, handler, metadata, context);
      System.out.println("File content : " + Handler.toString());
   }
}
将上述代码保存为 ParserExtraction.java 并从命令提示符 − 运行它
javac ParserExtraction.java
java ParserExtraction
下面给出了 sample.txt 的内容
Hi students welcome to tutorialspoint
如果你执行上述程序,它将给出以下输出 −
File content : Hi students welcome to tutorialspoint

