
TIKA - 提取 XML 文档
下面给出的是从 XML 文档中提取内容和元数据的程序 −
import java.io.File;
import java.io.FileInputStream;
import java.io.IOException;

import org.apache.tika.exception.TikaException;
import org.apache.tika.metadata.Metadata;
import org.apache.tika.parser.ParseContext;
import org.apache.tika.parser.xml.XMLParser;
import org.apache.tika.sax.BodyContentHandler;

import org.xml.sax.SAXException;

public class XmlParse {

   public static void main(final String[] args) throws IOException,SAXException, TikaException {

      //检测文件类型
      BodyContentHandler handler = new BodyContentHandler();
      Metadata metadata = new Metadata();
      FileInputStream inputstream = new FileInputStream(new File("pom.xml"));
      ParseContext pcontext = new ParseContext();

      //Xml解析器
      XMLParser xmlparser = new XMLParser();
      xmlparser.parse(inputstream, handler, metadata, pcontext);
      System.out.println("Contents of the document:" + handler.toString());
      System.out.println("Metadata of the document:");
      String[] metadataNames = metadata.names();

      for(String name : metadataNames) {
         System.out.println(name + ": " + metadata.get(name));
      }
   }
}
将上述代码保存为 XmlParse.java,并使用以下命令从命令提示符编译它 −
javac XmlParse.java
java XmlParse
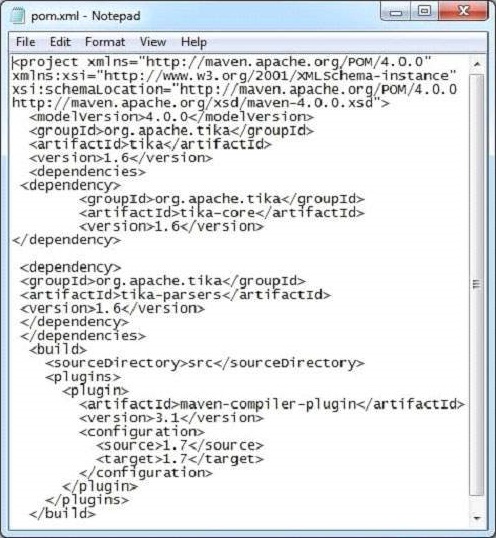
下面给出了 example.xml 文件的快照
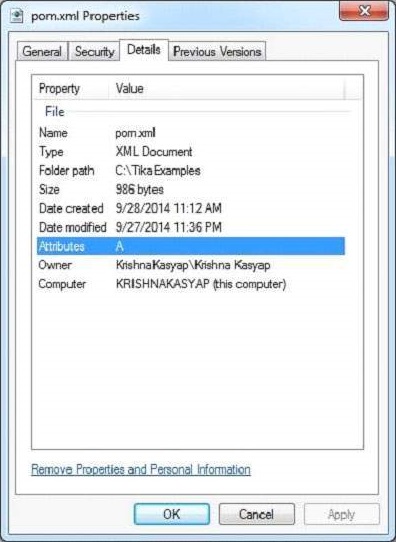
此文档具有以下属性 −
如果执行上述程序,它将为您提供以下输出 −
输出 −
文档内容:

4.0.0
org.apache.tika
tika
1.6
org.apache.tika
tika-core
1.6
org.apache.tika
tika-parsers
1.6
src
maven-compiler-plugin
3.1
1.7
1.7

文档的元数据:

Content-Type:   application/xml

