如何使用 Selenium 获取整个页面的内容?
seleniumautomation testingtesting tools更新于 2026/2/12 10:37:17
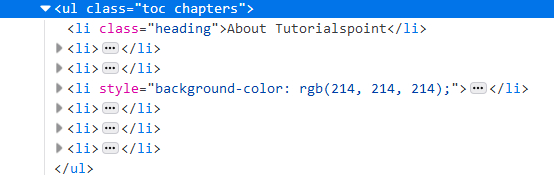
我们可以使用 CSS 选择器获取所有元素的直属子元素。我们必须使用 findElements() 方法来获取直属子元素。此方法将返回与 CSS 选择器匹配的元素列表。
在 CSS 选择器中,如果我们需要从父元素遍历到子元素,则使用 > 符号。要获取所有直属子元素,我们必须在 CSS 表达式中的父节点后指定 * 符号。因此,自定义的 CSS 应该是 parent > *。
因此,对于 <ul class="toc chapter>,直属子元素的 CSS 应该是 ul.toc.chapters >*。
示例
代码实现。
import org.openqa.selenium.By;
import org.openqa.selenium.WebDriver;
import org.openqa.selenium.WebElement;
import org.openqa.selenium.chrome.ChromeDriver;
import java.util.concurrent.TimeUnit;
import java.util.List;
public class ImdtChildrenCss{
   public static void main(String[] args) {
      System.setProperty("webdriver.chrome.driver", "C:\Users\ghs6kor\Desktop\Java\chromedriver.exe");
      WebDriver driver = new ChromeDriver();
      String url = "https://www.tutorialspoint.com/about/about_careers.htm";
      driver.get(url);
      driver.manage().timeouts().implicitlyWait(5, TimeUnit.SECONDS);
      // 识别父元素的直属子元素并将其存储在 CSS 中
      List<WebElement> l = driver.findElements(By.cssSelector("ul.toc.chapters" + ">*"));
      // 迭代列表并获取子元素
      for (int i =0; i< l.size(); i++) {
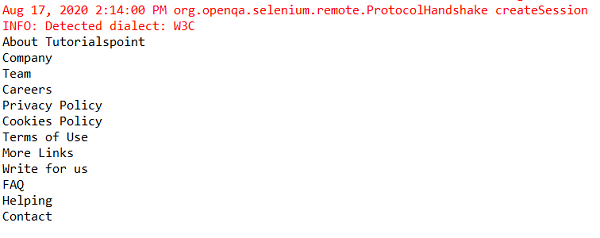
         System.out.println(l.get(i).getText());
      }
      driver.quit();
   }
}
输出