
Scikit Learn - 聚类方法
本文将学习 Sklearn 中的聚类方法,这些方法有助于识别数据样本中的相似性。
聚类方法是最有用的无监督机器学习方法之一,用于查找数据样本之间的相似性和关系模式。之后,它们根据特征将这些样本聚类成具有相似性的组。聚类决定了当前未标记数据的内在分组,因此它非常重要。
Scikit-learn 库中有 sklearn.cluster 来对未标记数据进行聚类。在此模块下,scikit-learn 提供了以下聚类方法 −
KMeans
该算法计算质心并迭代,直到找到最优质心。它需要指定聚类的数量,因此它假设聚类数量是已知的。该算法的主要逻辑是通过最小化惯性标准(称为惯性)将数据聚类,从而将样本分成 n 个方差相等的组。算法识别出的聚类数量用"K"表示。
Scikit-learn 包含 sklearn.cluster.KMeans 模块来执行 K 均值聚类。在计算聚类中心和惯性值时,名为 sample_weight 的参数允许 sklearn.cluster.KMeans 模块为某些样本分配更大的权重。
亲和传播
该算法基于不同样本对之间"消息传递"的概念,直至收敛。运行算法之前无需指定聚类数量。该算法的时间复杂度为𝑂(𝑁2𝑇)量级,这是其最大的缺点。
Scikit-learn 包含 sklearn.cluster.AffinityPropagation 模块来执行亲和传播聚类。
均值漂移
该算法主要在样本密度均匀分布的blob中发现数据点。它通过将数据点向数据点密度最高的方向移动,迭代地将数据点分配到聚类中。它不再依赖名为 bandwidth 的参数来指定搜索区域的大小,而是自动设置聚类的数量。
Scikit-learn 拥有 sklearn.cluster.MeanShift 模块来执行 Mean Shift 聚类。
谱聚类
在聚类之前,该算法基本上使用特征值(即数据相似矩阵的谱)在较少的维度上进行降维。当聚类数量较多时,不建议使用此算法。
Scikit-learn 拥有 sklearn.cluster.SpectralClustering 模块来执行谱聚类。
层次聚类
该算法通过连续合并或拆分聚类来构建嵌套聚类。这种聚类层次结构以树状图(即树)的形式表示。它分为以下两类 −
凝聚型分层算法 − 在这种分层算法中,每个数据点都被视为一个单独的聚类。然后,它会依次聚合成对的聚类。这采用自下而上的方法。
分裂型分层算法 − 在这种分层算法中,所有数据点都被视为一个大聚类。在此过程中,聚类过程涉及使用自上而下的方法将一个大聚类划分为多个小聚类。
Scikit-learn 具有 sklearn.cluster.AgglomerativeClustering 模块来执行凝聚型分层聚类。
DBSCAN
它代表"基于密度的噪声空间聚类"。该算法基于"聚类"和"噪声"的直观概念,即聚类是数据空间中密度较低的密集区域,由密度较低的数据点区域分隔。
Scikit-learn 包含 sklearn.cluster.DBSCAN 模块来执行 DBSCAN 聚类。该算法使用两个重要参数 min_samples 和 eps 来定义稠密程度。
参数 min_samples 的较高值或参数 eps 的较低值表示形成聚类所需的数据点密度较高。
OPTICS
它代表"对点进行排序以识别聚类结构"。该算法还可以在空间数据中查找基于密度的聚类。它的基本工作逻辑类似于 DBSCAN。
它解决了 DBSCAN 算法的一个主要弱点——在不同密度的数据中检测有意义的聚类的问题——通过对数据库中的点进行排序,使空间上最接近的点在排序中成为邻居。
Scikit-learn 有 sklearn.cluster.OPTICS 模块来执行 OPTICS 聚类。
BIRCH
它代表使用层次结构的平衡迭代约简和聚类。它用于对大型数据集执行层次聚类。它为给定数据构建一棵名为 CFT 的树,即 特征树。
CFT 的优势在于,名为 CF(特征树)的数据节点保存了聚类所需的信息,从而进一步避免了将整个输入数据保存在内存中的需要。
Scikit-learn 具有 sklearn.cluster.Birch 模块来执行 BIRCH 聚类。
聚类算法比较
下表将对 scikit-learn 中的聚类算法进行基于参数、可扩展性和度量的比较。
| Sr.No | 算法名称 | 参数 | 可扩展性 | 使用的指标 |
|---|---|---|---|---|
| 1 | K-Means | 否聚类数量 | 非常大的 n_samples | 点与点之间的距离 |
| 2 | 亲和传播 | 阻尼 | 无法通过 n_samples 进行扩展 | 图距离 |
| 3 | 均值漂移 | 带宽 | 无法通过 n_samples 进行扩展 | 点与点之间的距离 |
| 4 | 谱聚类 | 聚类数量 | 中等使用 n_samples 实现高可扩展性。 使用 n_clusters 实现低可扩展性。 | 图距离 |
| 5 | 层次聚类 | 距离阈值或聚类数量 | 较大的 n_samples 较大的 n_clusters | 点之间的距离。 |
| 6 | DBSCAN | 邻域大小 | 样本数非常大,簇数中等。 | 最近点距离 |
| 7 | OPTICS | 最小聚类成员 | 样本数非常大,簇数较大。 | 点与点之间的距离。 |
| 8 | BIRCH | 阈值,分支因子 | 样本数较大 簇数较大 | 点与点之间的欧氏距离点。 |
在 Scikit-learn 数字数据集上进行 K 均值聚类
在本例中,我们将在数字数据集上应用 K 均值聚类。该算法无需使用原始标签信息即可识别相似的数字。实现在 Jupyter Notebook 上完成。
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np
from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
输出
1797, 64)
此输出显示数字数据集包含 1797 个样本,每个样本包含 64 个特征。
示例
现在,按如下方式执行 K-Means 聚类 −
kmeans = KMeans(n_clusters = 10, random_state = 0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
输出
(10, 64)
此输出显示 K-means 聚类创建了 10 个聚类,每个聚类包含 64 个特征特征。
示例
fig, ax = plt.subplots(2, 5, figsize = (8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centres):
axi.set(xticks = [], yticks = [])
axi.imshow(center, interpolation = 'nearest', cmap = plt.cm.binary)
输出
以下输出包含通过 K-Means 聚类学习到的聚类中心图像。
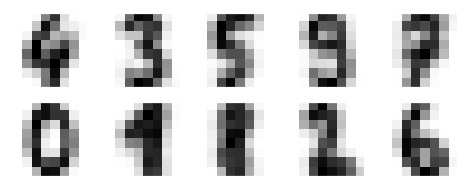
接下来,下面的 Python 脚本将匹配学习到的聚类标签(通过 K-Means 算法)与其中找到的真实标签之差 −
from scipy.stats import mode
labels = np.zeros_like(clusters)
for i in range(10):
mask = (clusters == i)
labels[mask] = mode(digits.target[mask])[0]
我们也可以借助以下命令检查准确率。
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, label)
输出
0.7935447968836951
完整实现示例
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np

from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
kmeans = KMeans(n_clusters = 10, random_state = 0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
fig, ax = plt.subplots(2, 5, figsize = (8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centers):
   axi.set(xticks=[], yticks = [])
   axi.imshow(center, interpolation = 'nearest', cmap = plt.cm.binary)
from scipy.stats import mode
labels = np.zeros_like(clusters)
for i in range(10):
   mask = (clusters == i)
   labels[mask] = mode(digits.target[mask])[0]
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, labels)

