
Scikit Learn - 支持向量机
本章介绍一种称为支持向量机 (SVM) 的机器学习方法。
简介
支持向量机 (SVM) 是一种强大而灵活的监督机器学习方法,可用于分类、回归和异常值检测。SVM 在高维空间中非常高效,通常用于分类问题。支持向量机 (SVM) 非常流行,而且内存效率高,因为它们在决策函数中使用训练点的子集。
SVM 的主要目标是将数据集划分为多个类别,以便找到最大边缘超平面 (MMH),这可以通过以下两个步骤完成 −
支持向量机 (SVM) 首先会迭代生成超平面,以最佳方式分离类别。
之后,它会选择能够正确分离类别的超平面。
SVM 中的一些重要概念如下 −
支持向量 − 它们可以定义为最接近超平面的数据点。支持向量有助于确定分割线。
超平面 − 划分具有不同类别的对象集的决策平面或空间。
边距 −不同类别中最近数据点之间两条线的间隙称为边距 (marginal)。
下图将帮助您深入了解 SVM 的这些概念 −
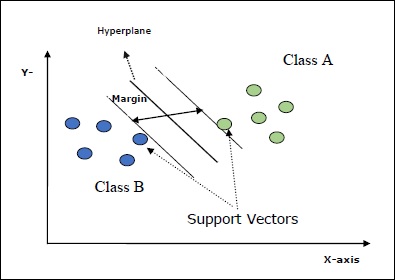
Scikit-learn 中的 SVM 支持稀疏和密集样本向量作为输入。
SVM 的分类
Scikit-learn 提供了三个类,分别是 SVC、NuSVC 和 LinearSVC,它们可以执行多类别分类。
SVC
它是 C 语言支持向量分类器,其实现基于 libsvm。 scikit-learn 使用的模块是 sklearn.svm.SVC。该类根据一对一方案处理多分类支持。
参数
下表列出了 sklearn.svm.SVC 类 − 使用的参数。
| Sr.No | 参数及说明 |
|---|---|
| 1 |
C −浮点型,可选,默认值 = 1.0 这是误差项的惩罚参数。 |
| 2 |
kernel − 字符串,可选,默认值 = 'rbf' 此参数指定算法中使用的核类型。我们可以从'linear'、'poly'、'rbf'、'sigmoid'、'precomputed'中选择任意一种。核的默认值为'rbf'。 |
| 3 |
degree − int,可选,默认值 = 3 它表示"poly"核函数的度数,所有其他核函数都会忽略它。 |
| 4 |
gamma − {'scale', 'auto'} 或浮点型, 这是核函数'rbf'、'poly'和'sigmoid'的核系数。 |
| 5 |
可选默认值 − = 'scale' 如果选择默认值,即 gamma = 'scale',则 SVC 使用的 gamma 值为 1/(𝑛_𝑓𝑒𝑎𝑡𝑢𝑟𝑒𝑠∗𝑋.𝑣𝑎𝑟())。 另一方面,如果 gamma = 'auto',则使用 1/𝑛_𝑓𝑒𝑎𝑡𝑢𝑟𝑒𝑠。 |
| 6 |
coef0 −浮点型,可选,默认值 = 0.0 核函数中的一个独立项,仅在"poly"和"sigmoid"核函数中有效。 |
| 7 |
tol − 浮点型,可选,默认值 = 1.e-3 此参数表示迭代的停止标准。 |
| 8 |
shrinking −布尔值,可选,默认值 = True 此参数表示是否要使用收缩启发式算法。 |
| 9 |
verbose − 布尔值,默认值:false 启用或禁用详细输出。其默认值为 false。 |
| 10 |
probability − 布尔值,可选,默认值 = true 此参数启用或禁用概率估计。默认值为 false,但必须在调用 fit 之前启用。 |
| 11 |
max_iter − int,可选,默认值 = -1 顾名思义,它表示求解器中的最大迭代次数。值 -1 表示迭代次数没有限制。 |
| 12 |
cache_size − float,可选 此参数将指定内核缓存的大小。该值以 MB(兆字节)为单位。 |
| 13 |
random_state − int,RandomState 实例或 None,可选,默认值为 none 此参数表示生成的伪随机数的种子,用于混洗数据。以下是选项 −
|
| 14 |
class_weight − {dict, 'balanced'},可选 此参数将设置类别 j 的参数 C 为 SVC 的 𝑐𝑙𝑎𝑠𝑠_𝑤𝑒𝑖𝑔ℎ𝑡[𝑗]∗𝐶。如果使用默认选项,则意味着所有类别的权重都应该为 1。另一方面,如果选择 class_weight:balanced,它将使用 y 的值自动调整权重。 |
| 15 |
decision_function_shape − ovo', 'ovr',默认值 = 'ovr' 此参数将决定算法是否返回与所有其他分类器形状相同的 'ovr'(一对多)决策函数,还是返回 libsvm 的原始 ovo(一对一)决策函数。 |
| 16 |
break_ties − 布尔值,可选,默认值 = false True − 预测将根据 decision_function 的置信度值打破平局。 False −预测将返回绑定类中的第一个类。 |
属性
下表包含 sklearn.svm.SVC 类 − 使用的属性
| Sr.No | 属性和说明 |
|---|---|
| 1 |
support_ −类似数组,形状 = [n_SV] 返回支持向量的索引。 |
| 2 |
support_vectors_ − 类似数组,形状 = [n_SV, n_features] 返回支持向量。 |
| 3 |
n_support_ −数组类型,dtype=int32,shape = [n_class] 它表示每个类的支持向量数量。 |
| 4 |
dual_coef_ − 数组,shape = [n_class-1,n_SV] 这些是决策函数中支持向量的系数。 |
| 5 |
coef_ − 数组,形状 = [n_class * (n_class-1)/2, n_features] 此属性仅在线性核函数中可用,用于指定分配给特征的权重。 |
| 6 |
intercept_ − 数组,形状 = [n_class * (n_class-1)/2] 它表示决策函数中的独立项(常数)。 |
| 7 |
fit_status_ − int 如果拟合正确,则输出为 0。如果拟合不正确,输出将为 1。 |
| 8 |
classes_ − 数组,形状为 [n_classes] 它给出了类别的标签。 |
实现示例
与其他分类器一样,SVC 也需要使用以下两个数组 − 进行拟合。
一个数组 X,用于保存训练样本。其大小为 [n_samples, n_features]。
一个数组 Y,用于保存目标值,即训练样本的类别标签。其大小为 [n_samples]。
以下 Python 脚本使用 sklearn.svm.SVC 类 −
import numpy as np
X = np.array([[-1, -1], [-2, -1], [1, 1], [2, 1]])
y = np.array([1, 1, 2, 2])
from sklearn.svm import SVC
SVCClf = SVC(kernel = 'linear',gamma = 'scale', shrinking = False,)
SVCClf.fit(X, y)
输出
SVC(C = 1.0, cache_size = 200, class_weight = None, coef0 = 0.0,
   decision_function_shape = 'ovr', degree = 3, gamma = 'scale', kernel = 'linear',
   max_iter = -1, probability = False, random_state = None, shrinking = False,
   tol = 0.001, verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本获取权重向量 −
SVCClf.coef_
输出
array([[0.5, 0.5]])
示例
类似地,我们可以获取其他属性的值,如下所示 −
SVCClf.predict([[-0.5,-0.8]])
输出
array([1])
示例
SVCClf.n_support_
输出
array([1, 1])
示例
SVCClf.support_vectors_
输出
array(
   [
      [-1., -1.],
      [ 1., 1.]
   ]
)
示例
SVCClf.support_
输出
array([0, 2])
示例
SVCClf.intercept_
输出
array([-0.])
示例
SVCClf.fit_status_
输出
0
NuSVC
NuSVC 是 Nu 支持向量分类器。它是 scikit-learn 提供的另一个可以执行多类分类的类。它与 SVC 类似,但 NuSVC 接受的参数略有不同。与 SVC 不同的参数如下 −
nu − 浮点型,可选,默认值 = 0.5
它表示训练误差分数的上限和支持向量分数的下限。其值应在 (o,1) 区间内。
其余参数和属性与 SVC 相同。
实现示例
我们也可以使用 sklearn.svm.NuSVC 类实现相同的示例。
import numpy as np
X = np.array([[-1, -1], [-2, -1], [1, 1], [2, 1]])
y = np.array([1, 1, 2, 2])
from sklearn.svm import NuSVC
NuSVCClf = NuSVC(kernel = 'linear',gamma = 'scale', shrinking = False,)
NuSVCClf.fit(X, y)
输出
NuSVC(cache_size = 200, class_weight = None, coef0 = 0.0,
   decision_function_shape = 'ovr', degree = 3, gamma = 'scale', kernel = 'linear',
   max_iter = -1, nu = 0.5, probability = False, random_state = None,
   shrinking = False, tol = 0.001, verbose = False)
我们可以像 SVC 一样获得其余属性的输出。
LinearSVC
它是线性支持向量分类 (SVC)。它类似于核函数为"linear"的 SVC。它们之间的区别在于 LinearSVC 使用 liblinear 实现,而 SVC 使用 libsvm 实现。这就是为什么 LinearSVC 在惩罚和损失函数的选择上具有更大的灵活性。它还可以更好地扩展到大量样本。
如果我们谈论它的参数和属性,那么它不支持"kernel",因为它被假定为线性的,并且它还缺少一些属性,例如support_、support_vectors_、n_support_、fit_status_和dual_coef_。
但是,它支持penalty和loss参数,如下所示 −
penalty − 字符串,L1 或 L2(默认值 = 'L2')
此参数用于指定惩罚(正则化)中使用的范数(L1 或 L2)。
loss −字符串,hinge,squared_hinge(默认值 = squared_hinge)
它表示损失函数,其中'hinge'是标准SVM损失函数,'squared_hinge'是hinge损失函数的平方。
实现示例
以下Python脚本使用sklearn.svm.LinearSVC类 −
from sklearn.svm import LinearSVC
from sklearn.datasets import make_classification
X, y = make_classification(n_features = 4, random_state = 0)
LSVCClf = LinearSVC(dual = False, random_state = 0, penalty = 'l1',tol = 1e-5)
LSVCClf.fit(X, y)
输出
LinearSVC(C = 1.0, class_weight = None, dual = False, fit_intercept = True,
   intercept_scaling = 1, loss = 'squared_hinge', max_iter = 1000,
   multi_class = 'ovr', penalty = 'l1', random_state = 0, tol = 1e-05, verbose = 0)
示例
现在,一旦拟合完成,模型就可以预测新的值,如下所示 −
LSVCClf.predict([[0,0,0,0]])
输出
[1]
示例
对于上述示例,我们可以借助以下 Python 脚本 −
获取权重向量LSVCClf.coef_
输出
[[0. 0. 0.91214955 0.22630686]]
示例
类似地,我们可以借助以下 Python 脚本 − 获取截距值。
LSVCClf.intercept_
输出
[0.26860518]
使用 SVM 进行回归
如前所述,SVM 既可用于分类问题,也可用于回归问题。Scikit-learn 的支持向量分类 (SVC) 方法也可以扩展用于解决回归问题。这种扩展方法称为支持向量回归 (SVR)。
SVM 和 SVR 之间的基本相似性
SVC 创建的模型仅依赖于训练数据的一个子集。为什么?因为用于构建模型的成本函数不关心位于边界之外的训练数据点。
而 SVR(支持向量回归)生成的模型也仅依赖于训练数据的一个子集。为什么?因为用于构建模型的成本函数会忽略任何接近模型预测值的训练数据点。
Scikit-learn 提供了三个类,分别是 SVR、NuSVR 和 LinearSVR,作为 SVR 的三种不同实现。
SVR
它是 Epsilon-support 向量回归,其实现基于 libsvm。与 SVC 相反,该模型中有两个自由参数,分别为 'C' 和 'epsilon'。
epsilon − 浮点型,可选,默认值 = 0.1
它表示 epsilon-SVR 模型中的 epsilon,并指定 epsilon 管,在该管内,训练损失函数中预测点与实际值距离 epsilon 范围内的点不会受到惩罚。
其余参数和属性与 SVC 中使用的类似。
实现示例
以下 Python 脚本使用 sklearn.svm.SVR 类 −
from sklearn import svm
X = [[1, 1], [2, 2]]
y = [1, 2]
SVRReg = svm.SVR(kernel = ’linear’, gamma = ’auto’)
SVRReg.fit(X, y)
输出
SVR(C = 1.0, cache_size = 200, coef0 = 0.0, degree = 3, epsilon = 0.1, gamma = 'auto',
kernel = 'linear', max_iter = -1, shrinking = True, tol = 0.001, verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本 minus; 获得权重向量。
SVRReg.coef_
输出
array([[0.4, 0.4]])
示例
同样,我们可以通过如下方式获取其他属性的值 −
SVRReg.predict([[1,1]])
输出
array([1.1])
类似地,我们也可以获取其他属性的值。
NuSVR
NuSVR 是 Nu 支持向量回归。它与 NuSVC 类似,但 NuSVR 使用参数 nu 来控制支持向量的数量。此外,与 NuSVC 中 nu 替换 C 参数不同,这里它替换了 epsilon。
实现示例
以下 Python 脚本使用 sklearn.svm.SVR 类 −
from sklearn.svm import NuSVR
import numpy as np
n_samples, n_features = 20, 15
np.random.seed(0)
y = np.random.randn(n_samples)
X = np.random.randn(n_samples, n_features)
NuSVRReg = NuSVR(kernel = 'linear', gamma = 'auto',C = 1.0, nu = 0.1)^M
NuSVRReg.fit(X, y)
输出
NuSVR(C = 1.0, cache_size = 200, coef0 = 0.0, degree = 3, gamma = 'auto',
   kernel = 'linear', max_iter = -1, nu = 0.1, shrinking = True, tol = 0.001,
   verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本 − 获取权重向量
NuSVRReg.coef_
输出
array(
   [
      [-0.14904483, 0.04596145, 0.22605216, -0.08125403, 0.06564533,
      0.01104285, 0.04068767, 0.2918337 , -0.13473211, 0.36006765,
      -0.2185713 , -0.31836476, -0.03048429, 0.16102126, -0.29317051]
   ]
)
类似地,我们也可以获取其他属性的值。
LinearSVR
它是线性支持向量回归 (SVR)。它类似于核函数为"linear"的 SVR。它们之间的区别在于 LinearSVR 是基于 liblinear 实现的,而 SVC 是基于 libsvm 实现的。这就是为什么 LinearSVR 在惩罚函数和损失函数的选择上具有更大的灵活性。它还可以更好地扩展到大量样本。
如果我们谈论它的参数和属性,那么它不支持"kernel",因为它被假定为线性的,并且它还缺少一些属性,例如support_、support_vectors_、n_support_、fit_status_和dual_coef_。
但是,它支持"loss"参数,如下所示 −
loss −字符串,可选,默认值 = 'epsilon_insensitive'
它表示损失函数,其中 epsilon_insensitive 损失为 L1 损失,平方 epsilon-insensitive 损失为 L2 损失。
实现示例
以下 Python 脚本使用 sklearn.svm.LinearSVR 类 −
from sklearn.svm import LinearSVR
from sklearn.datasets import make_regression
X, y = make_regression(n_features = 4, random_state = 0)
LSVRReg = LinearSVR(dual = False, random_state = 0,
loss = 'squared_epsilon_insensitive',tol = 1e-5)
LSVRReg.fit(X, y)
输出
LinearSVR(
   C=1.0, dual=False, epsilon=0.0, fit_intercept=True,
   intercept_scaling=1.0, loss='squared_epsilon_insensitive',
   max_iter=1000, random_state=0, tol=1e-05, verbose=0
)
示例
现在,一旦拟合完成,模型可以预测新的值,如下所示:−
LSRReg.predict([[0,0,0,0]])
输出
array([-0.01041416])
示例
对于上述示例,我们可以借助以下 Python 脚本获取权重向量:−
LSRReg.coef_
输出
array([20.47354746, 34.08619401, 67.23189022, 87.47017787])
示例
类似地,我们可以借助以下 Python 脚本获取截距值 −
LSRReg.intercept_
输出
array([-0.01041416])

