
Scikit Learn - 估算器 API
在本章中,我们将学习估算器 API(应用程序编程接口)。首先,让我们了解一下什么是估算器 API。
什么是估算器 API
它是 Scikit-learn 实现的主要 API 之一。它为各种机器学习应用程序提供了一致的接口,因此 Scikit-Learn 中的所有机器学习算法都是通过估算器 API 实现的。从数据中学习(拟合数据)的对象是估算器。它可以与任何算法(例如分类、回归、聚类)一起使用,甚至可以与转换器一起使用,从原始数据中提取有用的特征。
为了拟合数据,所有估计器对象都公开了一个 fit 方法,该方法接受如下所示的数据集 -
estimator.fit(data)
接下来,当通过相应的属性实例化估计器时,可以按如下方式设置其所有参数。
estimator = Estimator (param1=1, param2=2)
estimator.param1
上述代码的输出为 1。
一旦数据与估计器拟合,就可以根据手头的数据估计参数。现在,所有估计的参数都将成为以下划线结尾的估计器对象的属性,如下所示 −
estimator.estimated_param_
Estimator API 的使用
估计器的主要用途如下 −
模型的估计和解码
Estimator 对象用于模型的估计和解码。此外,该模型被估计为以下 − 的确定性函数。
对象构造过程中提供的参数。
如果估计器的 random_state 参数设置为 none,则为全局随机状态 (numpy.random)。
传递给最近一次调用 fit、fit_transform 或 fit_predict 的任何数据。
在一系列调用 partial_fit 的过程中传递的任何数据。
将非矩形数据表示映射到矩形数据
它将非矩形数据表示映射到矩形数据。简而言之,它接收输入,其中每个样本并非表示为固定长度的数组对象,并为每个样本生成一个包含特征的数组对象。
核心样本和异常样本之间的区别
它使用以下方法对核心样本和异常样本之间的区别进行建模 −
适合
fit_predict(如果是传导性的)
预测是否归纳
指导原则
在设计 Scikit-Learn API 时,请牢记以下指导原则 −
一致性
该原则规定所有对象应共享从一组有限的方法中提取的公共接口。文档也应保持一致。
有限的对象层次结构
这条指导原则是−
算法应使用 Python 类表示
数据集应采用标准格式表示,例如 NumPy 数组、Pandas DataFrames、SciPy 稀疏矩阵。
参数名称应使用标准 Python 字符串。
组合
众所周知,机器学习算法可以表示为许多基本算法的序列。 Scikit-learn 会在需要时使用这些基本算法。
合理的默认值
根据此原则,每当机器学习模型需要用户指定的参数时,Scikit-learn 库都会定义一个合适的默认值。
检查
根据此指导原则,每个指定的参数值都作为公共属性公开。
使用 Estimator API 的步骤
以下是使用 Scikit-Learn Estimator API 的步骤 −
步骤 1:选择模型类别
在第一步中,我们需要选择模型类别。这可以通过从 Scikit-learn 导入相应的 Estimator 类来完成。
步骤 2:选择模型超参数
在此步骤中,我们需要选择类模型超参数。这可以通过使用所需值实例化类来完成。
步骤 3:整理数据
接下来,我们需要将数据整理成特征矩阵 (X) 和目标向量 (y)。
步骤 4:模型拟合
现在,我们需要将模型拟合到您的数据中。这可以通过调用模型实例的 fit() 方法来完成。
步骤 5:应用模型
拟合模型后,我们可以将其应用于新数据。对于监督学习,使用 predict() 方法预测未知数据的标签。而对于无监督学习,则使用 predict() 或 transform() 来推断数据的属性。
监督学习示例
这里,我们以将 (x,y) 数据拟合成直线的常见情况为例,即简单线性回归。
首先,我们需要加载数据集,我们使用鸢尾花数据集 −
示例
导入 seaborn 为 sns
iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
输出
(150, 4)
示例
y_iris = iris['species']
y_iris.shape
输出
(150,)
示例
现在,对于此回归示例,我们将使用以下示例数据−
%matplotlib inline
导入 matplotlib.pyplot 作为 plt
导入 numpy 作为 np
rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
输出
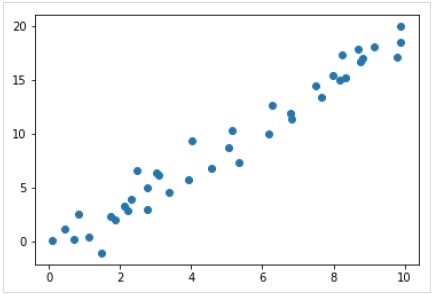
现在,我们有了上述线性回归示例的数据。
现在,有了这些数据,我们可以应用上述步骤。
选择模型类别
为了计算一个简单的线性回归模型,我们需要导入线性回归类,如下所示 −
from sklearn.linear_model import LinearRegression
选择模型超参数
一旦我们选择了模型类别,我们就需要做出一些重要的选择,这些选择通常表示为超参数,或者说是在模型拟合数据之前必须设置的参数。在本例中,对于线性回归,我们希望使用 fit_intercept 超参数拟合截距,如下所示 −
示例
model = LinearRegression(fit_intercept = True)
model
输出
LinearRegression(copy_X = True, fit_intercept = True, n_jobs = None, normalize = False)
整理数据
现在,我们知道目标变量 y 的形式正确,即一个长度为 n_samples 个的一维数组。但是,我们需要重塑特征矩阵 X,使其成为大小为 [n_samples, n_features] 的矩阵。具体操作如下:−
示例
X = x[:, np.newaxis]
X.shape
输出
(40, 1)
模型拟合
一旦我们整理好数据,就该进行模型拟合了,即将模型应用于数据。这可以借助 fit() 方法实现,如下所示 −
示例
model.fit(X, y)
输出
LinearRegression(copy_X = True, fit_intercept = True, n_jobs = None,normalize = False)
在 Scikit-learn 中,fit() 函数末尾有一些下划线。
在本例中,以下参数显示了数据简单线性拟合的斜率 −
示例
model.coef_
输出
array([1.99839352])
以下参数表示对数据的简单线性拟合的截距 -
示例
model.intercept_
输出
-0.9895459457775022
将模型应用于新数据
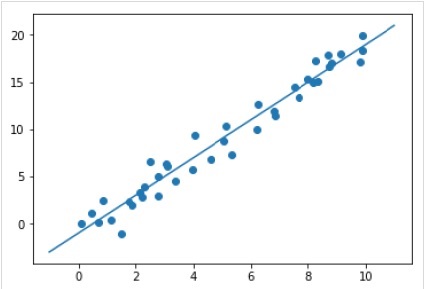
训练模型后,我们可以将其应用于新数据。监督机器学习的主要任务是基于不属于训练集的新数据来评估模型。可以借助 predict() 方法完成,如下所示 −
示例
xfit = np.linspace(-1, 11)
Xfit = xfit[:, np.newaxis]
yfit = model.predict(Xfit)
plt.scatter(x, y)
plt.plot(xfit, yfit);
输出
完整的可运行/可执行示例
%matplotlib inline
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
y_iris = iris['species']
y_iris.shape

rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
from sklearn.linear_model import LinearRegression
model = LinearRegression(fit_intercept=True)
model
X = x[:, np.newaxis]
X.shape

model.fit(X, y)
model.coef_
model.intercept_

xfit = np.linspace(-1, 11)
Xfit = xfit[:, np.newaxis]
yfit = model.predict(Xfit)
plt.scatter(x, y)
plt.plot(xfit, yfit);
无监督学习示例
这里,我们以鸢尾花数据集的常见降维情况为例,以便更轻松地进行可视化。在本例中,我们将使用主成分分析 (PCA),这是一种快速线性降维技术。
与上面给出的示例类似,我们可以加载并绘制鸢尾花数据集中的随机数据。之后,我们可以按照以下步骤操作 −
选择模型类别
from sklearn.decomposition import PCA
选择模型超参数
示例
model = PCA(n_components=2)
model
输出
PCA(copy = True, iterated_power = 'auto', n_components = 2, random_state = None,
   svd_solver = 'auto', tol = 0.0, whiten = False)
模型拟合
示例
model.fit(X_iris)
输出
PCA(copy = True, iterated_power = 'auto', n_components = 2, random_state = None,
svd_solver = 'auto', tol = 0.0, whiten = False)
将数据转换为二维
示例
X_2D = model.transform(X_iris)
现在,我们可以将结果绘制如下图所示 −
输出
iris['PCA1'] = X_2D[:, 0]
iris['PCA2'] = X_2D[:, 1]
sns.lmplot("PCA1", "PCA2", hue = 'species', data = iris, fit_reg = False);
输出

完整的可运行/可执行示例
%matplotlib inline
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
y_iris = iris['species']
y_iris.shape
rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
from sklearn.decomposition import PCA

model = PCA(n_components=2)
model
model.fit(X_iris)
X_2D = model.transform(X_iris)
iris['PCA1'] = X_2D[:, 0]
iris['PCA2'] = X_2D[:, 1]
sns.lmplot("PCA1", "PCA2", hue='species', data=iris, fit_reg=False);

