
Scikit Learn - 快速指南
Scikit Learn - 简介
在本章中,我们将了解什么是 Scikit-Learn 或 Sklearn、Scikit-Learn 的起源以及其他一些相关主题,例如负责开发和维护 Scikit-Learn 的社区和贡献者、其前提条件、安装及其功能。
什么是 Scikit-Learn (Sklearn)
Scikit-learn (Sklearn) 是 Python 中最实用、最强大的机器学习库。它通过 Python 的一致性接口提供了一系列高效的机器学习和统计建模工具,包括分类、回归、聚类和降维。这个库主要用 Python 编写,基于 NumPy、SciPy 和 Matplotlib 构建。
Scikit-Learn 的起源
它最初名为 scikits.learn,最初由 David Cournapeau 于 2007 年作为 Google Summer of Code 项目开发。后来,在 2010 年,来自法国计算机科学与自动化研究所 (FIRCA) 的 Fabian Pedregosa、Gael Varoquaux、Alexandre Gramfort 和 Vincent Michel 将这个项目提升到了一个新的水平,并于 2010 年 2 月 1 日发布了第一个公开版本 (v0.1 beta)。
让我们来看看它的版本历史 −
2019 年 5 月:scikit-learn 0.21.0
2019 年 3 月:scikit-learn 0.20.3
2018 年 12 月:scikit-learn 0.20.2
2018 年 11 月:scikit-learn 0.20.1
2018 年 9 月:scikit-learn 0.20.0
2018 年 7 月:scikit-learn 0.19.2
2017 年 7 月:scikit-learn 0.19.0
2016 年 9 月:scikit-learn 0.18.0
2015 年 11 月。scikit-learn 0.17.0
2015 年 3 月。scikit-learn 0.16.0
2014 年 7 月。scikit-learn 0.15.0
2013 年 8 月。scikit-learn 0.14
社区与贡献者
Scikit-learn 是一项社区努力,任何人都可以为其做出贡献。该项目托管于 https://github.com/scikit-learn/scikit-learn。以下人员目前是 Sklearn 开发和维护的核心贡献者 −
Joris Van den Bossche(数据科学家)
Thomas J Fan(软件开发人员)
Alexandre Gramfort(机器学习研究员)
Olivier Grisel(机器学习专家)
Nicolas Hug(助理研究员)
Andreas Mueller(机器学习科学家)
Hanmin Qin(软件工程师)
Adrin Jalali(开源开发者)
Nelle Varoquaux(数据科学研究员)
Roman Yurchak(数据科学家)
Booking.com、JP Morgan、Evernote、Inria、AWeber、Spotify 等众多机构都在使用 Sklearn。
先决条件
在开始使用 scikit-learn 最新版本之前,我们需要以下 −
Python (>=3.5)
NumPy (>= 1.11.0)
Scipy (>= 0.17.0)li
Joblib (>= 0.11)
Sklearn 绘图功能需要 Matplotlib (>= 1.5.1)。
部分使用数据结构和分析的 scikit-learn 示例需要 Pandas (>= 0.18.0)。
安装
如果您已经安装了 NumPy 和 Scipy,以下是两种安装 scikit-learn 的最简单方法 −
使用 pip
以下命令可通过 pip − 安装 scikit-learn
pip install -U scikit-learn
使用 conda
以下命令可通过 conda − 安装 scikit-learn
conda install scikit-learn
另一方面,如果您的 Python 工作站上尚未安装 NumPy 和 Scipy,则可以使用 pip 或 conda 安装它们。
使用 scikit-learn 的另一种选择是使用 Python 发行版,例如 Canopy 和 Anaconda,因为它们都附带scikit-learn 的最新版本。
功能
Scikit-learn 库专注于数据建模,而非加载、操作和汇总数据。Sklearn 提供的一些最流行的模型组如下 −
监督学习算法 − 几乎所有流行的监督学习算法,例如线性回归、支持向量机 (SVM)、决策树等,都是 scikit-learn 的一部分。
无监督学习算法 − 另一方面,它也包含所有流行的无监督学习算法,从聚类、因子分析、PCA(主成分分析)到无监督神经网络。
聚类 −此模型用于对未标记数据进行分组。
交叉验证 − 用于检查监督模型对未见数据的准确性。
降维 − 用于减少数据中的属性数量,以便进一步用于汇总、可视化和特征选择。
集成方法 − 顾名思义,它用于组合多个监督模型的预测。
特征提取 − 用于从数据中提取特征以定义图像和文本数据中的属性。
特征选择 − 用于识别有用的属性以创建监督模型。
开源 −它是一个开源库,也可在 BSD 许可下用于商业用途。
Scikit Learn - 建模过程
本章介绍 Sklearn 中的建模过程。让我们详细了解该过程,并从数据集加载开始。
数据集加载
数据集合称为数据集。它包含以下两个组成部分:−
特征 − 数据的变量称为特征。它们也称为预测变量、输入或属性。
特征矩阵 − 如果有多个特征,则为特征的集合。
特征名称 − 是所有特征名称的列表。
响应 − 是输出变量,主要依赖于特征变量。它们也称为目标、标签或输出。
响应向量 − 用于表示响应列。通常,我们只有一个响应列。
目标名称 − 表示响应向量可能取的值。
Scikit-learn 有一些示例数据集,例如用于分类的 iris 和 digits,以及用于回归的 Boston house prices。
示例
以下是加载 iris 数据集的示例 −
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
feature_names = iris.feature_names
target_names = iris.target_names
print("Feature names:", feature_names)
print("Target names:", target_names)
print("
First 10 rows of X:
", X[:10])
输出
Feature names: ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
Target names: ['setosa' 'versicolor' 'virginica']
First 10 rows of X:
[
   [5.1 3.5 1.4 0.2]
   [4.9 3. 1.4 0.2]
   [4.7 3.2 1.3 0.2]
   [4.6 3.1 1.5 0.2]
   [5. 3.6 1.4 0.2]
   [5.4 3.9 1.7 0.4]
   [4.6 3.4 1.4 0.3]
   [5. 3.4 1.5 0.2]
   [4.4 2.9 1.4 0.2]
   [4.9 3.1 1.5 0.1]
]
分割数据集
为了检查模型的准确性,我们可以将数据集分成两部分:训练集和测试集。使用训练集训练模型,使用测试集测试模型。之后,我们可以评估模型的表现。
示例
以下示例将数据按 70:30 的比例分割,即 70% 的数据将用作训练数据,30% 的数据将用作测试数据。数据集是如上例所示的鸢尾花数据集。
from sklearn.datasets import load_iris
iris = load_iris()

X = iris.data
y = iris.target

from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
   X, y, test_size = 0.3, random_state = 1
)

print(X_train.shape)
print(X_test.shape)

print(y_train.shape)
print(y_test.shape)
输出
(105, 4)
(45, 4)
(105,)
(45,)
如上例所示,它使用 scikit-learn 的 train_test_split() 函数来分割数据集。该函数包含以下参数 −
X, y − 其中,X 是特征矩阵,y 是响应向量,需要进行分割。
test_size − 表示测试数据占给定数据总量的比例。如上例所示,我们为 X 的 150 行设置 test_data = 0.3。它将生成 150*0.3 = 45 行的测试数据。
random_size − 用于保证拆分始终相同。这在需要可重复结果的情况下非常有用。
训练模型
接下来,我们可以使用数据集来训练一些预测模型。如上所述,scikit-learn 拥有丰富的机器学习 (ML) 算法,这些算法具有一致的接口,可用于拟合、预测准确率、召回率等。
示例
在下面的示例中,我们将使用 KNN(K 最近邻)分类器。无需深入探讨 KNN 算法的细节,因为后面会专门有一章来介绍。本示例仅用于帮助您理解具体实现部分。
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
   X, y, test_size = 0.4, random_state=1
)
from sklearn.neighbors import KNeighborsClassifier
from sklearn import metrics
classifier_knn = KNeighborsClassifier(n_neighbors = 3)
classifier_knn.fit(X_train, y_train)
y_pred = classifier_knn.predict(X_test)
# 通过比较实际响应值 (y_test) 和预测响应值 (y_pred) 来计算准确率
print("Accuracy:", metrics.accuracy_score(y_test, y_pred))
# 提供样本数据,模型将根据该数据进行预测

sample = [[5, 5, 3, 2], [2, 4, 3, 5]]
preds = classifier_knn.predict(sample)
pred_species = [iris.target_names[p] for p in preds] print("Predictions:", pred_species)
输出
Accuracy: 0.9833333333333333
Predictions: ['versicolor', 'virginica']
模型持久化
模型训练完成后,最好将其持久化以供将来使用,这样就无需反复训练。这可以借助 joblib 包中的 dump 和 load 功能来实现。
请考虑以下示例,我们将保存上述训练好的模型 (classifier_knn) 以供将来使用 −
from sklearn.externals import joblib
joblib.dump(classifier_knn, 'iris_classifier_knn.joblib')
上述代码将模型保存到名为 iris_classifier_knn.joblib 的文件中。现在,可以使用以下代码从文件中重新加载对象 −
joblib.load('iris_classifier_knn.joblib')
数据预处理
由于我们处理的是大量原始数据,因此在将数据输入机器学习算法之前,我们需要将其转换为有意义的数据。此过程称为数据预处理。Scikit-learn 有一个名为 preprocessing 的包用于此目的。preprocessing 包包含以下技术 −
二值化
当我们需要将数值转换为布尔值时,可以使用此预处理技术。
示例
import numpy as np
from sklearn import preprocessing
Input_data = np.array(
   [2.1, -1.9, 5.5],
   [-1.5, 2.4, 3.5],
   [0.5, -7.9, 5.6],
   [5.9, 2.3, -5.8]]
)
data_binarized = preprocessing.Binarizer(threshold=0.5).transform(input_data)
print("
Binarized data:
", data_binarized)
在上面的例子中,我们使用了阈值 = 0.5,因此所有高于 0.5 的值都会转换为 1,而所有低于 0.5 的值都会转换为 0。
输出
Binarized data:
[
   [ 1. 0. 1.]
   [ 0. 1. 1.]
   [ 0. 0. 1.]
   [ 1. 1. 0.]
]
均值消除
此技术用于消除特征向量中的均值,使每个特征都以零为中心。
示例
import numpy as np
from sklearn import preprocessing
Input_data = np.array(
   [2.1, -1.9, 5.5],
   [-1.5, 2.4, 3.5],
   [0.5, -7.9, 5.6],
   [5.9, 2.3, -5.8]]
)

#显示输入数据的平均值和标准差
print("Mean=", input_data.mean(axis=0))
print("Stddeviation = ", input_data.std(axis=0))
#去除输入数据的平均值和标准差

data_scaled = preprocessing.scale(input_data)
print("Mean_removed=", data_scaled.mean(axis=0))
print("Stddeviation_removed=", data_scaled.std(axis=0))
输出
Mean = [ 1.75 -1.275 2.2 ]
Stddeviation = [ 2.71431391 4.20022321 4.69414529]
Mean_removed = [ 1.11022302e-16 0.00000000e+00 0.00000000e+00]
Stddeviation_removed = [ 1. 1. 1.]
缩放
我们使用这种预处理技术来缩放特征向量。特征向量的缩放非常重要,因为特征不应该合成地过大或过小。
示例
import numpy as np
from sklearn import preprocessing
Input_data = np.array(
   [
      [2.1, -1.9, 5.5],
      [-1.5, 2.4, 3.5],
      [0.5, -7.9, 5.6],
      [5.9, 2.3, -5.8]
   ]
)
data_scaler_minmax = preprocessing.MinMaxScaler(feature_range=(0,1))
data_scaled_minmax = data_scaler_minmax.fit_transform(input_data)
print ("
Min max scaled data:
", data_scaled_minmax)
输出
Min max scaled data:
[
   [ 0.48648649 0.58252427 0.99122807]
   [ 0. 1. 0.81578947]
   [ 0.27027027 0. 1. ]
   [ 1. 0.99029126 0. ]
]
归一化
我们使用这种预处理技术来修改特征向量。为了使特征向量能够以通用尺度进行测量,必须对特征向量进行归一化。归一化有两种类型:−
L1 归一化
它也被称为最小绝对值偏差。它以这样的方式修改值,使每行的绝对值之和始终保持在 1 以内。以下示例展示了对输入数据实施 L1 归一化的方法。
示例
import numpy as np
from sklearn import preprocessing
Input_data = np.array(
   [
      [2.1, -1.9, 5.5],
      [-1.5, 2.4, 3.5],
      [0.5, -7.9, 5.6],
      [5.9, 2.3, -5.8]
   ]
)
data_normalized_l1 = preprocessing.normalize(input_data, norm='l1')
print("
L1 normalized data:
", data_normalized_l1)
输出
L1 normalized data:
[
   [ 0.22105263 -0.2 0.57894737]
   [-0.2027027 0.32432432 0.47297297]
   [ 0.03571429 -0.56428571 0.4 ]
   [ 0.42142857 0.16428571 -0.41428571]
]
L2 正则化
也称为最小二乘法。它以某种方式修改值,使每行的平方和始终保持在 1 左右。以下示例展示了如何对输入数据进行 L2 正则化。
示例
import numpy as np
from sklearn import preprocessing
Input_data = np.array(
   [
      [2.1, -1.9, 5.5],
      [-1.5, 2.4, 3.5],
      [0.5, -7.9, 5.6],
      [5.9, 2.3, -5.8]
   ]
)
data_normalized_l2 = preprocessing.normalize(input_data, norm='l2')
print("
L1 normalized data:
", data_normalized_l2)
输出
L2 normalized data:
[
   [ 0.33946114 -0.30713151 0.88906489]
   [-0.33325106 0.53320169 0.7775858 ]
   [ 0.05156558 -0.81473612 0.57753446]
   [ 0.68706914 0.26784051 -0.6754239 ]
]
Scikit Learn - 数据表示
众所周知,机器学习的核心是从数据中创建模型。为此,计算机必须首先理解数据。接下来,我们将讨论各种表示数据的方式,以便计算机能够理解 −
数据以表格形式呈现
在 Scikit-learn 中,表格是数据表示的最佳方式。表格表示二维数据网格,其中行表示数据集中的各个元素,列表示与这些各个元素相关的数量。
示例
通过以下示例,我们可以借助 Python seaborn 库,以 Pandas DataFrame 的形式下载 iris 数据集。
import seaborn as sns
iris = sns.load_dataset('iris')
iris.head()
输出
sepal_length sepal_width petal_length petal_width  species
0        5.1      3.5         1.4             0.2   setosa
1        4.9      3.0         1.4             0.2   setosa
2        4.7      3.2         1.3             0.2   setosa
3        4.6      3.1         1.5             0.2   setosa
4        5.0      3.6         1.4             0.2   setosa
从上面的输出中,我们可以看到数据的每一行代表一朵观察到的花,行数代表数据集中花的总数。通常,我们将矩阵的行称为样本。
另一方面,数据的每一列代表描述每个样本的定量信息。通常,我们将矩阵的列称为特征。
数据作为特征矩阵
特征矩阵可以定义为表格布局,其中信息可以被认为是一个二维矩阵。它存储在名为 X 的变量中,并假定为二维矩阵,形状为 [n_samples, n_features]。通常,它包含在 NumPy 数组或 Pandas DataFrame 中。如前所述,样本始终代表数据集中描述的单个对象,而特征则代表以定量方式描述每个样本的不同观测值。
数据作为目标数组
除了特征矩阵(用 X 表示)之外,我们还有一个目标数组。它也被称为标签。用 y 表示。标签或目标数组通常是一维的,长度为 n_samples。它通常包含在 NumPy 数组 或 Pandas Series 中。目标数组可能包含连续数值和离散值。
目标数组与特征列有何不同?
我们可以通过一点来区分两者:目标数组通常是我们想要从数据中预测的数量,即从统计学角度来看,它是因变量。
示例
在下面的示例中,我们根据鸢尾花数据集中的其他测量值来预测花的种类。在本例中,"种类"列将被视为特征。
import seaborn as sns
iris = sns.load_dataset('iris')
%matplotlib inline
import seaborn as sns; sns.set()
sns.pairplot(iris, hue='species', height=3);
输出
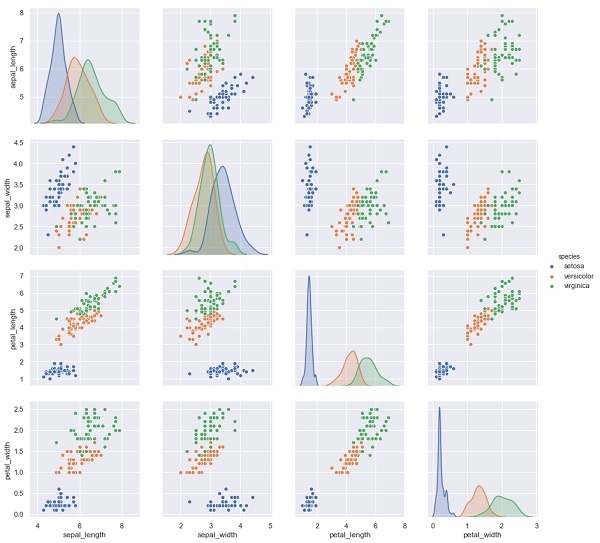
X_iris = iris.drop('species', axis=1)
X_iris.shape
y_iris = iris['species']
y_iris.shape
输出
(150,4)
(150,)
Scikit Learn - 估算器 API
在本章中,我们将学习估算器 API(应用程序编程接口)。首先,让我们了解一下什么是估算器 API。
什么是估算器 API
它是 Scikit-learn 实现的主要 API 之一。它为各种机器学习应用程序提供了一致的接口,因此 Scikit-Learn 中的所有机器学习算法都是通过估算器 API 实现的。从数据中学习(拟合数据)的对象是估算器。它可以与任何算法(例如分类、回归、聚类)一起使用,甚至可以与转换器一起使用,从原始数据中提取有用的特征。
为了拟合数据,所有估计器对象都公开了一个 fit 方法,该方法接受如下所示的数据集 -
estimator.fit(data)
接下来,当通过相应的属性实例化估计器时,可以按如下方式设置其所有参数。
estimator = Estimator (param1=1, param2=2)
estimator.param1
上述代码的输出为 1。
一旦数据与估计器拟合,就可以根据手头的数据估计参数。现在,所有估计的参数都将成为以下划线结尾的估计器对象的属性,如下所示 −
estimator.estimated_param_
Estimator API 的使用
估计器的主要用途如下 −
模型的估计和解码
Estimator 对象用于模型的估计和解码。此外,该模型被估计为以下 − 的确定性函数。
对象构造过程中提供的参数。
如果估计器的 random_state 参数设置为 none,则为全局随机状态 (numpy.random)。
传递给最近一次调用 fit、fit_transform 或 fit_predict 的任何数据。
在一系列调用 partial_fit 的过程中传递的任何数据。
将非矩形数据表示映射到矩形数据
它将非矩形数据表示映射到矩形数据。简而言之,它接收输入,其中每个样本并非表示为固定长度的数组对象,并为每个样本生成一个包含特征的数组对象。
核心样本和异常样本之间的区别
它使用以下方法对核心样本和异常样本之间的区别进行建模 −
适合
fit_predict(如果是传导性的)
预测是否归纳
指导原则
在设计 Scikit-Learn API 时,请牢记以下指导原则 −
一致性
该原则规定所有对象应共享从一组有限的方法中提取的公共接口。文档也应保持一致。
有限的对象层次结构
这条指导原则是−
算法应使用 Python 类表示
数据集应采用标准格式表示,例如 NumPy 数组、Pandas DataFrames、SciPy 稀疏矩阵。
参数名称应使用标准 Python 字符串。
组合
众所周知,机器学习算法可以表示为许多基本算法的序列。 Scikit-learn 会在需要时使用这些基本算法。
合理的默认值
根据此原则,每当机器学习模型需要用户指定的参数时,Scikit-learn 库都会定义一个合适的默认值。
检查
根据此指导原则,每个指定的参数值都作为公共属性公开。
使用 Estimator API 的步骤
以下是使用 Scikit-Learn Estimator API 的步骤 −
步骤 1:选择模型类别
在第一步中,我们需要选择模型类别。这可以通过从 Scikit-learn 导入相应的 Estimator 类来完成。
步骤 2:选择模型超参数
在此步骤中,我们需要选择类模型超参数。这可以通过使用所需值实例化类来完成。
步骤 3:整理数据
接下来,我们需要将数据整理成特征矩阵 (X) 和目标向量 (y)。
步骤 4:模型拟合
现在,我们需要将模型拟合到您的数据中。这可以通过调用模型实例的 fit() 方法来完成。
步骤 5:应用模型
拟合模型后,我们可以将其应用于新数据。对于监督学习,使用 predict() 方法预测未知数据的标签。而对于无监督学习,则使用 predict() 或 transform() 来推断数据的属性。
监督学习示例
这里,我们以将 (x,y) 数据拟合成直线的常见情况为例,即简单线性回归。
首先,我们需要加载数据集,我们使用鸢尾花数据集 −
示例
导入 seaborn 为 sns
iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
输出
(150, 4)
示例
y_iris = iris['species']
y_iris.shape
输出
(150,)
示例
现在,对于此回归示例,我们将使用以下示例数据−
%matplotlib inline
导入 matplotlib.pyplot 作为 plt
导入 numpy 作为 np
rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
输出
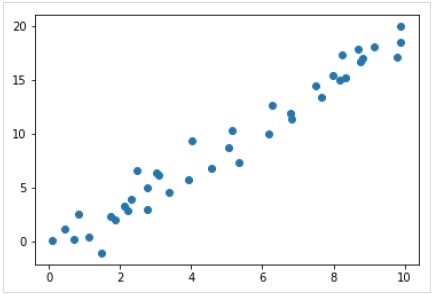
现在,我们有了上述线性回归示例的数据。
现在,有了这些数据,我们可以应用上述步骤。
选择模型类别
为了计算一个简单的线性回归模型,我们需要导入线性回归类,如下所示 −
from sklearn.linear_model import LinearRegression
选择模型超参数
一旦我们选择了模型类别,我们就需要做出一些重要的选择,这些选择通常表示为超参数,或者说是在模型拟合数据之前必须设置的参数。在本例中,对于线性回归,我们希望使用 fit_intercept 超参数拟合截距,如下所示 −
示例
model = LinearRegression(fit_intercept = True)
model
输出
LinearRegression(copy_X = True, fit_intercept = True, n_jobs = None, normalize = False)
整理数据
现在,我们知道目标变量 y 的形式正确,即一个长度为 n_samples 个的一维数组。但是,我们需要重塑特征矩阵 X,使其成为大小为 [n_samples, n_features] 的矩阵。具体操作如下:−
示例
X = x[:, np.newaxis]
X.shape
输出
(40, 1)
模型拟合
一旦我们整理好数据,就该进行模型拟合了,即将模型应用于数据。这可以借助 fit() 方法实现,如下所示 −
示例
model.fit(X, y)
输出
LinearRegression(copy_X = True, fit_intercept = True, n_jobs = None,normalize = False)
在 Scikit-learn 中,fit() 函数末尾有一些下划线。
在本例中,以下参数显示了数据简单线性拟合的斜率 −
示例
model.coef_
输出
array([1.99839352])
以下参数表示对数据的简单线性拟合的截距 -
示例
model.intercept_
输出
-0.9895459457775022
将模型应用于新数据
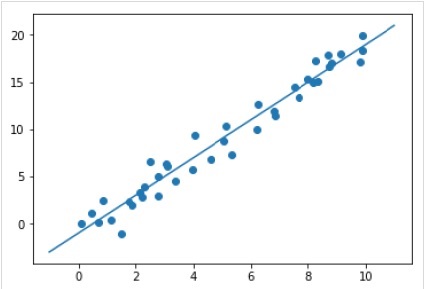
训练模型后,我们可以将其应用于新数据。监督机器学习的主要任务是基于不属于训练集的新数据来评估模型。可以借助 predict() 方法完成,如下所示 −
示例
xfit = np.linspace(-1, 11)
Xfit = xfit[:, np.newaxis]
yfit = model.predict(Xfit)
plt.scatter(x, y)
plt.plot(xfit, yfit);
输出
完整的可运行/可执行示例
%matplotlib inline
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
y_iris = iris['species']
y_iris.shape

rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
from sklearn.linear_model import LinearRegression
model = LinearRegression(fit_intercept=True)
model
X = x[:, np.newaxis]
X.shape

model.fit(X, y)
model.coef_
model.intercept_

xfit = np.linspace(-1, 11)
Xfit = xfit[:, np.newaxis]
yfit = model.predict(Xfit)
plt.scatter(x, y)
plt.plot(xfit, yfit);
无监督学习示例
这里,我们以鸢尾花数据集的常见降维情况为例,以便更轻松地进行可视化。在本例中,我们将使用主成分分析 (PCA),这是一种快速线性降维技术。
与上面给出的示例类似,我们可以加载并绘制鸢尾花数据集中的随机数据。之后,我们可以按照以下步骤操作 −
选择模型类别
from sklearn.decomposition import PCA
选择模型超参数
示例
model = PCA(n_components=2)
model
输出
PCA(copy = True, iterated_power = 'auto', n_components = 2, random_state = None,
   svd_solver = 'auto', tol = 0.0, whiten = False)
模型拟合
示例
model.fit(X_iris)
输出
PCA(copy = True, iterated_power = 'auto', n_components = 2, random_state = None,
svd_solver = 'auto', tol = 0.0, whiten = False)
将数据转换为二维
示例
X_2D = model.transform(X_iris)
现在,我们可以将结果绘制如下图所示 −
输出
iris['PCA1'] = X_2D[:, 0]
iris['PCA2'] = X_2D[:, 1]
sns.lmplot("PCA1", "PCA2", hue = 'species', data = iris, fit_reg = False);
输出

完整的可运行/可执行示例
%matplotlib inline
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

iris = sns.load_dataset('iris')
X_iris = iris.drop('species', axis = 1)
X_iris.shape
y_iris = iris['species']
y_iris.shape
rng = np.random.RandomState(35)
x = 10*rng.rand(40)
y = 2*x-1+rng.randn(40)
plt.scatter(x,y);
from sklearn.decomposition import PCA

model = PCA(n_components=2)
model
model.fit(X_iris)
X_2D = model.transform(X_iris)
iris['PCA1'] = X_2D[:, 0]
iris['PCA2'] = X_2D[:, 1]
sns.lmplot("PCA1", "PCA2", hue='species', data=iris, fit_reg=False);
Scikit Learn - 约定
Scikit-learn 的对象共享统一的基本 API,该 API 由以下三个互补的接口组成 −
Estimator 接口 − 用于构建和拟合模型。
Predictor 接口 − 用于进行预测。
Transformer 接口 − 用于转换数据。
这些 API 采用简单的约定,并且设计选择已避免框架代码的激增。
约定的目的
约定的目的是确保 API 遵循以下主要原则 −
一致性 −所有对象,无论是基本对象还是复合对象,都必须共享一个一致的接口,该接口由一组有限的方法组成。
检查 − 构造函数参数和学习算法确定的参数值应存储并公开为公共属性。
类的非扩散 − 数据集应表示为 NumPy 数组或 Scipy 稀疏矩阵,而超参数名称和值应表示为标准 Python 字符串,以避免框架代码的扩散。
组合 − 算法,无论是可表示为数据转换的序列或组合,还是自然地被视为基于其他算法参数化的元算法,都应由现有构建块实现和组合。
合理的默认值 − 在 scikit-learn 中,每当操作需要用户定义的参数时,都会定义一个适当的默认值。此默认值应使操作以合理的方式执行,例如,为当前任务提供基准解决方案。
各种约定
Sklearn 中可用的约定如下 −
类型转换
它规定输入应转换为 float64。以下示例中,使用 sklearn.random_projection 模块对数据进行降维,−
将对此进行解释。示例
import numpy as np
from sklearn import random_projection
rannge = np.random.RandomState(0)
X = range.rand(10,2000)
X = np.array(X, dtype = 'float32')
X.dtype
Transformer_data = random_projection.GaussianRandomProjection()
X_new = transformer.fit_transform(X)
X_new.dtype
输出
dtype('float32')
dtype('float64')
在上面的例子中,我们可以看到 X 是 float32 类型,它通过 fit_transform(X) 转换为 float64 类型。
重新拟合和更新参数
构建估计器后,可以通过 set_params() 方法更新和重新拟合估计器的超参数。让我们看下面的例子来理解它 −
示例
import numpy as np
from sklearn.datasets import load_iris
from sklearn.svm import SVC
X, y = load_iris(return_X_y = True)
clf = SVC()
clf.set_params(kernel = 'linear').fit(X, y)
clf.predict(X[:5])
输出
array([0, 0, 0, 0, 0])
构建估计器后,上述代码将通过以下方式将默认核rbf更改为线性核SVC.set_params().
现在,以下代码将内核改回 rbf 函数,以重新拟合估计器并进行第二次预测。
示例
clf.set_params(kernel = 'rbf', gamma = 'scale').fit(X, y)
clf.predict(X[:5])
输出
array([0, 0, 0, 0, 0])
完整代码
以下是完整的可执行程序 −
import numpy as np
from sklearn.datasets import load_iris
from sklearn.svm import SVC
X, y = load_iris(return_X_y = True)
clf = SVC()
clf.set_params(kernel = 'linear').fit(X, y)
clf.predict(X[:5])
clf.set_params(kernel = 'rbf', gamma = 'scale').fit(X, y)
clf.predict(X[:5])
多类别和多标签拟合
在多类别拟合的情况下,学习和预测任务都取决于拟合目标数据的格式。使用的模块是 sklearn.multiclass。请查看下面的示例,其中多类分类器适用于一维数组。
示例
from sklearn.svm import SVC
from sklearn.multiclass import OneVsRestClassifier
from sklearn.preprocessing import LabelBinarizer
X = [[1, 2], [3, 4], [4, 5], [5, 2], [1, 1]]
y = [0, 0, 1, 1, 2]
classif = OneVsRestClassifier(estimator = SVC(gamma = 'scale',random_state = 0))
classif.fit(X, y).predict(X)
输出
array([0, 0, 1, 1, 2])
在上面的例子中,分类器适用于多类标签的一维数组,因此 predict() 方法提供了相应的多类预测。但另一方面,也可以对二维二分类标签指标数组进行拟合,如下所示 −
示例
from sklearn.svm import SVC
from sklearn.multiclass import OneVsRestClassifier
from sklearn.preprocessing import LabelBinarizer
X = [[1, 2], [3, 4], [4, 5], [5, 2], [1, 1]]
y = LabelBinarizer().fit_transform(y)
classif.fit(X, y).predict(X)
输出
array(
   [
      [0, 0, 0],
      [0, 0, 0],
      [0, 1, 0],
      [0, 1, 0],
      [0, 0, 0]
   ]
)
类似地,在多标签拟合的情况下,一个实例可以分配多个标签,如下所示 −
示例
from sklearn.preprocessing import MultiLabelBinarizer
y = [[0, 1], [0, 2], [1, 3], [0, 2, 3], [2, 4]]
y = MultiLabelBinarizer().fit_transform(y)
classif.fit(X, y).predict(X)
输出
array(
   [
      [1, 0, 1, 0, 0],
      [1, 0, 1, 0, 0],
      [1, 0, 1, 1, 0],
      [1, 0, 1, 1, 0],
      [1, 0, 1, 0, 0]
   ]
)
在上面的例子中,sklearn.MultiLabelBinarizer 用于对包含多标签的二维数组进行二值化,以便进行拟合。因此,predict() 函数会输出一个二维数组,其中包含每个实例的多个标签。
Scikit Learn - 线性建模
本章将帮助您了解 Scikit-Learn 中的线性建模。首先,让我们了解一下 Sklearn 中的线性回归是什么。
下表列出了 Scikit-Learn 提供的各种线性模型 −
| Sr.No | Model &描述 |
|---|---|
| 1 |
它是研究因变量 (Y) 与给定一组自变量 (X) 之间关系的最佳统计模型之一。 |
| 2 |
尽管名为逻辑回归,但它是一种分类算法,而非回归算法。基于给定的一组独立变量,它用于估计离散值(0 或 1、是/否、真/假)。 |
| 3 |
岭回归或 Tikhonov 正则化是一种执行 L2 正则化的正则化技术。它通过添加相当于系数幅值平方的惩罚项(收缩量)来修改损失函数。 |
| 4 |
贝叶斯回归通过使用概率分布而不是点估计来构建线性回归,提供了一种自然机制,可以应对数据不足或数据分布不均的情况。 |
| 5 |
LASSO 是一种执行 L1 正则化的正则化技术。它通过添加相当于系数绝对值总和的惩罚项(收缩量)来修改损失函数。 |
| 6 |
它允许联合拟合多个回归问题,强制所有回归问题(也称为任务)的选定特征相同。 Sklearn 提供了一个名为 MultiTaskLasso 的线性模型,该模型使用混合 L1、L2 范数进行正则化训练,可以联合估计多元回归问题的稀疏系数。 |
| 7 |
Elastic-Net 是一种正则化回归方法,它线性结合了 Lasso 和 Ridge 回归方法中的惩罚项(即 L1 和 L2)。当存在多个相关特征时,它非常有用。 |
| 8 |
这是一个弹性网络模型,可以联合拟合多个回归问题,强制所有回归问题(也称为任务)的选定特征相同。 |
Scikit Learn - 扩展线性建模
本章重点介绍 Sklearn 中的多项式特征和流水线工具。
多项式特征简介
使用数据的非线性函数训练的线性模型通常能够保持线性方法的快速性能。它还允许它们拟合更广泛的数据。这就是机器学习中使用线性模型(在非线性函数上训练)的原因。
一个例子是,可以通过从系数构建多项式特征来扩展简单的线性回归。
从数学上讲,假设我们有一个标准线性回归模型,那么对于二维数据,它看起来像这样 −
$$Y=W_{0}+W_{1}X_{1}+W_{2}X_{2}$$现在,我们可以将特征组合成二阶多项式,我们的模型将如下所示 −
$$Y=W_{0}+W_{1}X_{1}+W_{2}X_{2}+W_{3}X_{1}X_{2}+W_{4}X_1^2+W_{5}X_2^2$$以上仍然是线性模型。在这里,我们看到,得到的多项式回归属于同一类线性模型,可以用类似的方法求解。
为此,scikit-learn 提供了一个名为 PolynomialFeatures 的模块。该模块将输入数据矩阵转换为给定次数的新数据矩阵。
参数
下表列出了 PolynomialFeatures 模块使用的参数。
| Sr.No | 参数及说明 |
|---|---|
| 1 |
degree − 整数,默认值 = 2 表示多项式特征的次数。 |
| 2 |
interaction_only − 布尔值,默认值 = false 默认情况下,该值为 false,但如果设置为 true,则会生成由大多数次数不同的输入特征乘积而成的特征。此类特征称为交互特征。 |
| 3 |
include_bias −布尔值,默认值 = true 它包含一个偏置列,即所有多项式幂都为零的特征。 |
| 4 |
order − str in {'C', 'F'},默认值 = 'C' 此参数表示稠密情况下输出数组的阶数。 "F"阶意味着计算速度更快,但另一方面,它可能会减慢后续估计器的速度。 |
属性
下表包含 PolynomialFeatures 模块使用的属性
| Sr.No | 属性和说明 |
|---|---|
| 1 |
powers_ −数组,形状为 (n_output_features, n_input_features) 它表示 powers_[i,j] 是第 i 个输出中第 j 个输入的指数。 |
| 2 |
n_input_features _ − int 顾名思义,它给出了输入特征的总数。 |
| 3 |
n_output_features _ − int 顾名思义,它给出了多项式输出特征的总数。 |
实现示例
以下 Python 脚本使用 PolynomialFeatures 转换器将 8 个元素的数组转换为形状为 (4,2) 的负数;
from sklearn.preprocessing import PolynomialFeatures
import numpy as np
Y = np.arange(8).reshape(4, 2)
poly = PolynomialFeatures(degree=2)
poly.fit_transform(Y)
输出
array(
   [
      [ 1., 0., 1., 0., 0., 1.],
      [ 1., 2., 3., 4., 6., 9.],
      [ 1., 4., 5., 16., 20., 25.],
      [ 1., 6., 7., 36., 42., 49.]
   ]
)
使用 Pipeline 工具简化
上述预处理,即将输入数据矩阵转换为给定阶数的新数据矩阵,可以使用 Pipeline 工具简化,这些工具主要用于将多个估计器链接成一个。
示例
以下 Python 脚本使用 Scikit-learn 的 Pipeline 工具简化预处理(将拟合三阶多项式数据)。
#首先,导入必要的软件包。
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
from sklearn.pipeline import Pipeline
import numpy as np

#接下来,创建 Pipeline 工具对象
Stream_model = Pipeline([('poly', PolynomialFeatures(degree=3)), ('linear', LinearRegression(fit_intercept=False))])

#提供数组大小和多项式数据的阶数,以便拟合模型。
x = np.arange(5)
y = 3 - 2 * x + x ** 2 - x ** 3
Stream_model = model.fit(x[:, np.newaxis], y)

#计算输入多项式系数。
Stream_model.named_steps['linear'].coef_
输出
array([ 3., -2., 1., -1.])
以上输出表明,基于多项式特征训练的线性模型能够恢复精确的输入多项式系数。
Scikit Learn - 随机梯度下降
本文,我们将学习 Sklearn 中的一种优化算法,即随机梯度下降 (SGD)。
随机梯度下降 (SGD) 是一种简单而高效的优化算法,用于找到最小化成本函数的函数参数/系数值。换句话说,它用于在凸损失函数(例如 SVM 和 Logistic 回归)下对线性分类器进行判别学习。由于系数的更新是在每个训练实例上执行的,而不是在实例结束时执行,因此它已成功应用于大规模数据集。
SGD 分类器
随机梯度下降 (SGD) 分类器基本上实现了一个简单的 SGD 学习程序,支持各种损失函数和分类惩罚。 Scikit-learn 提供了 SGDClassifier 模块来实现 SGD 分类。
参数
下表列出了 SGDClassifier 模块使用的参数 −
| Sr.No | 参数及说明 |
|---|---|
| 1 |
loss − str,默认值 = 'hinge' 它表示实现时要使用的损失函数。默认值为 'hinge',它将返回一个线性 SVM。其他可用的选项包括 −
|
| 2 |
penalty − str, 'none', 'l2', 'l1', 'elasticnet' 这是模型中使用的正则化项。默认情况下,它是 L2。我们也可以使用 L1 或 'elasticnet',但两者都可能给模型带来稀疏性,因此 L2 无法实现。 |
| 3 |
alpha −浮点型,默认值 = 0.0001 Alpha 是与正则化项相乘的常数,它是一个调整参数,决定了我们要对模型施加多少惩罚。默认值为 0.0001。 |
| 4 |
l1_ratio − 浮点型,默认值 = 0.15 这被称为 ElasticNet 混合参数。其范围是 0 <= l1_ratio <= 1。如果 l1_ratio = 1,则惩罚为 L1 惩罚。如果 l1_ratio = 0,则惩罚项为 L2 惩罚项。 |
| 5 |
fit_intercept − 布尔值,默认值为 True 此参数指定应向决策函数添加一个常数(偏差或截距)。如果设置为 false,则计算中将不使用截距,并且假定数据已经居中。 |
| 6 |
tol − 浮点数或无,可选,默认值 = 1.e-3 此参数表示迭代的停止标准。其默认值为 False,但如果设置为 None,则当𝒍loss > best_loss - tol for n_iter_no_change个连续 epoch 时,迭代将停止。 |
| 7 |
shuffle − 布尔值,可选,默认值 = True 此参数表示我们是否希望在每个 epoch 后对训练数据进行 shuffle。 |
| 8 |
verbose − 整数,默认值 = 0 它表示详细程度。默认值为 0。 |
| 9 |
epsilon − float,默认值 = 0.1 此参数指定不敏感区域的宽度。如果 loss = 'epsilon-insensitive',则当前预测与正确标签之间任何小于阈值的差异都将被忽略。 |
| 10 |
max_iter − int,可选,默认值 = 1000 顾名思义,它表示在迭代次数(即训练数据)中的最大迭代次数。 |
| 11 |
warm_start − bool,可选,默认值 = false 将此参数设置为 True,我们可以重用上一次调用的结果进行拟合初始化。如果选择默认值,即 false,则会擦除上一次的结果。 |
| 12 |
random_state − int,RandomState 实例或 None,可选,默认值 = none 此参数表示生成的伪随机数的种子,用于对数据进行混洗。以下是选项。
|
| 13 |
n_jobs − int 或 none,可选,默认值 = None 它表示在多分类问题中进行 OVA(一对多)计算时要使用的 CPU 数量。默认值为 none,即 1。 |
| 14 |
learning_rate −字符串,可选,默认值 = 'optimal'
|
| 15 |
eta0 − double,默认值 = 0.0 它表示上述学习率选项(即"constant"、"invscalling"或"adaptive")的初始学习率。 |
| 16 |
power_t − idouble,默认值 = 0.5 它是"incscalling"学习率的指数。 |
| 17 |
early_stopping − bool,默认值 = False 此参数表示当验证分数没有提高时,使用提前停止来终止训练。它的默认值为 false,但当设置为 true 时,它会自动将分层的训练数据部分留出作为验证,并在验证分数没有提高时停止训练。 |
| 18 |
validation_fraction − 浮点型,默认值 = 0.1 仅当 early_stopping 为 true 时使用。它表示在提前终止训练数据时,应预留多少比例的训练数据作为验证集。 |
| 19 |
n_iter_no_change − 整数,默认值 = 5 它表示在提前停止之前,算法应运行多少次没有改进的迭代。 |
| 20 |
classs_weight − dict,{class_label: weight} 或 "balanced",或 None,可选 此参数表示与类别相关的权重。如果未提供,则类别的权重应为 1。 |
| 20 |
warm_start − bool,可选,默认值 = false 将此参数设置为 True,我们可以重用上一次拟合调用的结果作为初始化结果。如果选择默认值,即 false,则会清除上一次的结果。 |
| 21 |
average − iBoolean 或 int,可选,默认值 = false 它表示在多分类问题中进行 OVA(一对多)计算时使用的 CPU 数量。默认值为 none,即 1。 |
属性
下表列出了 SGDClassifier 模块使用的属性 −
| Sr.No | 属性和说明 |
|---|---|
| 1 |
coef_ −数组,形状为 (1, n_features),如果 n_classes==2,则为 (n_classes, n_features) 此属性提供分配给特征的权重。 |
| 2 |
intercept_ − 数组,形状为 (1,),如果 n_classes==2,则为 (n_classes,) 它表示决策函数中的独立项。 |
| 3 |
n_iter_ − int 它给出了达到停止标准的迭代次数。 |
实现示例
与其他分类器一样,随机梯度下降 (SGD) 必须使用以下两个数组 − 进行拟合。
一个包含训练样本的数组 X。其大小为 [n_samples, n_features]。
数组 Y 保存目标值,即训练样本的类标签。其大小为 [n_samples]。
示例
以下 Python 脚本使用 SGDClassifier 线性模型 −
import numpy as np
from sklearn import linear_model
X = np.array([[-1, -1], [-2, -1], [1, 1], [2, 1]])
Y = np.array([1, 1, 2, 2])
SGDClf = linear_model.SGDClassifier(max_iter = 1000, tol=1e-3,penalty = "elasticnet")
SGDClf.fit(X, Y)
输出
SGDClassifier(
   alpha = 0.0001, average = False, class_weight = None,
   early_stopping = False, epsilon = 0.1, eta0 = 0.0, fit_intercept = True,
   l1_ratio = 0.15, learning_rate = 'optimal', loss = 'hinge', max_iter = 1000,
   n_iter = None, n_iter_no_change = 5, n_jobs = None, penalty = 'elasticnet',
   power_t = 0.5, random_state = None, shuffle = True, tol = 0.001,
   validation_fraction = 0.1, verbose = 0, warm_start = False
)
示例
现在,一旦拟合完成,模型就可以预测新的值,如下所示: −
SGDClf.predict([[2.,2.]])
输出
array([2])
示例
对于上述示例,我们可以借助以下 Python 脚本获取权重向量 −
SGDClf.coef_
输出
array([[19.54811198, 9.77200712]])
示例
类似地,我们可以借助以下 Python 脚本获取截距的值 −
SGDClf.intercept_
输出
array([10.])
示例
我们可以使用 SGDClassifier.decision_function 获取到超平面的有符号距离,如以下 Python 脚本 −
所示。SGDClf.decision_function([[2., 2.]])
输出
array([68.6402382])
SGD 回归器
随机梯度下降 (SGD) 回归器基本上实现了一个简单的 SGD 学习程序,支持各种损失函数和惩罚项,以拟合线性回归模型。 Scikit-learn 提供了 SGDRegressor 模块来实现 SGD 回归。
参数
SGDRegressor 使用的参数与 SGDClassifier 模块中使用的参数几乎相同。区别在于"loss"参数。SGDRegressor 模块的loss参数的正值如下:−
squared_loss − 指的是普通最小二乘拟合。
huber: SGDRegressor − 通过将平方损失转换为线性损失(超过 epsilon 距离)来校正异常值。 "huber" 的作用是修改"squared_loss",使算法减少对异常值的校正。
epsilon_insensitive − 实际上,它会忽略小于 epsilon 的误差。
squared_epsilon_insensitive − 它与 epsilon_insensitive 相同。唯一的区别是,当超过 epsilon 的容差时,它会变成平方损失。
另一个区别是,名为"power_t"的参数的默认值为 0.25,而不是像 SGDClassifier 中的 0.5。此外,它没有"class_weight"和"n_jobs"参数。
属性
SGDRegressor 的属性也与 SGDClassifier 模块的属性相同。相反,它有三个额外的属性,如下所示 −
average_coef_ − 数组,shape(n_features,)
顾名思义,它提供分配给特征的平均权重。
average_intercept_ − 数组,shape(1,)
顾名思义,它提供平均截距项。
t_ − int
它提供在训练阶段执行的权重更新次数。
注意 −将参数"average"设置为 True 后,average_coef_ 和 average_intercept_ 属性将生效。
实现示例
以下 Python 脚本使用 SGDRegressor 线性模型 −
import numpy as np
from sklearn import linear_model
n_samples, n_features = 10, 5
rng = np.random.RandomState(0)
y = rng.randn(n_samples)
X = rng.randn(n_samples, n_features)
SGDReg =linear_model.SGDRegressor(
   max_iter = 1000,penalty = "elasticnet",loss = 'huber',tol = 1e-3, average = True
)
SGDReg.fit(X, y)
输出
SGDRegressor(
   alpha = 0.0001, average = True, early_stopping = False, epsilon = 0.1,
   eta0 = 0.01, fit_intercept = True, l1_ratio = 0.15,
   learning_rate = 'invscaling', loss = 'huber', max_iter = 1000,
   n_iter = None, n_iter_no_change = 5, penalty = 'elasticnet', power_t = 0.25,
   random_state = None, shuffle = True, tol = 0.001, validation_fraction = 0.1,
   verbose = 0, warm_start = False
)
示例
拟合完成后,我们可以使用以下 Python 脚本 − 来获取权重向量。
SGDReg.coef_
输出
array([-0.00423314, 0.00362922, -0.00380136, 0.00585455, 0.00396787])
示例
类似地,我们可以使用以下 Python 脚本 − 来获取截距的值。
SGReg.intercept_
输出
SGReg.intercept_
示例
我们可以借助以下 Python 脚本获取训练阶段的权重更新次数 −
SGDReg.t_
输出
61.0
SGD 的优缺点
以下是 SGD 的优点 −
随机梯度下降 (SGD) 非常高效。
它非常容易实现,因为有很多代码机会调优。
遵循 SGD 的缺点 −
随机梯度下降 (SGD) 需要多个超参数,例如正则化参数。
它对特征缩放很敏感。
Scikit Learn - 支持向量机
本章介绍一种称为支持向量机 (SVM) 的机器学习方法。
简介
支持向量机 (SVM) 是一种强大而灵活的监督机器学习方法,可用于分类、回归和异常值检测。SVM 在高维空间中非常高效,通常用于分类问题。支持向量机 (SVM) 非常流行,而且内存效率高,因为它们在决策函数中使用训练点的子集。
SVM 的主要目标是将数据集划分为多个类别,以便找到最大边缘超平面 (MMH),这可以通过以下两个步骤完成 −
支持向量机 (SVM) 首先会迭代生成超平面,以最佳方式分离类别。
之后,它会选择能够正确分离类别的超平面。
SVM 中的一些重要概念如下 −
支持向量 − 它们可以定义为最接近超平面的数据点。支持向量有助于确定分割线。
超平面 − 划分具有不同类别的对象集的决策平面或空间。
边距 −不同类别中最近数据点之间两条线的间隙称为边距 (marginal)。
下图将帮助您深入了解 SVM 的这些概念 −
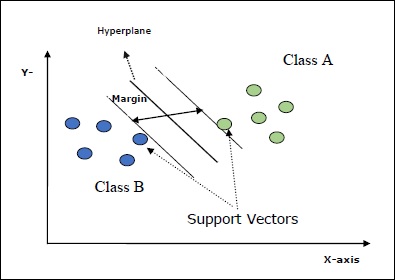
Scikit-learn 中的 SVM 支持稀疏和密集样本向量作为输入。
SVM 的分类
Scikit-learn 提供了三个类,分别是 SVC、NuSVC 和 LinearSVC,它们可以执行多类别分类。
SVC
它是 C 语言支持向量分类器,其实现基于 libsvm。 scikit-learn 使用的模块是 sklearn.svm.SVC。该类根据一对一方案处理多分类支持。
参数
下表列出了 sklearn.svm.SVC 类 − 使用的参数。
| Sr.No | 参数及说明 |
|---|---|
| 1 |
C −浮点型,可选,默认值 = 1.0 这是误差项的惩罚参数。 |
| 2 |
kernel − 字符串,可选,默认值 = 'rbf' 此参数指定算法中使用的核类型。我们可以从'linear'、'poly'、'rbf'、'sigmoid'、'precomputed'中选择任意一种。核的默认值为'rbf'。 |
| 3 |
degree − int,可选,默认值 = 3 它表示"poly"核函数的度数,所有其他核函数都会忽略它。 |
| 4 |
gamma − {'scale', 'auto'} 或浮点型, 这是核函数'rbf'、'poly'和'sigmoid'的核系数。 |
| 5 |
可选默认值 − = 'scale' 如果选择默认值,即 gamma = 'scale',则 SVC 使用的 gamma 值为 1/(𝑛_𝑓𝑒𝑎𝑡𝑢𝑟𝑒𝑠∗𝑋.𝑣𝑎𝑟())。 另一方面,如果 gamma = 'auto',则使用 1/𝑛_𝑓𝑒𝑎𝑡𝑢𝑟𝑒𝑠。 |
| 6 |
coef0 −浮点型,可选,默认值 = 0.0 核函数中的一个独立项,仅在"poly"和"sigmoid"核函数中有效。 |
| 7 |
tol − 浮点型,可选,默认值 = 1.e-3 此参数表示迭代的停止标准。 |
| 8 |
shrinking −布尔值,可选,默认值 = True 此参数表示是否要使用收缩启发式算法。 |
| 9 |
verbose − 布尔值,默认值:false 启用或禁用详细输出。其默认值为 false。 |
| 10 |
probability − 布尔值,可选,默认值 = true 此参数启用或禁用概率估计。默认值为 false,但必须在调用 fit 之前启用。 |
| 11 |
max_iter − int,可选,默认值 = -1 顾名思义,它表示求解器中的最大迭代次数。值 -1 表示迭代次数没有限制。 |
| 12 |
cache_size − float,可选 此参数将指定内核缓存的大小。该值以 MB(兆字节)为单位。 |
| 13 |
random_state − int,RandomState 实例或 None,可选,默认值为 none 此参数表示生成的伪随机数的种子,用于混洗数据。以下是选项 −
|
| 14 |
class_weight − {dict, 'balanced'},可选 此参数将设置类别 j 的参数 C 为 SVC 的 𝑐𝑙𝑎𝑠𝑠_𝑤𝑒𝑖𝑔ℎ𝑡[𝑗]∗𝐶。如果使用默认选项,则意味着所有类别的权重都应该为 1。另一方面,如果选择 class_weight:balanced,它将使用 y 的值自动调整权重。 |
| 15 |
decision_function_shape − ovo', 'ovr',默认值 = 'ovr' 此参数将决定算法是否返回与所有其他分类器形状相同的 'ovr'(一对多)决策函数,还是返回 libsvm 的原始 ovo(一对一)决策函数。 |
| 16 |
break_ties − 布尔值,可选,默认值 = false True − 预测将根据 decision_function 的置信度值打破平局。 False −预测将返回绑定类中的第一个类。 |
属性
下表包含 sklearn.svm.SVC 类 − 使用的属性
| Sr.No | 属性和说明 |
|---|---|
| 1 |
support_ −类似数组,形状 = [n_SV] 返回支持向量的索引。 |
| 2 |
support_vectors_ − 类似数组,形状 = [n_SV, n_features] 返回支持向量。 |
| 3 |
n_support_ −数组类型,dtype=int32,shape = [n_class] 它表示每个类的支持向量数量。 |
| 4 |
dual_coef_ − 数组,shape = [n_class-1,n_SV] 这些是决策函数中支持向量的系数。 |
| 5 |
coef_ − 数组,形状 = [n_class * (n_class-1)/2, n_features] 此属性仅在线性核函数中可用,用于指定分配给特征的权重。 |
| 6 |
intercept_ − 数组,形状 = [n_class * (n_class-1)/2] 它表示决策函数中的独立项(常数)。 |
| 7 |
fit_status_ − int 如果拟合正确,则输出为 0。如果拟合不正确,输出将为 1。 |
| 8 |
classes_ − 数组,形状为 [n_classes] 它给出了类别的标签。 |
实现示例
与其他分类器一样,SVC 也需要使用以下两个数组 − 进行拟合。
一个数组 X,用于保存训练样本。其大小为 [n_samples, n_features]。
一个数组 Y,用于保存目标值,即训练样本的类别标签。其大小为 [n_samples]。
以下 Python 脚本使用 sklearn.svm.SVC 类 −
import numpy as np
X = np.array([[-1, -1], [-2, -1], [1, 1], [2, 1]])
y = np.array([1, 1, 2, 2])
from sklearn.svm import SVC
SVCClf = SVC(kernel = 'linear',gamma = 'scale', shrinking = False,)
SVCClf.fit(X, y)
输出
SVC(C = 1.0, cache_size = 200, class_weight = None, coef0 = 0.0,
   decision_function_shape = 'ovr', degree = 3, gamma = 'scale', kernel = 'linear',
   max_iter = -1, probability = False, random_state = None, shrinking = False,
   tol = 0.001, verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本获取权重向量 −
SVCClf.coef_
输出
array([[0.5, 0.5]])
示例
类似地,我们可以获取其他属性的值,如下所示 −
SVCClf.predict([[-0.5,-0.8]])
输出
array([1])
示例
SVCClf.n_support_
输出
array([1, 1])
示例
SVCClf.support_vectors_
输出
array(
   [
      [-1., -1.],
      [ 1., 1.]
   ]
)
示例
SVCClf.support_
输出
array([0, 2])
示例
SVCClf.intercept_
输出
array([-0.])
示例
SVCClf.fit_status_
输出
0
NuSVC
NuSVC 是 Nu 支持向量分类器。它是 scikit-learn 提供的另一个可以执行多类分类的类。它与 SVC 类似,但 NuSVC 接受的参数略有不同。与 SVC 不同的参数如下 −
nu − 浮点型,可选,默认值 = 0.5
它表示训练误差分数的上限和支持向量分数的下限。其值应在 (o,1) 区间内。
其余参数和属性与 SVC 相同。
实现示例
我们也可以使用 sklearn.svm.NuSVC 类实现相同的示例。
import numpy as np
X = np.array([[-1, -1], [-2, -1], [1, 1], [2, 1]])
y = np.array([1, 1, 2, 2])
from sklearn.svm import NuSVC
NuSVCClf = NuSVC(kernel = 'linear',gamma = 'scale', shrinking = False,)
NuSVCClf.fit(X, y)
输出
NuSVC(cache_size = 200, class_weight = None, coef0 = 0.0,
   decision_function_shape = 'ovr', degree = 3, gamma = 'scale', kernel = 'linear',
   max_iter = -1, nu = 0.5, probability = False, random_state = None,
   shrinking = False, tol = 0.001, verbose = False)
我们可以像 SVC 一样获得其余属性的输出。
LinearSVC
它是线性支持向量分类 (SVC)。它类似于核函数为"linear"的 SVC。它们之间的区别在于 LinearSVC 使用 liblinear 实现,而 SVC 使用 libsvm 实现。这就是为什么 LinearSVC 在惩罚和损失函数的选择上具有更大的灵活性。它还可以更好地扩展到大量样本。
如果我们谈论它的参数和属性,那么它不支持"kernel",因为它被假定为线性的,并且它还缺少一些属性,例如support_、support_vectors_、n_support_、fit_status_和dual_coef_。
但是,它支持penalty和loss参数,如下所示 −
penalty − 字符串,L1 或 L2(默认值 = 'L2')
此参数用于指定惩罚(正则化)中使用的范数(L1 或 L2)。
loss −字符串,hinge,squared_hinge(默认值 = squared_hinge)
它表示损失函数,其中'hinge'是标准SVM损失函数,'squared_hinge'是hinge损失函数的平方。
实现示例
以下Python脚本使用sklearn.svm.LinearSVC类 −
from sklearn.svm import LinearSVC
from sklearn.datasets import make_classification
X, y = make_classification(n_features = 4, random_state = 0)
LSVCClf = LinearSVC(dual = False, random_state = 0, penalty = 'l1',tol = 1e-5)
LSVCClf.fit(X, y)
输出
LinearSVC(C = 1.0, class_weight = None, dual = False, fit_intercept = True,
   intercept_scaling = 1, loss = 'squared_hinge', max_iter = 1000,
   multi_class = 'ovr', penalty = 'l1', random_state = 0, tol = 1e-05, verbose = 0)
示例
现在,一旦拟合完成,模型就可以预测新的值,如下所示 −
LSVCClf.predict([[0,0,0,0]])
输出
[1]
示例
对于上述示例,我们可以借助以下 Python 脚本 −
获取权重向量LSVCClf.coef_
输出
[[0. 0. 0.91214955 0.22630686]]
示例
类似地,我们可以借助以下 Python 脚本 − 获取截距值。
LSVCClf.intercept_
输出
[0.26860518]
使用 SVM 进行回归
如前所述,SVM 既可用于分类问题,也可用于回归问题。Scikit-learn 的支持向量分类 (SVC) 方法也可以扩展用于解决回归问题。这种扩展方法称为支持向量回归 (SVR)。
SVM 和 SVR 之间的基本相似性
SVC 创建的模型仅依赖于训练数据的一个子集。为什么?因为用于构建模型的成本函数不关心位于边界之外的训练数据点。
而 SVR(支持向量回归)生成的模型也仅依赖于训练数据的一个子集。为什么?因为用于构建模型的成本函数会忽略任何接近模型预测值的训练数据点。
Scikit-learn 提供了三个类,分别是 SVR、NuSVR 和 LinearSVR,作为 SVR 的三种不同实现。
SVR
它是 Epsilon-support 向量回归,其实现基于 libsvm。与 SVC 相反,该模型中有两个自由参数,分别为 'C' 和 'epsilon'。
epsilon − 浮点型,可选,默认值 = 0.1
它表示 epsilon-SVR 模型中的 epsilon,并指定 epsilon 管,在该管内,训练损失函数中预测点与实际值距离 epsilon 范围内的点不会受到惩罚。
其余参数和属性与 SVC 中使用的类似。
实现示例
以下 Python 脚本使用 sklearn.svm.SVR 类 −
from sklearn import svm
X = [[1, 1], [2, 2]]
y = [1, 2]
SVRReg = svm.SVR(kernel = 'linear', gamma = 'auto')
SVRReg.fit(X, y)
输出
SVR(C = 1.0, cache_size = 200, coef0 = 0.0, degree = 3, epsilon = 0.1, gamma = 'auto',
kernel = 'linear', max_iter = -1, shrinking = True, tol = 0.001, verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本 minus; 获得权重向量。
SVRReg.coef_
输出
array([[0.4, 0.4]])
示例
同样,我们可以通过如下方式获取其他属性的值 −
SVRReg.predict([[1,1]])
输出
array([1.1])
类似地,我们也可以获取其他属性的值。
NuSVR
NuSVR 是 Nu 支持向量回归。它与 NuSVC 类似,但 NuSVR 使用参数 nu 来控制支持向量的数量。此外,与 NuSVC 中 nu 替换 C 参数不同,这里它替换了 epsilon。
实现示例
以下 Python 脚本使用 sklearn.svm.SVR 类 −
from sklearn.svm import NuSVR
import numpy as np
n_samples, n_features = 20, 15
np.random.seed(0)
y = np.random.randn(n_samples)
X = np.random.randn(n_samples, n_features)
NuSVRReg = NuSVR(kernel = 'linear', gamma = 'auto',C = 1.0, nu = 0.1)^M
NuSVRReg.fit(X, y)
输出
NuSVR(C = 1.0, cache_size = 200, coef0 = 0.0, degree = 3, gamma = 'auto',
   kernel = 'linear', max_iter = -1, nu = 0.1, shrinking = True, tol = 0.001,
   verbose = False)
示例
现在,拟合完成后,我们可以借助以下 Python 脚本 − 获取权重向量
NuSVRReg.coef_
输出
array(
   [
      [-0.14904483, 0.04596145, 0.22605216, -0.08125403, 0.06564533,
      0.01104285, 0.04068767, 0.2918337 , -0.13473211, 0.36006765,
      -0.2185713 , -0.31836476, -0.03048429, 0.16102126, -0.29317051]
   ]
)
类似地,我们也可以获取其他属性的值。
LinearSVR
它是线性支持向量回归 (SVR)。它类似于核函数为"linear"的 SVR。它们之间的区别在于 LinearSVR 是基于 liblinear 实现的,而 SVC 是基于 libsvm 实现的。这就是为什么 LinearSVR 在惩罚函数和损失函数的选择上具有更大的灵活性。它还可以更好地扩展到大量样本。
如果我们谈论它的参数和属性,那么它不支持"kernel",因为它被假定为线性的,并且它还缺少一些属性,例如support_、support_vectors_、n_support_、fit_status_和dual_coef_。
但是,它支持"loss"参数,如下所示 −
loss −字符串,可选,默认值 = 'epsilon_insensitive'
它表示损失函数,其中 epsilon_insensitive 损失为 L1 损失,平方 epsilon-insensitive 损失为 L2 损失。
实现示例
以下 Python 脚本使用 sklearn.svm.LinearSVR 类 −
from sklearn.svm import LinearSVR
from sklearn.datasets import make_regression
X, y = make_regression(n_features = 4, random_state = 0)
LSVRReg = LinearSVR(dual = False, random_state = 0,
loss = 'squared_epsilon_insensitive',tol = 1e-5)
LSVRReg.fit(X, y)
输出
LinearSVR(
   C=1.0, dual=False, epsilon=0.0, fit_intercept=True,
   intercept_scaling=1.0, loss='squared_epsilon_insensitive',
   max_iter=1000, random_state=0, tol=1e-05, verbose=0
)
示例
现在,一旦拟合完成,模型可以预测新的值,如下所示:−
LSRReg.predict([[0,0,0,0]])
输出
array([-0.01041416])
示例
对于上述示例,我们可以借助以下 Python 脚本获取权重向量:−
LSRReg.coef_
输出
array([20.47354746, 34.08619401, 67.23189022, 87.47017787])
示例
类似地,我们可以借助以下 Python 脚本获取截距值 −
LSRReg.intercept_
输出
array([-0.01041416])
Scikit Learn - 异常检测
在这里,我们将了解 Sklearn 中的异常检测是什么,以及如何使用它来识别数据点。
异常检测是一种用于识别数据集中与其他数据不匹配的数据点的技术。它在商业领域有着广泛的应用,例如欺诈检测、入侵检测、系统健康监控、监控和预测性维护。异常,也称为离群值,可分为以下三类 −
点异常 − 当单个数据实例相对于其他数据被视为异常时,就会发生这种情况。
上下文异常 − 这种异常与上下文相关。如果某个数据实例在特定上下文中存在异常,就会发生异常。
集体异常 − 如果一组相关数据实例相对于整个数据集而非单个值存在异常,就会发生异常。
方法
异常检测可以使用两种方法,即异常值检测和新颖性检测。有必要区分它们。
异常值检测
训练数据包含远离其余数据的异常值。这些异常值被定义为观测值。因此,异常值检测估计器总是尝试拟合训练数据最集中的区域,同时忽略异常观测值。它也被称为无监督异常检测。
新颖性检测
它关注的是检测新观测值中未包含在训练数据中的未观察到的模式。此时,训练数据不受异常值的污染。它也被称为半监督异常检测。
scikit-learn 提供了一套机器学习工具,可用于异常值检测和新颖性检测。这些工具首先使用 fit () 方法以无监督的方式从数据中实现对象学习,如下所示 −
estimator.fit(X_train)
现在,新的观测值将使用 predict() 方法按如下方式排序为内点(标记为 1)或外点(标记为 -1) −
estimator.fit(X_test)
估计器将首先计算原始评分函数,然后预测方法将利用该原始评分函数的阈值。我们可以借助 score_sample 方法访问此原始评分函数,并通过 contamination 参数控制阈值。
我们还可以定义 decision_function 方法,将异常值定义为负值,将正常值定义为非负值。
estimator.decision_function(X_test)
Sklearn 异常值检测算法
首先,我们来了解一下什么是椭圆包络。
拟合椭圆包络
该算法假设常规数据服从已知分布,例如高斯分布。对于异常值检测,Scikit-learn 提供了一个名为 covariance.EllipticEnvelop 的对象。
该对象对数据进行稳健的协方差估计,从而将椭圆拟合到中心数据点。它会忽略中心模式之外的点。
参数
下表列出了 sklearn 使用的参数。 covariance.EllipticEnvelop 方法 −
| Sr.No | 参数及说明 |
|---|---|
| 1 |
store_precision − 布尔值,可选,默认值 = True 如果预估精度已存储,我们可以指定它。 |
| 2 |
assume_centered −布尔值,可选,默认值 = False 如果设置为 False,则直接借助 FastMCD 算法计算稳健位置和协方差。如果设置为 True,则计算稳健位置和协方差的支持度。 |
| 3 |
support_fraction − 浮点数 (0., 1.),可选,默认值 = None 此参数指示方法在原始 MCD 估计值的支持度中包含多少比例的点。 |
| 4 |
contamination −浮点数 (0., 1.),可选,默认值 = 0.1 它提供了数据集中异常值的比例。 |
| 5 |
random_state − int,RandomState 实例或 None,可选,默认值 = none 此参数表示生成的伪随机数的种子,用于对数据进行混洗。以下是 − 的选项
|
属性
下表列出了 sklearn.covariance.EllipticEnvelop 方法 − 使用的属性。
| Sr.No | 属性和说明 |
|---|---|
| 1 |
support_ −数组类型,形状为 (n_samples,) 它表示用于计算位置和形状稳健估计的观测值掩码。 |
| 2 |
location_ − 数组类型,形状为 (n_features) 它返回估计的稳健位置。 |
| 3 |
covariance_ −数组类型,形状为 (n_features, n_features) 返回估计的稳健协方差矩阵。 |
| 4 |
precision_ − 数组类型,形状为 (n_features, n_features) 返回估计的伪逆矩阵。 |
| 5 |
offset_ − 浮点型 用于根据原始分数定义决策函数。 decision_function = score_samples -offset_ |
实现示例
import numpy as np^M
from sklearn.covariance import EllipticEnvelope^M
true_cov = np.array([[.5, .6],[.6, .4]])
X = np.random.RandomState(0).multivariate_normal(mean = [0, 0], cov=true_cov,size=500)
cov = EllipticEnvelope(random_state = 0).fit(X)^M
# 现在我们可以使用 predict 方法了。对于正常值,它将返回 1;对于异常值,它将返回 -1。
cov.predict([[0, 0],[2, 2]])
输出
array([ 1, -1])
孤立森林
对于高维数据集,一种有效的异常值检测方法是使用随机森林。scikit-learn 提供了 ensemble.IsolationForest 方法,该方法通过随机选择一个特征来隔离观测值。之后,它会在所选特征的最大值和最小值之间随机选择一个值。
这里,隔离样本所需的分裂次数等于从根节点到终止节点的路径长度。
参数
下表列出了 sklearn.ensemble.IsolationForest 方法 − 使用的参数。
| Sr.No | 参数 &描述 |
|---|---|
| 1 |
n_estimators − int,可选,默认值 = 100 它表示集成中基础估计器的数量。 |
| 2 |
max_samples − int 或 float,可选,默认值 = "auto" 它表示从 X 中抽取的用于训练每个基础估计器的样本数量。如果我们选择 int 作为其值,它将抽取 max_samples 个样本。如果我们选择 float 作为其值,它将抽取 max_samples ∗ 𝑋.shape[0] 个样本。如果我们选择 auto 作为其值,它将绘制 max_samples = min(256,n_samples)。 |
| 3 |
support_fraction − 浮点数 (0., 1.),可选,默认值 = None 此参数指示方法在原始 MCD 估计值的支持度中包含多少比例的点。 |
| 4 |
contamination − auto 或浮点数,可选,默认值 = auto 它提供了数据集中异常值的比例。如果我们将其设置为默认值,即 auto,它将像原始论文中一样确定阈值。如果设置为浮点数,污染范围将在 [0,0.5] 范围内。 |
| 5 |
random_state − int,RandomState 实例或 None,可选,默认值 = none 此参数表示生成的伪随机数的种子,用于对数据进行混洗。以下是选项 −
|
| 6 |
max_features − int 或 float,可选(默认值 = 1.0) 它表示从 X 中提取的特征数量,用于训练每个基础估计器。如果选择 int 作为其值,它将提取 max_features 个特征。如果选择 float 作为其值,它将提取 max_features * X.shape[𝟏] 个样本。 |
| 7 | bootstrap − 布尔值,可选(默认值 = False) 其默认选项为 False,表示将以非重复采样的方式进行。另一方面,如果设置为 True,则表示各个树将拟合在经过替换抽样的训练数据的随机子集上。 |
| 8 |
n_jobs − int 或 None,可选(默认值 = None) 它表示 fit() 和 predict() 方法并行运行的作业数。 |
| 9 |
verbose − int,可选(默认值 = 0) 此参数控制树构建过程的详细程度。 |
| 10 |
warm_start − Bool,可选(默认值 = False) 如果 warm_start = true,我们可以重用之前调用的解决方案进行拟合,并可以向集成中添加更多估计器。但如果设置为 false,则需要拟合一个全新的森林。 |
属性
下表包含 sklearn 使用的属性。 ensemble.IsolationForest 方法 −
| Sr.No | 属性和说明 |
|---|---|
| 1 |
estimators_ − DecisionTreeClassifier 列表 提供所有已拟合子估计器的集合。 |
| 2 |
max_samples_ −整数 它提供实际使用的样本数量。 |
| 3 |
offset_ − 浮点型 它用于根据原始分数定义决策函数。decision_function = score_samples -offset_ |
实现示例
以下 Python 脚本将使用 sklearn。 ensemble.IsolationForest 方法对给定数据拟合 10 棵树
from sklearn.ensemble import IsolationForest
import numpy as np
X = np.array([[-1, -2], [-3, -3], [-3, -4], [0, 0], [-50, 60]])
OUTDClf = IsolationForest(n_estimators = 10)
OUTDclf.fit(X)
输出
IsolationForest(
   behaviour = 'old', bootstrap = False, contamination='legacy',
   max_features = 1.0, max_samples = 'auto', n_estimators = 10, n_jobs=None,
   random_state = None, verbose = 0
)
局部离群因子
局部离群因子 (LOF) 算法是另一种在高维数据上执行离群值检测的有效算法。scikit-learn 提供了 neighbors.LocalOutlierFactor 方法,该方法计算一个称为局部离群因子的分数,该分数反映了观测值的异常程度。该算法的主要逻辑是检测密度明显低于其邻居的样本。因此,它测量给定数据点相对于其邻居的局部密度偏差。
参数
下表包含 sklearn.neighbors.LocalOutlierFactor 方法使用的参数
| Sr.No | 参数 &说明 |
|---|---|
| 1 |
n_neighbors − int,可选,默认值 = 20 表示 kneighbors 查询默认使用的邻居数量。如果 ,则所有样本都将被使用。 |
| 2 |
算法 −可选 使用哪种算法计算最近邻。
|
| 3 |
leaf_size − int,可选,默认值 = 30 此参数的值会影响构建和查询的速度。它还会影响存储树所需的内存。此参数会传递给 BallTree 或 KdTree 算法。 |
| 4 |
contamination − auto 或 float,可选,默认值 = auto 它提供了数据集中异常值的比例。如果我们将其设置为默认值,即 auto,它将像原始论文中一样确定阈值。如果设置为 float,则污染范围将在 [0,0.5] 范围内。 |
| 5 |
metric − 字符串或可调用函数,默认值 它表示用于距离计算的度量。 |
| 6 |
P − int,可选(默认值 = 2) 这是明可夫斯基度量的参数。P=1 相当于使用 manhattan_distance,即 L1,而 P=2 相当于使用 euclidean_distance,即 L2。 |
| 7 |
novelty − 布尔值,(默认值 = False) 默认情况下,LOF 算法用于异常值检测,但如果我们将 novelty 设置为 true,则可以将其用于新颖性检测。 |
| 8 |
n_jobs − int 或 None,可选(默认值 = None) 它表示 fit() 和 predict() 方法并行运行的作业数。 |
属性
下表包含 sklearn.neighbors.LocalOutlierFactor 方法 − 使用的属性。
| Sr.No | 属性和说明 |
|---|---|
| 1 |
negative_outlier_factor_ − numpy 数组,形状为 (n_samples,) 提供训练样本的反向 LOF。 |
| 2 |
n_neighbors_ − 整数 提供用于邻居查询的实际邻居数量。 |
| 3 |
offset_ −浮点型 用于根据原始分数定义二分类标签。 |
实现示例
下面给出的 Python 脚本将使用 sklearn.neighbors.LocalOutlierFactor 方法,从与我们的数据集对应的任何数组构建 NeighborsClassifier 类。
from sklearn.neighbors import NearestNeighbors
samples = [[0., 0., 0.], [0., .5, 0.], [1., 1., .5]]
LOFneigh = NearestNeighbors(n_neighbors = 1, algorithm = "ball_tree",p=1)
LOFneigh.fit(samples)
输出
NearestNeighbors(
   algorithm = 'ball_tree', leaf_size = 30, metric='minkowski',
   metric_params = None, n_jobs = None, n_neighbors = 1, p = 1, radius = 1.0
)
示例
现在,我们可以使用以下 Python 脚本 − 从这个构建的分类器中查询距离 [0.5, 1., 1.5] 最近的点。
print(neigh.kneighbors([[.5, 1., 1.5]])
输出
(array([[1.7]]), array([[1]], dtype = int64))
单类 SVM
Schölkopf 等人提出的单类 SVM 是一种无监督异常值检测方法。它在高维数据中也非常有效,并且可以估计高维分布的支持度。它实现于Sklearn.svm.OneClassSVM 对象中的 支持向量机 模块。定义边界需要一个核函数(最常用的是 RBF)和一个标量参数。
为了更好地理解,我们使用 svm.OneClassSVM 对象 − 来拟合数据。
示例
from sklearn.svm import OneClassSVM
X = [[0], [0.89], [0.90], [0.91], [1]]
OSVMclf = OneClassSVM(gamma = 'scale').fit(X)
现在,我们可以按如下方式获取输入数据的 score_samples −
OSVMclf.score_samples(X)
输出
array([1.12218594, 1.58645126, 1.58673086, 1.58645127, 1.55713767])
Scikit Learn - K 最近邻 (KNN)
本章将帮助您理解 Sklearn 中的最近邻方法。
基于邻居的学习方法有两种类型,即监督和无监督。监督式基于邻居的学习既可用于分类问题,也可用于回归预测问题,但在工业界主要用于分类预测问题。
基于邻居的学习方法没有专门的训练阶段,在分类过程中使用所有数据进行训练。它也不对底层数据进行任何假设。这就是它们本质上是惰性和非参数的原因。
最近邻方法的主要原理是 −
找到距离新数据点最近的预定数量的训练样本
根据这些训练样本预测标签。
在这里,样本数量可以是用户定义的常数,就像在 K 最近邻学习中一样,也可以根据点的局部密度而变化,就像在基于半径的邻域学习中一样。
sklearn.neighbors 模块
Scikit-learn 有 sklearn.neighbors 模块,它为无监督和有监督的基于邻域的学习方法提供功能。作为输入,此模块中的类可以处理 NumPy 数组或 scipy.sparse 矩阵。
算法类型
可用于基于邻域的方法实现的不同类型的算法如下 −
暴力计算
对数据集中所有点对之间的距离进行暴力计算,提供了最简单的邻域搜索实现。从数学上讲,对于 D 维中的 N 个样本,暴力计算方法的规模为 0[DN2]
对于小数据样本,此算法可能非常有用,但随着样本数量的增加,它变得不可行。可以通过写入关键字 algorithm='brute' 来启用暴力邻域搜索。
K-D 树
为了解决暴力算法计算效率低下的问题,人们发明了一种基于树的数据结构,即 KD 树数据结构。本质上,KD 树是一种二叉树结构,也称为 K 维树。它沿数据轴递归地划分参数空间,将参数空间划分为嵌套的正交区域,并将数据点填充到这些区域中。
优点
以下是 K-D 树算法的一些优点 −
构建速度快 − 由于分区仅沿数据轴进行,因此 K-D 树的构建速度非常快。
距离计算更少 − 该算法只需进行非常少的距离计算即可确定查询点的最近邻。它仅需要进行 𝑶[𝐥𝐨𝐠 (𝑵)] 次距离计算。
缺点
仅适用于低维邻域搜索 − 对于低维(D < 20)邻域搜索,它非常快,但随着 D 的增长,它变得效率低下。由于分区仅沿数据轴执行,
可以通过写入关键字 algorithm='kd_tree' 来启用 K-D 树邻域搜索。
Ball 树
众所周知,K-D 树在高维空间中效率低下,因此,为了解决 K-D 树的低效问题,开发了 Ball 树数据结构。从数学上讲,它以递归方式将数据划分为由质心 C 和半径 r 定义的节点,使得节点中的每个点都位于由质心 C 和半径 r 定义的超球面内。它使用下面给出的三角不等式,从而减少了邻域搜索的候选点数量。
$$\arrowvert X+Y\arrowvert\leq \arrowvert X\arrowvert+\arrowvert Y\arrowvert$$优点
以下是 Ball Tree 算法 − 的一些优点。
对高度结构化数据高效 − 由于 Ball Tree 将数据划分为一系列嵌套的超球体,因此它在高度结构化数据上高效。
优于 KD 树 − Ball 树在高维度上优于 KD 树,因为它具有 Ball 树节点的球形几何形状。
缺点
成本高 −将数据划分为一系列嵌套的超球体,使其构建成本非常高。
可以通过写入关键字 algorithm='ball_tree' 来启用球树邻域搜索。
选择最近邻算法
对于给定的数据集,选择最佳算法取决于以下因素 −
样本数 (N) 和维度 (D)
这些是选择最近邻算法时需要考虑的最重要因素。这是由于以下原因 −
暴力破解算法的查询时间增长速度为 O[DN]。
Ball 树算法的查询时间增长速度为 O[D log(N)]。
KD 树算法的查询时间随 D 的变化方式很奇怪,很难描述。当 D < 20 时,成本为 O[D log(N)],该算法非常高效。另一方面,当 D > 20 时,由于成本增加到接近 O[DN],因此效率低下。
数据结构
影响这些算法性能的另一个因素是数据的固有维数或数据的稀疏性。这是因为 Ball 树和 KD 树算法的查询时间会受其很大影响。而暴力破解算法的查询时间不受数据结构的影响。通常,Ball 树和 KD 树算法在应用于固有维数较小的稀疏数据时,查询速度更快。
邻居数量 (k)
查询点所需的邻居数量 (k) 会影响 Ball 树和 KD 树算法的查询时间。随着邻居数量 (k) 的增加,它们的查询时间会变慢。而暴力算法的查询时间则不受 k 值的影响。
查询点数量
由于 KD 树和 Ball 树算法都需要构建阶段,因此如果查询点数量较多,它们都会有效。另一方面,如果查询点数量较少,暴力算法的性能会优于 KD 树和 Ball 树算法。
Scikit Learn - KNN 学习
k-NN(k 最近邻)是最简单的机器学习算法之一,本质上是非参数的和惰性的。非参数意味着对底层数据分布没有任何假设,即模型结构由数据集决定。惰性学习或基于实例的学习意味着,为了生成模型,它不需要任何训练数据点,并且在测试阶段使用整个训练数据。
k-NN 算法包含以下两个步骤 −
步骤 1
在此步骤中,它计算并存储训练集中的每个样本的 k 个最近邻。
步骤 2
在此步骤中,对于未标记的样本,它从数据集中检索 k 个最近邻。然后,在这些 k 个最近邻中,它通过投票来预测类别(获得多数票的类别获胜)。
实现 k 个最近邻算法的模块 sklearn.neighbors 提供了基于无监督和有监督邻域的学习方法的功能。
无监督最近邻算法实现了不同的算法(BallTree、KDTree 或 Brute Force)来为每个样本找到最近邻。这个无监督版本基本上只是上面讨论的第一步,也是许多需要邻域搜索的算法(其中最著名的是 KNN 和 K-means)的基础。简而言之,它是用于实现近邻搜索的无监督学习器。
另一方面,基于近邻的监督学习可用于分类和回归。
无监督 KNN 学习
如上所述,许多算法(例如 KNN 和 K-Means)都需要进行近邻搜索。因此,Scikit-learn 决定将近邻搜索部分实现为一个独立的"学习器"。将近邻搜索作为一个独立的学习器实现的原因是,计算所有成对距离来查找近邻显然效率不高。让我们通过示例来了解 Sklearn 用于实现无监督近邻学习的模块。
Scikit-learn 模块
sklearn.neighbors.NearestNeighbors 是用于实现无监督近邻学习的模块。它使用特定的近邻算法,例如 BallTree、KDTree 或 Brute Force。换句话说,它充当这三种算法的统一接口。
参数
下表列出了 NearestNeighbors 模块使用的参数 −
| Sr.No | 参数及说明 |
|---|---|
| 1 |
n_neighbors − int,可选 要获取的邻居数量。默认值为 5。 |
| 2 |
radius − float,可选 限制邻居与返回值的距离。默认值为 1.0。 |
| 3 |
algorithm − {'auto', 'ball_tree', 'kd_tree', 'brute'},可选 此参数将接受您想要使用的算法(BallTree、KDTree 或 Brute-force)来计算最近邻。如果您提供'auto',它将尝试根据传递给 fit 方法的值来确定最合适的算法。 |
| 4 |
leaf_size − int,可选 它会影响构建和查询的速度以及存储树所需的内存。它传递给 BallTree 或 KDTree。虽然最优值取决于问题的性质,但其默认值为 30。 |
| 5 |
metric − 字符串或可调用函数 这是用于计算点间距离的度量标准。我们可以将其作为字符串或可调用函数传递。如果是可调用函数,则会在每一对行上调用该度量标准,并记录结果值。这比将度量标准名称作为字符串传递效率较低。 我们可以从 scikit-learn 或 scipy.spatial.distance 中选择度量标准。有效值如下 − Scikit-learn − ['cosine','manhattan','Euclidean','l1','l2','cityblock'] Scipy.spatial.distance − ['braycurtis','canberra','chebyshev','dice','hamming','jaccard','correlation','kulsinski','mahalanobis','minkowski','rogerstanimoto','russellrao','sokalmicheme','sokalsneath','seuclidean','sqeuclidean','yule']. 默认度量为'Minkowski'。 |
| 6 |
P − 整数,可选 这是明可夫斯基度量的参数。默认值为 2,相当于使用 Euclidean_distance(l2)。 |
| 7 |
metric_params − dict,可选 这是度量函数的附加关键字参数。默认值为 None。 |
| 8 |
N_jobs − int 或 None,可选 它表示用于邻居搜索的并行作业数量。默认值为 None。 |
实现示例
以下示例将使用 sklearn.neighbors.NearestNeighbors 模块查找两组数据之间的最近邻。
首先,我们需要导入所需的模块和包 −
from sklearn.neighbors import NearestNeighbors
import numpy as np
导入包后,定义我们想要查找最近邻的数据集 −
Input_data = np.array([[-1, 1], [-2, 2], [-3, 3], [1, 2], [2, 3], [3, 4],[4, 5]])
接下来,应用无监督学习算法,如下所示 −
nrst_neigh = NearestNeighbors(n_neighbors = 3, algorithm = 'ball_tree')
接下来,使用输入数据集拟合模型。
nrst_neigh.fit(Input_data)
现在,找到数据集的 K 邻域。它将返回每个点的邻域索引和距离。
distances, indices = nbrs.kneighbors(Input_data)
indices
输出
array(
   [
      [0, 1, 3],
      [1, 2, 0],
      [2, 1, 0],
      [3, 4, 0],
      [4, 5, 3],
      [5, 6, 4],
      [6, 5, 4]
   ], dtype = int64
)
distances
输出
array(
   [
      [0. , 1.41421356, 2.23606798],
      [0. , 1.41421356, 1.41421356],
      [0. , 1.41421356, 2.82842712],
      [0. , 1.41421356, 2.23606798],
      [0. , 1.41421356, 1.41421356],
      [0. , 1.41421356, 1.41421356],
      [0. , 1.41421356, 2.82842712]
   ]
)
以上输出表明,每个点的最近邻是该点本身,即零点。这是因为查询集与训练集匹配。
示例
我们还可以通过生成如下稀疏图来显示相邻点之间的联系 −
nrst_neigh.kneighbors_graph(Input_data).toarray()
输出
array(
   [
      [1., 1., 0., 1., 0., 0., 0.],
      [1., 1., 1., 0., 0., 0., 0.],
      [1., 1., 1., 0., 0., 0., 0.],
      [1., 0., 0., 1., 1., 0., 0.],
      [0., 0., 0., 1., 1., 1., 0.],
      [0., 0., 0., 0., 1., 1., 1.],
      [0., 0., 0., 0., 1., 1., 1.]
   ]
)
一旦我们适应了无监督的NearestNeighbors模型,数据将根据参数'algorithm'的值设置存储在数据结构中。之后,我们可以在需要邻居搜索的模型中使用这个无监督学习器的kneighbors。
完整的可运行/可执行程序
from sklearn.neighbors import NearestNeighbors
import numpy as np
Input_data = np.array([[-1, 1], [-2, 2], [-3, 3], [1, 2], [2, 3], [3, 4],[4, 5]])
nrst_neigh = NearestNeighbors(n_neighbors = 3, algorithm='ball_tree')
nrst_neigh.fit(Input_data)
distances, indices = nbrs.kneighbors(Input_data)
indices
distances
nrst_neigh.kneighbors_graph(Input_data).toarray()
监督式 KNN 学习
基于近邻的监督式学习用于以下 −
- 分类,针对离散标签的数据
- 回归,针对连续标签的数据
最近邻分类器
我们可以借助以下两个特征 − 来理解基于近邻的分类
- 它由每个点的最近邻的简单多数投票计算得出。
- 它仅存储训练数据的实例,因此它是一种非泛化的类型学习。
Scikit-learn 模块
以下是 scikit-learn 使用的两种不同类型的最近邻分类器 −
| S.No. | 分类器及说明 | 1. | KNeighborsClassifier
此分类器名称中的 K 表示 k 个最近邻,其中 k 是用户指定的整数值。因此,顾名思义,此分类器基于 k 个最近邻进行学习。k 值的选择取决于数据。 |
|---|---|
| 2. | RadiusNeighborsClassifier
此分类器名称中的 Radius 表示在指定半径 r 内的最近邻,其中 r 是用户指定的浮点值。因此,顾名思义,该分类器基于每个训练点固定半径 r 内的邻居数量进行学习。 |
最近邻回归器
它用于数据标签本质上是连续的情况。分配的数据标签是根据其最近邻标签的平均值计算的。
以下是 scikit-learn 使用的两种不同类型的最近邻回归器 −
KNeighborsRegressor
此回归器名称中的 K 代表 k 个最近邻,其中 k 是用户指定的整数值。因此,顾名思义,该回归器基于 k 个最近邻进行学习。k 值的选择取决于数据。让我们借助一个实现示例来进一步理解它。
以下是 scikit-learn 使用的两种不同类型的最近邻回归器 −
实现示例
在本例中,我们将使用 scikit-learn 的 KNeighborsRegressor 在名为 Iris Flower 的数据集上实现 KNN。
首先,按如下方式导入鸢尾花数据集 −
from sklearn.datasets import load_iris
iris = load_iris()
现在,我们需要将数据拆分为训练数据和测试数据。我们将使用 Sklearn 的 train_test_split 函数将数据按 70(训练数据)和 20(测试数据)的比例拆分。
X = iris.data[:, :4]
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.20)
接下来,我们将借助 Sklearn 预处理模块进行数据缩放,如下所示 −
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)
接下来,从 Sklearn 导入 KNeighborsRegressor 类,并提供邻居值,如下所示。
示例
import numpy as np
from sklearn.neighbors import KNeighborsRegressor
knnr = KNeighborsRegressor(n_neighbors = 8)
knnr.fit(X_train, y_train)
输出
KNeighborsRegressor(
   algorithm = 'auto', leaf_size = 30, metric = 'minkowski',
   metric_params = None, n_jobs = None, n_neighbors = 8, p = 2,
   weights = 'uniform'
)
示例
现在,我们可以找到如下的 MSE(均方误差)−
print ("MSE 为:",format(np.power(y-knnr.predict(X),4).mean()))
输出
MSE 为:4.4333349609375
示例
现在,使用它来预测如下的值 −
X = [[0], [1], [2], [3]]
y = [0, 0, 1, 1]
from sklearn.neighbors import KNeighborsRegressor
knnr = KNeighborsRegressor(n_neighbors = 3)
knnr.fit(X, y)
print(knnr.predict([[2.5]]))
输出
[0.66666667]
完整的可执行程序
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data[:, :4]
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20)
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()

scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)

import numpy as np
from sklearn.neighbors import KNeighborsRegressor
knnr = KNeighborsRegressor(n_neighbors=8)
knnr.fit(X_train, y_train)

print ("The MSE is:",format(np.power(y-knnr.predict(X),4).mean()))

X = [[0], [1], [2], [3]]
y = [0, 0, 1, 1]
from sklearn.neighbors import KNeighborsRegressor
knnr = KNeighborsRegressor(n_neighbors=3)
knnr.fit(X, y)
print(knnr.predict([[2.5]]))
RadiusNeighborsRegressor
此回归器名称中的 Radius 表示指定半径 r 内的最近邻点,其中 r 是用户指定的浮点值。因此,顾名思义,此回归器基于每个训练点在固定半径 r 内的邻居数量进行学习。让我们借助一个实现示例 −
来更深入地理解它实现示例
在本例中,我们将使用 scikit-learn 的 RadiusNeighborsRegressor −
在名为 Iris Flower 的数据集上实现 KNN首先,按如下方式导入鸢尾花数据集 −
from sklearn.datasets import load_iris
iris = load_iris()
现在,我们需要将数据拆分为训练数据和测试数据。我们将使用 Sklearn 的 train_test_split 函数将数据按 70(训练数据)和 20(测试数据)的比例拆分 −
X = iris.data[:, :4]
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.20)
接下来,我们将借助 Sklearn 预处理模块进行数据缩放,如下所示 −
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)
接下来,从 Sklearn 导入 RadiusneighborsRegressor 类,并提供半径值,如下所示:−
import numpy as np
from sklearn.neighbors import RadiusNeighborsRegressor
knnr_r = RadiusNeighborsRegressor(radius=1)
knnr_r.fit(X_train, y_train)
示例
现在,我们可以计算 MSE(均方误差),如下所示 −
print ("The MSE is:",format(np.power(y-knnr_r.predict(X),4).mean()))
Output
MSE 为:5.666666666666667
示例
现在,使用它来预测如下值 −
X = [[0], [1], [2], [3]]
y = [0, 0, 1, 1]
from sklearn.neighbors import RadiusNeighborsRegressor
knnr_r = RadiusNeighborsRegressor(radius=1)
knnr_r.fit(X, y)
print(knnr_r.predict([[2.5]]))
输出
[1.]
完整的工作/可执行程序
from sklearn.datasets import load_iris

iris = load_iris()

X = iris.data[:, :4]
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.20)
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)
import numpy as np
from sklearn.neighbors import RadiusNeighborsRegressor
knnr_r = RadiusNeighborsRegressor(radius = 1)
knnr_r.fit(X_train, y_train)
print ("The MSE is:",format(np.power(y-knnr_r.predict(X),4).mean()))
X = [[0], [1], [2], [3]]
y = [0, 0, 1, 1]
from sklearn.neighbors import RadiusNeighborsRegressor
knnr_r = RadiusNeighborsRegressor(radius = 1)
knnr_r.fit(X, y)
print(knnr_r.predict([[2.5]]))
Scikit Learn - 使用朴素贝叶斯进行分类
朴素贝叶斯方法是一组基于贝叶斯定理的监督学习算法,它假设所有预测变量彼此独立,即某个特征在某个类中的存在与否与同一类中任何其他特征的存在无关。正是由于这种朴素假设,这些方法被称为朴素贝叶斯方法。
贝叶斯定理阐明了以下关系,以便计算类别的后验概率,即某个标签和某些观测特征的概率,$P\left(\begin{array}{c} Y\arrowvert features\end{array} ight)$。
$$P\left(\begin{array}{c} Y\arrowvert features\end{array} ight)=\left(\frac{P\lgroup Y group P\left(\begin{array}{c} features\arrowvert Y\end{array} ight)}{P\left(\begin{array}{c} features\end{array} ight)} ight)$$Here, $P\left(\begin{array}{c} Y\arrowvert features\end{array} ight)$ is the posterior probability of class.
$P\left(\begin{array}{c} Y\end{array} ight)$ is the prior probability of class.
$P\left(\begin{array}{c} features\arrowvert Y\end{array} ight)$ is the likelihood which is the probability of predictor given class.
$P\left(\begin{array}{c} features\end{array} ight)$ is the prior probability of predictor.
The Scikit-learn provides different naïve Bayes classifiers models namely Gaussian, Multinomial, Complement and Bernoulli. All of them differ mainly by the assumption they make regarding the distribution of 𝑷$P\left(\begin{array}{c} features\arrowvert Y\end{array} ight)$ i.e. the probability of predictor given class.
| Sr.No | 模型 &描述 |
|---|---|
| 1 |
高斯朴素贝叶斯
高斯朴素贝叶斯分类器假设每个标签的数据都服从简单的高斯分布。 |
| 2 |
多项朴素贝叶斯
它假设特征服从简单的多项分布。 |
| 3 |
伯努利朴素贝叶斯
该模型假设特征本质上是二进制的(0 和 1)。伯努利朴素贝叶斯分类的一个应用是使用"词袋"模型进行文本分类。 |
| 4 |
补充朴素贝叶斯
它的设计是为了纠正多项贝叶斯分类器所做的严格假设。这种朴素贝叶斯分类器适用于不平衡数据集。 |
构建朴素贝叶斯分类器
我们也可以在 Scikit-learn 数据集上应用朴素贝叶斯分类器。在下面的示例中,我们应用了 GaussianNB 并拟合了 Scikit-learn 的 breast_cancer 数据集。
示例
Import Sklearn
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
data = load_breast_cancer()
label_names = data['target_names']
labels = data['target']
feature_names = data['feature_names']
features = data['data']
   print(label_names)
   print(labels[0])
   print(feature_names[0])
   print(features[0])
train, test, train_labels, test_labels = train_test_split(
   features,labels,test_size = 0.40, random_state = 42
)
from sklearn.naive_bayes import GaussianNB
GNBclf = GaussianNB()
model = GNBclf.fit(train, train_labels)
preds = GNBclf.predict(test)
print(preds)
输出
[
   1 0 0 1 1 0 0 0 1 1 1 0 1 0 1 0 1 1 1 0 1 1 0 1 1 1 1
   1 1 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 1 1 1 0 0 1 1
   1 1 1 0 0 1 1 0 0 1 1 1 0 0 1 1 0 0 1 0 1 1 1 1 1 1 0
   1 1 0 0 0 0 0 1 1 1 1 1 1 1 1 0 0 1 0 0 1 0 0 1 1 1 0
   1 1 0 1 1 0 0 0 1 1 1 0 0 1 1 0 1 0 0 1 1 0 0 0 1 1 1
   0 1 1 0 0 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 0 0 1 1 1 1 1
   1 1 1 1 1 1 1 0 1 1 1 0 1 1 0 1 1 1 1 1 1 0 0 0 1 1 0
   1 0 1 1 1 1 0 1 1 0 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 0 1
   1 1 1 1 0 1 0 0 1 1 0 1
]
上述输出由一系列 0 和 1 组成,它们基本上是恶性和良性肿瘤类别的预测值。
Scikit Learn - 决策树
在本章中,我们将学习 Sklearn 中的一种学习方法,即决策树。
决策树 (DT) 是最强大的非参数监督学习方法。它们可用于分类和回归任务。DT 的主要目标是通过学习从数据特征中推导出的简单决策规则,创建一个预测目标变量值的模型。决策树有两个主要实体:一个是根节点,数据在此分裂;另一个是决策节点或叶子节点,我们在此获得最终输出。
决策树算法
以下将解释不同的决策树算法 −
ID3
该算法由 Ross Quinlan 于 1986 年开发。它也被称为迭代二分法 3。该算法的主要目标是为每个节点找到那些能够为分类目标带来最大信息增益的分类特征。
它使树生长到最大尺寸,然后应用剪枝步骤来提高树处理未知数据的能力。该算法的输出将是一棵多路树。
C4.5
它是 ID3 的后继者,动态定义一个离散属性,将连续属性值划分为一组离散的区间。这就是它移除分类特征限制的原因。它将 ID3 训练好的树转换为一系列"IF-THEN"规则。
为了确定这些规则的应用顺序,首先会评估每条规则的准确率。
C5.0
它的工作原理与 C4.5 类似,但占用的内存更少,构建的规则集更小。它比 C4.5 更准确。
CART
它被称为分类和回归树算法。它基本上是利用特征和阈值进行二元分割,从而在每个节点上产生最大的信息增益(称为基尼系数)。
同质性取决于基尼系数,基尼系数越高,同质性就越高。它类似于 C4.5 算法,但不同之处在于它不计算规则集,也不支持数值目标变量(回归)。
使用决策树进行分类
在这种情况下,决策变量是分类变量。
Sklearn 模块 − Scikit-learn 库提供了模块名称 DecisionTreeClassifier,用于对数据集执行多类分类。
参数
下表列出了 sklearn.tree.DecisionTreeClassifier 模块使用的参数 −
| Sr.No | 参数及说明 |
|---|---|
| 1 | criterion − 字符串,可选,默认值为 "gini" 该函数用于衡量分割质量。支持的criterion包括"gini"和"entropy"。默认值为gini,表示基尼不纯度,而entropy表示信息增益。 |
| 2 | splitter −字符串,可选,默认值为"best" 它告诉模型,在每个节点上选择哪种策略(从"best"到"random")。 |
| 3 | max_depth − int 或 None,可选,默认值为 None 此参数决定树的最大深度。默认值为 None,这意味着节点将不断扩展,直到所有叶子节点都为纯节点,或所有叶子节点包含的样本数少于 min_smaples_split 个为止。 |
| 4 | min_samples_split − int,浮点型,可选,默认值:2 此参数指定拆分内部节点所需的最小样本数。 |
| 5 | min_samples_leaf − int,浮点型,可选,默认值:1 此参数指定位于叶节点所需的最小样本数。 |
| 6 | min_weight_fraction_leaf −浮点型,可选,默认值为 0。 使用此参数,模型将获取位于叶节点所需权重总和的最小加权分数。 |
| 7 | max_features 最小值,整数,浮点型,字符串或 None,可选,默认值为 None 它为模型提供了在寻找最佳分割时需要考虑的特征数量。 |
| 8 | random_state 最小值,整数,RandomState 实例或 None,可选,默认值为 None 此参数表示生成的伪随机数的种子,用于对数据进行混洗。以下是选项 −
|
| 9 | max_leaf_nodes − int 或 None,可选,默认值为 None 此参数将以最佳优先的方式生成具有 max_leaf_nodes 的树。默认值为 None,这意味着叶节点数量不受限制。 |
| 10 | min_impurity_decrease − 浮点型,可选,默认值为 0。 此值用作节点分裂的标准,因为如果分裂导致杂质减少量大于或等于 min_impurity_decrease 值,模型将分裂该节点。 |
| 11 | min_impurity_split − 浮点型,默认值=1e-7 它表示树生长早期停止的阈值。 |
| 12 | class_weight − 字典,字典列表,"balanced" 或 None,默认值=None 它表示与类别相关的权重。格式为 {class_label: weight}。如果我们使用默认选项,则表示所有类别的权重都应该为 1。另一方面,如果您选择 class_weight: balanced,它将使用 y 的值自动调整权重。 |
| 13 | presort − bool,可选,默认值为 False 它指示模型是否对数据进行预排序,以加快在拟合过程中找到最佳分割的速度。默认值为 false,但如果设置为 true,可能会减慢训练速度。 |
属性
下表列出了 sklearn.tree.DecisionTreeClassifier 模块使用的属性 −
| Sr.No | 参数及说明 |
|---|---|
| 1 | feature_importances_ −形状为 [n_features] 的数组 此属性将返回特征重要性。 |
| 2 | classes_: − 形状为 [n_classes] 的数组或此类数组的列表 它表示类别标签,即单输出问题;或表示类别标签数组列表,即多输出问题。 |
| 3 | max_features_ − int 它表示 max_features 参数的推导值。 |
| 4 | n_classes_ − int 或 list 它表示类别数,即单输出问题;或表示每个输出的类别数列表,即多输出问题。 |
| 5 | n_features_ − int 执行 fit() 方法时,它给出特征的数量。 |
| 6 | n_outputs_ − int 执行 fit() 方法时,它给出输出的数量。 |
方法
下表列出了 sklearn.tree.DecisionTreeClassifier 模块使用的方法 −
| Sr.No | 参数 &说明 |
|---|---|
| 1 | apply(self, X[, check_input]) 此方法将返回叶子节点的索引。 |
| 2 | decision_path(self, X[, check_input]) 顾名思义,此方法将返回树中的决策路径 |
| 3 | fit(self, X, y[, sample_weight, …]) fit() 方法将从给定的训练集 (X, y)。 |
| 4 | get_depth(self) 顾名思义,此方法将返回决策树的深度 |
| 5 | get_n_leaves(self) 顾名思义,此方法将返回决策树的叶子节点数量。 |
| 6 | get_params(self[, deep]) 我们可以使用此方法获取估计器。 |
| 7 | predict(self, X[, check_input]) 它将预测 X 的类别值。 |
| 8 | predict_log_proba(self, X) 它将预测我们提供的输入样本 X 的类别对数概率。 |
| 9 | predict_proba(self, X[, check_input]) 它将预测我们,X。 |
| 10 | score(self, X, y[, sample_weight]) 顾名思义,score() 方法将返回给定测试数据和标签的平均准确率。. |
| 11 | set_params(self, \*\*params) 我们可以使用此方法设置估计器的参数。 |
实现示例
下面的 Python 脚本将使用 sklearn.tree.DecisionTreeClassifier 模块来构建一个用于从包含 25 个样本和两个特征(即"身高"和"头发长度")的数据集中预测男性或女性的分类器 −
from sklearn import tree
from sklearn.model_selection import train_test_split
X=[[165,19],[175,32],[136,35],[174,65],[141,28],[176,15]
,[131,32],[166,6],[128,32],[179,10],[136,34],[186,2],[12
6,25],[176,28],[112,38],[169,9],[171,36],[116,25],[196,2
5], [196,38], [126,40], [197,20], [150,25], [140,32],[136,35]]
Y=['Man','Woman','Woman','Man','Woman','Man','Woman','Ma
n','Woman','Man','Woman','Man','Woman','Woman','Woman','
Man','Woman','Woman','Man', 'Woman', 'Woman', 'Man', 'Man', 'Woman', 'Woman']
data_feature_names = ['height','length of hair']
X_train, X_test, y_train, y_test = train_test_split(X, Y, test_size = 0.3, random_state = 1)
DTclf = tree.DecisionTreeClassifier()
DTclf = clf.fit(X,Y)
prediction = DTclf.predict([[135,29]])
print(prediction)
输出
['Woman']
我们还可以使用以下 Python predict_proba() 方法预测每个类别的概率,如下所示 −
示例
prediction = DTclf.predict_proba([[135,29]])
print(prediction)
输出
[[0. 1.]]
决策树回归
在本例中,决策变量是连续变量。
Sklearn 模块 − Scikit-learn 库提供了名为 DecisionTreeRegressor 的模块,用于将决策树应用于回归问题。
参数
DecisionTreeRegressor 使用的参数与 DecisionTreeClassifier 模块中使用的参数几乎相同。区别在于"criterion"参数。对于 DecisionTreeRegressor 模块,criterion:字符串,可选,默认值为"mse",其值包括以下值 −
mse − 代表均方误差。它相当于方差减少,作为特征选择的标准。它使用每个终端节点的平均值来最小化 L2 损失。
freidman_mse −它也使用均方误差,但使用了 Friedman 改进分数。
mae − 代表平均绝对误差。它使用每个终端节点的中值来最小化 L1 损失。
另一个区别是它没有 'class_weight' 参数。
属性
DecisionTreeRegressor 的属性也与 DecisionTreeClassifier 模块的属性相同。区别在于它没有'classes_'和'n_classes_'属性。
方法
DecisionTreeRegressor的方法与DecisionTreeClassifier模块的方法相同。区别在于它没有'predict_log_proba()'和'predict_proba()'属性。
实现示例
决策树回归模型中的 fit() 方法将采用 y 的浮点值。让我们看一个简单的实现示例,使用 Sklearn.tree.DecisionTreeRegressor −
from sklearn import tree
X = [[1, 1], [5, 5]]
y = [0.1, 1.5]
DTreg = tree.DecisionTreeRegressor()
DTreg = clf.fit(X, y)
拟合完成后,我们可以使用该回归模型进行预测,如下所示 −
DTreg.predict([[4, 5]])
输出
array([1.5])
Scikit Learn - 随机决策树
本章将帮助您理解 Sklearn 中的随机决策树。
随机决策树算法
众所周知,决策树 (DT) 通常通过递归分割数据进行训练,但由于容易过拟合,因此通过在数据的不同子样本上训练多棵树,将其转换为随机森林。sklearn.ensemble 模块包含以下两种基于随机决策树的算法 −
随机森林算法
对于每个考虑的特征,它会计算局部最优的特征/分割组合。在随机森林中,集成中的每棵决策树都是从训练集中抽取的样本构建的,然后对每个样本进行预测,最终通过投票选出最佳方案。它既可以用于分类任务,也可以用于回归任务。
使用随机森林进行分类
为了创建随机森林分类器,Scikit-learn 模块提供了 sklearn.ensemble.RandomForestClassifier。在构建随机森林分类器时,该模块使用的主要参数是 'max_features' 和 'n_estimators'。
其中,'max_features' 表示在分割节点时要考虑的随机特征子集的大小。如果我们将此参数的值设置为 None,则它将考虑所有特征,而不是随机子集。另一方面,n_estimators 表示森林中树的数量。树的数量越多,结果越好。但计算时间也会更长。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.RandomForestClassifier 构建一个随机森林分类器,并使用 cross_val_score 模块检查其准确率。
from sklearn.model_selection import cross_val_score
from sklearn.datasets import make_blobs
from sklearn.ensemble import RandomForestClassifier
X, y = make_blobs(n_samples = 10000, n_features = 10, centres = 100, random_state = 0) RFclf = RandomForestClassifier(n_estimators = 10,max_depth = None,min_samples_split = 2, random_state = 0)
scores = cross_val_score(RFclf, X, y, cv = 5)
scores.mean()
输出
0.9997
示例
我们也可以使用 sklearn 数据集构建随机森林分类器。如下例所示,我们使用了鸢尾花数据集。我们还将计算其准确率和混淆矩阵。
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score

path = "https://archive.ics.uci.edu/ml/machine-learning-database
s/iris/iris.data"
headernames = ['sepal-length', 'sepal-width', 'petal-length', 'petal-width', 'Class']
dataset = pd.read_csv(path, names = headernames)
X = dataset.iloc[:, :-1].values
y = dataset.iloc[:, 4].values
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.30)
RFclf = RandomForestClassifier(n_estimators = 50)
RFclf.fit(X_train, y_train)
y_pred = RFclf.predict(X_test)
result = confusion_matrix(y_test, y_pred)
print("Confusion Matrix:")
print(result)
result1 = classification_report(y_test, y_pred)
print("Classification Report:",)
print (result1)
result2 = accuracy_score(y_test,y_pred)
print("Accuracy:",result2)
输出
Confusion Matrix:
[[14 0 0]
[ 0 18 1]
[ 0 0 12]]
Classification Report:
                  precision recall f1-score support
Iris-setosa       1.00        1.00  1.00     14
Iris-versicolor   1.00        0.95  0.97     19
Iris-virginica    0.92        1.00  0.96     12

micro avg         0.98        0.98  0.98     45
macro avg         0.97        0.98  0.98     45
weighted avg      0.98        0.98  0.98     45

Accuracy: 0.9777777777777777
使用随机森林进行回归
为了创建随机森林回归,Scikit-learn 模块提供了 sklearn.ensemble.RandomForestRegressor。构建随机森林回归器时,它将使用与 sklearn.ensemble.RandomForestClassifier 相同的参数。
实现示例
在以下示例中,我们使用 sklearn.ensemble.RandomForestregressor 构建随机森林回归器,并使用 predict() 方法预测新值。
from sklearn.ensemble import RandomForestRegressor
from sklearn.datasets import make_regression
X, y = make_regression(n_features = 10, n_informative = 2,random_state = 0, shuffle = False)
RFregr = RandomForestRegressor(max_depth = 10,random_state = 0,n_estimators = 100)
RFregr.fit(X, y)
输出
RandomForestRegressor(
   bootstrap = True, criterion = 'mse', max_depth = 10,
   max_features = 'auto', max_leaf_nodes = None,
   min_impurity_decrease = 0.0, min_impurity_split = None,
   min_samples_leaf = 1, min_samples_split = 2,
   min_weight_fraction_leaf = 0.0, n_estimators = 100, n_jobs = None,
   oob_score = False, random_state = 0, verbose = 0, warm_start = False
)
拟合完成后,我们可以从回归模型中预测如下 −
print(RFregr.predict([[0, 2, 3, 0, 1, 1, 1, 1, 2, 2]]))
输出
[98.47729198]
额外树方法
对于每个考虑的特征,它会选择一个随机值进行拆分。使用额外树方法的好处是可以进一步降低模型的方差。使用这些方法的缺点是会稍微增加偏差。
使用 Extra-Tree 方法进行分类
为了使用 Extra-Tree 方法创建分类器,Scikit-learn 模块提供了 sklearn.ensemble.ExtraTreesClassifier。它使用的参数与 sklearn.ensemble.RandomForestClassifier 相同。唯一的区别在于上面讨论的构建树的方式。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.ExtraTreeClassifier 构建一个随机森林分类器,并使用 cross_val_score 模块检查其准确率。
from sklearn.model_selection import cross_val_score
from sklearn.datasets import make_blobs
from sklearn.ensemble import ExtraTreesClassifier
X, y = make_blobs(n_samples = 10000, n_features = 10, centres=100, random_state = 0)
ETclf = ExtraTreesClassifier(n_estimators = 10,max_depth = None,min_samples_split = 10, random_state = 0)
scores = cross_val_score(ETclf, X, y, cv = 5)
scores.mean()
输出
1.0
示例
我们也可以使用 sklearn 数据集,通过 Extra-Tree 方法构建分类器。如下例所示,我们使用了 Pima-Indian 数据集。
from pandas import read_csv

from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import ExtraTreesClassifier
path = r"C:\pima-indians-diabetes.csv"
headernames = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
data = read_csv(path, names=headernames)
array = data.values
X = array[:,0:8]
Y = array[:,8]
seed = 7
kfold = KFold(n_splits=10, random_state=seed)
num_trees = 150
max_features = 5
ETclf = ExtraTreesClassifier(n_estimators=num_trees, max_features=max_features)
results = cross_val_score(ETclf, X, Y, cv=kfold)
print(results.mean())
输出
0.7551435406698566
使用 ExtraTree 方法进行回归
为了创建 ExtraTree 回归,Scikit-learn 模块提供了 sklearn.ensemble.ExtraTreesRegressor。构建随机森林回归器时,它将使用与 sklearn.ensemble.ExtraTreesClassifier 相同的参数。
实现示例
在下面的示例中,我们将应用 sklearn.ensemble.ExtraTreesregressor,并使用与创建随机森林回归器相同的数据。让我们看看输出结果的区别
from sklearn.ensemble import ExtraTreesRegressor
from sklearn.datasets import make_regression
X, y = make_regression(n_features = 10, n_informative = 2,random_state = 0, shuffle = False)
ETregr = ExtraTreesRegressor(max_depth = 10,random_state = 0,n_estimators = 100)
ETregr.fit(X, y)
输出
ExtraTreesRegressor(bootstrap = False, criterion = 'mse', max_depth = 10,
   max_features = 'auto', max_leaf_nodes = None,
   min_impurity_decrease = 0.0, min_impurity_split = None,
   min_samples_leaf = 1, min_samples_split = 2,
   min_weight_fraction_leaf = 0.0, n_estimators = 100, n_jobs = None,
   oob_score = False, random_state = 0, verbose = 0, warm_start = False)
示例
拟合后,我们可以从回归模型预测如下 −
print(ETregr.predict([[0, 2, 3, 0, 1, 1, 1, 1, 2, 2]]))
输出
[85.50955817]
Scikit Learn - Boosting 方法
在本章中,我们将学习 Sklearn 中的 Boosting 方法,该方法可用于构建集成模型。
Boosting 方法以增量方式构建集成模型。其主要原理是通过顺序训练每个基础模型估计器来逐步构建模型。为了构建强大的集成模型,这些方法基本上将几个周学习器组合在一起,这些学习器在训练数据的多次迭代中顺序训练。sklearn.ensemble 模块包含以下两种 Boosting 方法。
AdaBoost
它是最成功的 Boosting 集成方法之一,其关键在于赋予数据集中实例权重的方式。这就是为什么算法在构建后续模型时不需要过多关注实例。
使用 AdaBoost 进行分类
为了创建 AdaBoost 分类器,Scikit-learn 模块提供了 sklearn.ensemble.AdaBoostClassifier。在构建此分类器时,该模块使用的主要参数是 base_estimator。其中,base_estimator 是构建增强集成所基于的 基估计器 的值。如果我们将此参数的值设为 None,则基础估计器将为 DecisionTreeClassifier(max_depth=1)。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.AdaBoostClassifier 构建一个 AdaBoost 分类器,并预测和检查其得分。
from sklearn.ensemble import AdaBoostClassifier
from sklearn.datasets import make_classification
X, y = make_classification(n_samples = 1000, n_features = 10, n_informative = 2, n_redundant = 0, random_state = 0, shuffle = False)
ADBclf = AdaBoostClassifier(n_estimators = 100, random_state = 0)
ADBclf.fit(X, y)
输出
AdaBoostClassifier(algorithm = 'SAMME.R', base_estimator = None,
learning_rate = 1.0, n_estimators = 100, random_state = 0)
示例
拟合完成后,我们可以预测新的值,如下所示 −
print(ADBclf.predict([[0, 2, 3, 0, 1, 1, 1, 1, 2, 2]]))
输出
[1]
示例
现在我们可以用如下方式检查分数 −
ADBclf.score(X, y)
输出
0.995
示例
我们也可以使用 sklearn 数据集,通过 Extra-Tree 方法构建分类器。例如,在下面给出的示例中,我们使用了 Pima-Indian 数据集。
from pandas import read_csv
from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import AdaBoostClassifier
path = r"C:\pima-indians-diabetes.csv"
headernames = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
data = read_csv(path, names = headernames)
array = data.values
X = array[:,0:8]
Y = array[:,8]
seed = 5
kfold = KFold(n_splits = 10, random_state = seed)
num_trees = 100
max_features = 5
ADBclf = AdaBoostClassifier(n_estimators = num_trees, max_features = max_features)
results = cross_val_score(ADBclf, X, Y, cv = kfold)
print(results.mean())
输出
0.7851435406698566
使用 AdaBoost 进行回归
为了使用 Ada Boost 方法创建回归器,Scikit-learn 库提供了 sklearn.ensemble.AdaBoostRegressor。构建回归器时,它将使用与 sklearn.ensemble.AdaBoostClassifier 相同的参数。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.AdaBoostregressor 构建 AdaBoost 回归器,并使用 predict() 方法预测新值。
from sklearn.ensemble import AdaBoostRegressor
from sklearn.datasets import make_regression
X, y = make_regression(n_features = 10, n_informative = 2,random_state = 0, shuffle = False)
ADBregr = RandomForestRegressor(random_state = 0,n_estimators = 100)
ADBregr.fit(X, y)
输出
AdaBoostRegressor(base_estimator = None, learning_rate = 1.0, loss = 'linear',
n_estimators = 100, random_state = 0)
示例
拟合后,我们可以从回归模型中预测如下 −
print(ADBregr.predict([[0, 2, 3, 0, 1, 1, 1, 1, 2, 2]]))
输出
[85.50955817]
梯度树提升
它是也称为梯度提升回归树 (GRBT)。它本质上是将提升算法推广到任意可微损失函数。它以弱预测模型集成的形式生成预测模型。它可用于回归和分类问题。其主要优势在于能够自然地处理混合类型数据。
使用梯度提升树进行分类
为了创建梯度提升树分类器,Scikit-learn 模块提供了 sklearn.ensemble.GradientBoostingClassifier。在构建此分类器时,此模块使用的主要参数是"loss"。此处,"loss"是需要优化的损失函数值。如果我们选择 loss = deviance,则它指的是具有概率输出的分类的偏差。
另一方面,如果我们将此参数的值设置为指数,则它将恢复为 AdaBoost 算法。参数 n_estimators 将控制周学习器的数量。名为 learning_rate 的超参数(取值范围为 (0.0, 1.0])将通过收缩来控制过拟合。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.GradientBoostingClassifier 构建一个梯度提升分类器。我们将使用 50 个周学习器来拟合该分类器。
from sklearn.datasets import make_hastie_10_2
from sklearn.ensemble import GradientBoostingClassifier
X, y = make_hastie_10_2(random_state = 0)
X_train, X_test = X[:5000], X[5000:]
y_train, y_test = y[:5000], y[5000:]

GDBclf = GradientBoostingClassifier(n_estimators = 50, learning_rate = 1.0,max_depth = 1, random_state = 0).fit(X_train, y_train)
GDBclf.score(X_test, y_test)
输出
0.8724285714285714
示例
我们也可以使用 sklearn 数据集,通过梯度提升分类器构建分类器。如下例所示,我们使用 Pima-Indian 数据集。
from pandas import read_csv
from sklearn.model_selection import KFold
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import GradientBoostingClassifier
path = r"C:\pima-indians-diabetes.csv"
headernames = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
data = read_csv(path, names = headernames)
array = data.values
X = array[:,0:8]
Y = array[:,8]
seed = 5
kfold = KFold(n_splits = 10, random_state =种子)
num_trees = 100
max_features = 5
ADBclf = GradientBoostingClassifier(n_estimators = num_trees, max_features = max_features)
results = cross_val_score(ADBclf, X, Y, cv = kfold)
print(results.mean())
输出
0.7946582356674234
使用梯度树提升方法进行回归
为了使用梯度树提升方法创建回归器,Scikit-learn 库提供了 sklearn.ensemble.GradientBoostingRegressor。它可以通过参数名称 loss 指定回归的损失函数。损失函数的默认值为"ls"。
实现示例
在下面的示例中,我们使用 sklearn.ensemble.GradientBoostingregressor 构建了一个梯度提升回归器,并使用 mean_squared_error() 方法计算均方误差。
import numpy as np
from sklearn.metrics import mean_squared_error
from sklearn.datasets import make_friedman1
from sklearn.ensemble import GradientBoostingRegressor
X, y = make_friedman1(n_samples = 2000, random_state = 0, noise = 1.0)
X_train, X_test = X[:1000], X[1000:]
y_train, y_test = y[:1000], y[1000:]
GDBreg = GradientBoostingRegressor(n_estimators = 80, learning_rate=0.1,
max_depth = 1, random_state = 0, loss = 'ls').fit(X_train, y_train)
拟合完成后,我们可以得到如下的均方误差 −
mean_squared_error(y_test, GDBreg.predict(X_test))
输出
5.391246106657164
Scikit Learn - 聚类方法
本文将学习 Sklearn 中的聚类方法,这些方法有助于识别数据样本中的相似性。
聚类方法是最有用的无监督机器学习方法之一,用于查找数据样本之间的相似性和关系模式。之后,它们根据特征将这些样本聚类成具有相似性的组。聚类决定了当前未标记数据的内在分组,因此它非常重要。
Scikit-learn 库中有 sklearn.cluster 来对未标记数据进行聚类。在此模块下,scikit-learn 提供了以下聚类方法 −
KMeans
该算法计算质心并迭代,直到找到最优质心。它需要指定聚类的数量,因此它假设聚类数量是已知的。该算法的主要逻辑是通过最小化惯性标准(称为惯性)将数据聚类,从而将样本分成 n 个方差相等的组。算法识别出的聚类数量用"K"表示。
Scikit-learn 包含 sklearn.cluster.KMeans 模块来执行 K 均值聚类。在计算聚类中心和惯性值时,名为 sample_weight 的参数允许 sklearn.cluster.KMeans 模块为某些样本分配更大的权重。
亲和传播
该算法基于不同样本对之间"消息传递"的概念,直至收敛。运行算法之前无需指定聚类数量。该算法的时间复杂度为𝑂(𝑁2𝑇)量级,这是其最大的缺点。
Scikit-learn 包含 sklearn.cluster.AffinityPropagation 模块来执行亲和传播聚类。
均值漂移
该算法主要在样本密度均匀分布的blob中发现数据点。它通过将数据点向数据点密度最高的方向移动,迭代地将数据点分配到聚类中。它不再依赖名为 bandwidth 的参数来指定搜索区域的大小,而是自动设置聚类的数量。
Scikit-learn 拥有 sklearn.cluster.MeanShift 模块来执行 Mean Shift 聚类。
谱聚类
在聚类之前,该算法基本上使用特征值(即数据相似矩阵的谱)在较少的维度上进行降维。当聚类数量较多时,不建议使用此算法。
Scikit-learn 拥有 sklearn.cluster.SpectralClustering 模块来执行谱聚类。
层次聚类
该算法通过连续合并或拆分聚类来构建嵌套聚类。这种聚类层次结构以树状图(即树)的形式表示。它分为以下两类 −
凝聚型分层算法 − 在这种分层算法中,每个数据点都被视为一个单独的聚类。然后,它会依次聚合成对的聚类。这采用自下而上的方法。
分裂型分层算法 − 在这种分层算法中,所有数据点都被视为一个大聚类。在此过程中,聚类过程涉及使用自上而下的方法将一个大聚类划分为多个小聚类。
Scikit-learn 具有 sklearn.cluster.AgglomerativeClustering 模块来执行凝聚型分层聚类。
DBSCAN
它代表"基于密度的噪声空间聚类"。该算法基于"聚类"和"噪声"的直观概念,即聚类是数据空间中密度较低的密集区域,由密度较低的数据点区域分隔。
Scikit-learn 包含 sklearn.cluster.DBSCAN 模块来执行 DBSCAN 聚类。该算法使用两个重要参数 min_samples 和 eps 来定义稠密程度。
参数 min_samples 的较高值或参数 eps 的较低值表示形成聚类所需的数据点密度较高。
OPTICS
它代表"对点进行排序以识别聚类结构"。该算法还可以在空间数据中查找基于密度的聚类。它的基本工作逻辑类似于 DBSCAN。
它解决了 DBSCAN 算法的一个主要弱点——在不同密度的数据中检测有意义的聚类的问题——通过对数据库中的点进行排序,使空间上最接近的点在排序中成为邻居。
Scikit-learn 有 sklearn.cluster.OPTICS 模块来执行 OPTICS 聚类。
BIRCH
它代表使用层次结构的平衡迭代约简和聚类。它用于对大型数据集执行层次聚类。它为给定数据构建一棵名为 CFT 的树,即 特征树。
CFT 的优势在于,名为 CF(特征树)的数据节点保存了聚类所需的信息,从而进一步避免了将整个输入数据保存在内存中的需要。
Scikit-learn 具有 sklearn.cluster.Birch 模块来执行 BIRCH 聚类。
聚类算法比较
下表将对 scikit-learn 中的聚类算法进行基于参数、可扩展性和度量的比较。
| Sr.No | 算法名称 | 参数 | 可扩展性 | 使用的指标 |
|---|---|---|---|---|
| 1 | K-Means | 否聚类数量 | 非常大的 n_samples | 点与点之间的距离 |
| 2 | 亲和传播 | 阻尼 | 无法通过 n_samples 进行扩展 | 图距离 |
| 3 | 均值漂移 | 带宽 | 无法通过 n_samples 进行扩展 | 点与点之间的距离 |
| 4 | 谱聚类 | 聚类数量 | 中等使用 n_samples 实现高可扩展性。 使用 n_clusters 实现低可扩展性。 | 图距离 |
| 5 | 层次聚类 | 距离阈值或聚类数量 | 较大的 n_samples 较大的 n_clusters | 点之间的距离。 |
| 6 | DBSCAN | 邻域大小 | 样本数非常大,簇数中等。 | 最近点距离 |
| 7 | OPTICS | 最小聚类成员 | 样本数非常大,簇数较大。 | 点与点之间的距离。 |
| 8 | BIRCH | 阈值,分支因子 | 样本数较大 簇数较大 | 点与点之间的欧氏距离点。 |
在 Scikit-learn 数字数据集上进行 K 均值聚类
在本例中,我们将在数字数据集上应用 K 均值聚类。该算法无需使用原始标签信息即可识别相似的数字。实现在 Jupyter Notebook 上完成。
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np
from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
输出
1797, 64)
此输出显示数字数据集包含 1797 个样本,每个样本包含 64 个特征。
示例
现在,按如下方式执行 K-Means 聚类 −
kmeans = KMeans(n_clusters = 10, random_state = 0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
输出
(10, 64)
此输出显示 K-means 聚类创建了 10 个聚类,每个聚类包含 64 个特征特征。
示例
fig, ax = plt.subplots(2, 5, figsize = (8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centres):
axi.set(xticks = [], yticks = [])
axi.imshow(center, interpolation = 'nearest', cmap = plt.cm.binary)
输出
以下输出包含通过 K-Means 聚类学习到的聚类中心图像。
接下来,下面的 Python 脚本将匹配学习到的聚类标签(通过 K-Means 算法)与其中找到的真实标签之差 −
from scipy.stats import mode
labels = np.zeros_like(clusters)
for i in range(10):
mask = (clusters == i)
labels[mask] = mode(digits.target[mask])[0]
我们也可以借助以下命令检查准确率。
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, label)
输出
0.7935447968836951
完整实现示例
%matplotlib inline
import matplotlib.pyplot as plt
import seaborn as sns; sns.set()
import numpy as np

from sklearn.cluster import KMeans
from sklearn.datasets import load_digits
digits = load_digits()
digits.data.shape
kmeans = KMeans(n_clusters = 10, random_state = 0)
clusters = kmeans.fit_predict(digits.data)
kmeans.cluster_centers_.shape
fig, ax = plt.subplots(2, 5, figsize = (8, 3))
centers = kmeans.cluster_centers_.reshape(10, 8, 8)
for axi, center in zip(ax.flat, centers):
   axi.set(xticks=[], yticks = [])
   axi.imshow(center, interpolation = 'nearest', cmap = plt.cm.binary)
from scipy.stats import mode
labels = np.zeros_like(clusters)
for i in range(10):
   mask = (clusters == i)
   labels[mask] = mode(digits.target[mask])[0]
from sklearn.metrics import accuracy_score
accuracy_score(digits.target, labels)
Scikit Learn - 聚类性能评估
我们可以借助各种函数来评估聚类算法的性能。
以下是 Scikit-learn 提供的一些用于评估聚类性能的重要且最常用的函数 −
调整后的随机数指数
随机数指数是一个计算两个聚类之间相似性度量的函数。在此计算中,随机数指数会考虑所有样本对,并统计预测聚类和真实聚类中被分配到相似或不同聚类的样本对。之后,使用以下公式将原始兰德指数得分"根据概率进行调整",得到调整后的兰德指数得分:Ⅹ
$$Adjusted\:RI=\left(RI-Expected_{-}RI ight)/\left(max\left(RI ight)-Expected_{-}RI ight)$$它包含两个参数,分别为 labels_true(真实类别标签)和 labels_pred(待评估的聚类标签)。
示例
from sklearn.metrics.cluster import adjusted_rand_score

   labels_true = [0, 0, 1, 1, 1, 1]
   labels_pred = [0, 0, 2, 2, 3, 3]

adjusted_rand_score(labels_true, labels_pred)
输出
0.4444444444444445
完美标注得分为 1,不良标注或独立标注得分为 0 或负数。
基于互信息的评分
互信息是一个计算两个赋值一致性的函数。它忽略排列。有以下版本可用 −
归一化互信息 (NMI)
Scikit-learn 包含 sklearn.metrics.normalized_mutual_info_score 模块。
示例
from sklearn.metrics.cluster import normalized_mutual_info_score

   labels_true = [0, 0, 1, 1, 1, 1]
   labels_pred = [0, 0, 2, 2, 3, 3]

normalized_mutual_info_score (labels_true, labels_pred)
输出
0.7611702597222881
调整相互信息 (AMI)
Scikit-learn 包含 sklearn.metrics.adjusted_mutual_info_score 模块。
示例
from sklearn.metrics.cluster import adjusted_mutual_info_score

   labels_true = [0, 0, 1, 1, 1, 1]
   labels_pred = [0, 0, 2, 2, 3, 3]

adjusted_mutual_info_score (labels_true, labels_pred)
输出
0.4444444444444448
Fowlkes-Mallows 得分
Fowlkes-Mallows 函数用于测量一组点的两个聚类的相似性。它可以定义为成对精确度和召回率的几何平均值。
数学上:
$$FMS=\frac{TP}{\sqrt{\left(TP+FP ight)\left(TP+FN ight)}}$$其中,TP = 真阳性 − 表示在真实标签和预测标签中都属于同一聚类的点对数量。
FP = 假阳性 −在真实标签中属于同一聚类但不在预测标签中的点对数量。
FN = 假阴性 − 在预测标签中属于同一聚类但不在真实标签中的点对数量。
Scikit-learn 包含 sklearn.metrics.fowlkes_mallows_score 模块 −
示例
from sklearn.metrics.cluster import fowlkes_mallows_score

   labels_true = [0, 0, 1, 1, 1, 1]
   labels_pred = [0, 0, 2, 2, 3, 3]

fowlkes_mallows__score (labels_true, labels_pred)
输出
0.6546536707079771
轮廓系数
Silhouette 函数将使用每个样本的平均类内距离和平均最近类距离计算所有样本的平均轮廓系数。
数学上:
$$S=\left(b-a ight)/max\left(a,b ight)$$其中,a 是类内距离。
b 是平均最近类距离。
Scikit-learn 包含 sklearn.metrics.silhouette_score 模块 −
示例
from sklearn import metrics.silhouette_score
from sklearn.metrics import pairwise_distances
from sklearn import datasets
import numpy as np
from sklearn.cluster import KMeans
dataset = datasets.load_iris()
X = dataset.data
y = dataset.target

kmeans_model = KMeans(n_clusters = 3, random_state = 1).fit(X)
labels = kmeans_model.labels_
silhouette_score(X, labels, metric = 'euclidean')
输出
0.5528190123564091
列联矩阵
此矩阵将报告每个可信对(真实值,预测值)的交集基数。分类问题的混淆矩阵是一个方阵列联矩阵。
Scikit-learn 包含 sklearn.metrics.contingency_matrix 模块。
示例
from sklearn.metrics.cluster import contingency_matrix
x = ["a", "a", "a", "b", "b", "b"]
y = [1, 1, 2, 0, 1, 2]
contingency_matrix(x, y)
输出
array([
[0, 2, 1],
[1, 1, 1]
])
上述输出的第一行显示,在三个真实聚类为"a"的样本中,没有一个属于聚类 0,两个属于聚类 1,一个属于聚类 2。另一方面,第二行显示,在三个真实聚类为"b"的样本中,1 个属于聚类 0,1 个属于聚类 1,1 个属于聚类 2。
Scikit Learn - 使用主成分分析 (PCA) 进行降维
降维是一种无监督机器学习方法,用于减少每个数据样本的特征变量数量,从而选择一组主要特征。主成分分析 (PCA) 是常用的降维算法之一。
精确主成分分析 (PCA)
主成分分析 (PCA) 用于线性降维,使用数据的奇异值分解 (SVD) 将数据投影到低维空间。在使用 PCA 进行分解时,输入数据在应用 SVD 之前会进行中心化处理,但不会针对每个特征进行缩放。
Scikit-learn ML 库提供了 sklearn.decomposition.PCA 模块,该模块以 Transformer 对象的形式实现,并在其 fit() 方法中学习 n 个组件。它也可以用于新数据,将其投影到这些成分上。
示例
以下示例将使用 sklearn.decomposition.PCA 模块从 Pima Indians Diabetes 数据集中查找最佳的 5 个主成分。
from pandas import read_csv
from sklearn.decomposition import PCA
path = r'C:\Users\Leekha\Desktop\pima-indians-diabetes.csv'
names = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
dataframe = read_csv(path, names = names)
array = dataframe.values
X = array[:,0:8]
Y = array[:,8]
pca = PCA(n_components = 5)
fit = pca.fit(X)
print(("Explained Variance: %s") % (fit.explained_variance_ratio_))
print(fit.components_)
输出
Explained Variance: [0.88854663 0.06159078 0.02579012 0.01308614 0.00744094]
[
   [-2.02176587e-03 9.78115765e-02 1.60930503e-02 6.07566861e-029.93110844e-01 1.40108085e-02 5.37167919e-04 -3.56474430e-03]
   [-2.26488861e-02 -9.72210040e-01 -1.41909330e-01 5.78614699e-029.46266913e-02 -4.69729766e-02 -8.16804621e-04 -1.40168181e-01]
   [-2.24649003e-02 1.43428710e-01 -9.22467192e-01 -3.07013055e-012.09773019e-02 -1.32444542e-01 -6.39983017e-04 -1.25454310e-01]
   [-4.90459604e-02 1.19830016e-01 -2.62742788e-01 8.84369380e-01-6.55503615e-02 1.92801728e-01 2.69908637e-03 -3.01024330e-01]
   [ 1.51612874e-01 -8.79407680e-02 -2.32165009e-01 2.59973487e-01-1.72312241e-04 2.14744823e-02 1.64080684e-03 9.20504903e-01]
]
增量主成分分析
增量主成分分析 (IPCA) 用于解决主成分分析 (PCA) 的最大局限性,即 PCA 仅支持批处理,这意味着所有待处理的输入数据都必须加载到内存中。
Scikit-learn 机器学习库提供了 sklearn.decomposition.IPCA 模块,该模块可以通过对顺序获取的数据块使用其 partial_fit 方法,或启用内存映射文件 np.memmap 来实现核外 PCA,而无需将整个文件加载到内存中。
与 PCA 相同,使用 IPCA 进行分解时,输入数据会居中,但在应用 SVD 之前不会针对每个特征进行缩放。
示例
以下示例将使用Sklearn 数字数据集上的 sklearn.decomposition.IPCA 模块。
from sklearn.datasets import load_digits
from sklearn.decomposition import IncrementalPCA
X, _ = load_digits(return_X_y = True)
transformer = IncrementalPCA(n_components = 10, batch_size = 100)
transformer.partial_fit(X[:100, :])
X_transformed = transform.fit_transform(X)
X_transformed.shape
输出
(1797, 10)
在这里,我们可以对较小的数据批次进行部分拟合(就像我们对每批次 100 个数据所做的那样),或者你可以让fit() 函数将数据分成批次。
核主成分分析 (PCA)
核主成分分析是 PCA 的扩展,它使用核实现非线性降维。它支持 transform 和 inverse_transform。
Scikit-learn 机器学习库提供了 sklearn.decomposition.KernelPCA 模块。
示例
以下示例将在 Sklearn 数字数据集上使用 sklearn.decomposition.KernelPCA 模块。我们使用 S 型核。
from sklearn.datasets import load_digits
from sklearn.decomposition import KernelPCA
X, _ = load_digits(return_X_y = True)
transformer = KernelPCA(n_components = 10, kernel = 'sigmoid')
X_transformed = transformer.fit_transform(X)
X_transformed.shape
Output
(1797, 10)
使用随机 SVD 的主成分分析 (PCA)
使用随机 SVD 的主成分分析 (PCA) 用于将数据投影到低维空间,通过丢弃与较低奇异值相关的成分的奇异向量来保留大部分方差。在这里,带有可选参数 svd_solver='randomized' 的 sklearn.decomposition.PCA 模块将非常有用。
示例
以下示例将使用带有可选参数 svd_solver='randomized' 的 sklearn.decomposition.PCA 模块从 Pima Indians Diabetes 数据集中查找最佳的 7 个主成分。
from pandas import read_csv
from sklearn.decomposition import PCA
path = r'C:\Users\Leekha\Desktop\pima-indians-diabetes.csv'
names = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
dataframe = read_csv(path, names = names)
array = dataframe.values
X = array[:,0:8]
Y = array[:,8]
pca = PCA(n_components = 7,svd_solver = 'randomized')
fit = pca.fit(X)
print(("Explained Variance: %s") % (fit.explained_variance_ratio_))
print(fit.components_)
输出
Explained Variance: [8.88546635e-01 6.15907837e-02 2.57901189e-02 1.30861374e-027.44093864e-03 3.02614919e-03 5.12444875e-04]
[
   [-2.02176587e-03 9.78115765e-02 1.60930503e-02 6.07566861e-029.93110844e-01 1.40108085e-02 5.37167919e-04 -3.56474430e-03]
   [-2.26488861e-02 -9.72210040e-01 -1.41909330e-01 5.78614699e-029.46266913e-02 -4.69729766e-02 -8.16804621e-04 -1.40168181e-01]
   [-2.24649003e-02 1.43428710e-01 -9.22467192e-01 -3.07013055e-012.09773019e-02 -1.32444542e-01 -6.39983017e-04 -1.25454310e-01]
   [-4.90459604e-02 1.19830016e-01 -2.62742788e-01 8.84369380e-01-6.55503615e-02 1.92801728e-01 2.69908637e-03 -3.01024330e-01]
   [ 1.51612874e-01 -8.79407680e-02 -2.32165009e-01 2.59973487e-01-1.72312241e-04 2.14744823e-02 1.64080684e-03 9.20504903e-01]
   [-5.04730888e-03 5.07391813e-02 7.56365525e-02 2.21363068e-01-6.13326472e-03 -9.70776708e-01 -2.02903702e-03 -1.51133239e-02]
   [ 9.86672995e-01 8.83426114e-04 -1.22975947e-03 -3.76444746e-041.42307394e-03 -2.73046214e-03 -6.34402965e-03 -1.62555343e-01]
]

