
Scikit Learn - 数据表示
众所周知,机器学习的核心是从数据中创建模型。为此,计算机必须首先理解数据。接下来,我们将讨论各种表示数据的方式,以便计算机能够理解 −
数据以表格形式呈现
在 Scikit-learn 中,表格是数据表示的最佳方式。表格表示二维数据网格,其中行表示数据集中的各个元素,列表示与这些各个元素相关的数量。
示例
通过以下示例,我们可以借助 Python seaborn 库,以 Pandas DataFrame 的形式下载 iris 数据集。
import seaborn as sns
iris = sns.load_dataset('iris')
iris.head()
输出
sepal_length sepal_width petal_length petal_width  species
0        5.1      3.5         1.4             0.2   setosa
1        4.9      3.0         1.4             0.2   setosa
2        4.7      3.2         1.3             0.2   setosa
3        4.6      3.1         1.5             0.2   setosa
4        5.0      3.6         1.4             0.2   setosa
从上面的输出中,我们可以看到数据的每一行代表一朵观察到的花,行数代表数据集中花的总数。通常,我们将矩阵的行称为样本。
另一方面,数据的每一列代表描述每个样本的定量信息。通常,我们将矩阵的列称为特征。
数据作为特征矩阵
特征矩阵可以定义为表格布局,其中信息可以被认为是一个二维矩阵。它存储在名为 X 的变量中,并假定为二维矩阵,形状为 [n_samples, n_features]。通常,它包含在 NumPy 数组或 Pandas DataFrame 中。如前所述,样本始终代表数据集中描述的单个对象,而特征则代表以定量方式描述每个样本的不同观测值。
数据作为目标数组
除了特征矩阵(用 X 表示)之外,我们还有一个目标数组。它也被称为标签。用 y 表示。标签或目标数组通常是一维的,长度为 n_samples。它通常包含在 NumPy 数组 或 Pandas Series 中。目标数组可能包含连续数值和离散值。
目标数组与特征列有何不同?
我们可以通过一点来区分两者:目标数组通常是我们想要从数据中预测的数量,即从统计学角度来看,它是因变量。
示例
在下面的示例中,我们根据鸢尾花数据集中的其他测量值来预测花的种类。在本例中,"种类"列将被视为特征。
import seaborn as sns
iris = sns.load_dataset('iris')
%matplotlib inline
import seaborn as sns; sns.set()
sns.pairplot(iris, hue='species', height=3);
输出
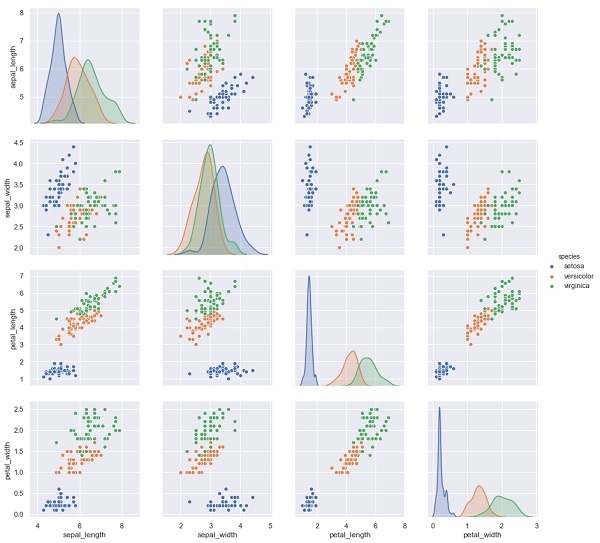
X_iris = iris.drop('species', axis=1)
X_iris.shape
y_iris = iris['species']
y_iris.shape
输出
(150,4)
(150,)

