
Scikit Learn - KNeighborsClassifier
此分类器名称中的 K 代表 k 个最近邻,其中 k 是用户指定的整数值。因此,顾名思义,此分类器基于 k 个最近邻进行学习。k 值的选择取决于数据。让我们借助一个实现示例 − 来更深入地理解它。
实现示例
在本例中,我们将使用 scikit-learn 的 KneighborsClassifer 方法,在名为 Iris Flower 的数据集上实现 KNN。
该数据集包含每种鸢尾花(setosa、versicolor、virginica)各 50 个样本,即总共 150 个样本。
每个样本有 4 个特征,分别为萼片长度、萼片宽度、花瓣长度、花瓣宽度。
首先,导入数据集并打印特征名称,如下所示 −
from sklearn.datasets import load_iris
iris = load_iris()
print(iris.feature_names)
输出
['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
示例
现在我们可以打印目标值,即代表不同物种的整数。这里 0 = setos,1 = versicolor,2 = virginica。
print(iris.target)
输出
[
   0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
   0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
   1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 2 2 2 2 2 2 2 2 2 2
   2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2 2
   2 2
]
示例
以下代码行将显示目标的名称 −
print(iris.target_names)
输出
['setosa' 'versicolor' 'virginica']
示例
我们可以借助以下代码行检查观测值和特征的数量(鸢尾花数据集包含 150 个观测值和 4 个特征)
print(iris.data.shape)
输出
(150, 4)
现在,我们需要将数据拆分为训练集和测试数据。我们将使用 Sklearn 的 train_test_split 函数将数据按 70(训练数据)和 30(测试数据)的比例拆分。−
X = iris.data[:, :4]
y = iris.target
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.30)
接下来,我们将借助 Sklearn 预处理模块进行数据缩放,如下所示 −
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)
示例
以下代码行将提供训练和测试对象的形状 −
print(X_train.shape)
print(X_test.shape)
输出
(105, 4)
(45, 4)
示例
以下代码行将为您提供新的 y 对象的形状 −
print(y_train.shape)
print(y_test.shape)
输出
(105,)
(45,)
接下来,从 Sklearn 导入 KneighborsClassifier 类,如下所示 −
from sklearn.neighbors import KNeighborsClassifier
为了检查准确率,我们需要导入 Metrics 模型如下 −
from sklearn import metrics
We are going to run it for k = 1 to 15 and will be recording testing accuracy, plotting it, showing confusion matrix and classification report:
Range_k = range(1,15)
scores = {}
scores_list = []
for k in range_k:
   classifier = KNeighborsClassifier(n_neighbors=k)
   classifier.fit(X_train, y_train)
   y_pred = classifier.predict(X_test)
   scores[k] = metrics.accuracy_score(y_test,y_pred)
   scores_list.append(metrics.accuracy_score(y_test,y_pred))
result = metrics.confusion_matrix(y_test, y_pred)
print("Confusion Matrix:")
print(result)
result1 = metrics.classification_report(y_test, y_pred)
print("Classification Report:",)
print (result1)
示例
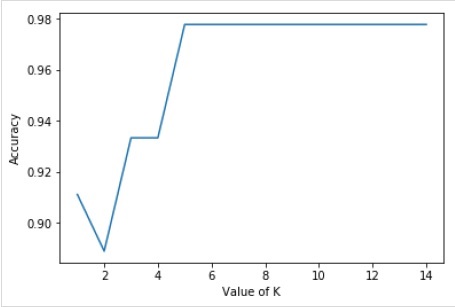
现在,我们将绘制 K 值与相应测试准确率之间的关系。这将使用 matplotlib 库完成。
%matplotlib inline
import matplotlib.pyplot as plt
plt.plot(k_range,scores_list)
plt.xlabel("K 值")
plt.ylabel("准确率")
输出
Confusion Matrix:
[
   [15 0 0]
   [ 0 15 0]
   [ 0 1 14]
]
Classification Report:
            precision   recall   f1-score    support
         0     1.00     1.00        1.00        15
         1     0.94     1.00        0.97        15
         2     1.00     0.93        0.97        15

micro avg      0.98     0.98        0.98        45
macro avg      0.98     0.98        0.98        45
weighted avg   0.98     0.98        0.98        45

Text(0, 0.5, 'Accuracy')
示例
对于上述模型,我们可以将 K 的最优值(6 到 14 之间的任意值,因为此范围内准确率最高)选为 8,并按如下方式重新训练模型 −
classifier = KNeighborsClassifier(n_neighbors = 8)
classifier.fit(X_train, y_train)
输出
KNeighborsClassifier(
   algorithm = 'auto', leaf_size = 30, metric = 'minkowski',
   metric_params = None, n_jobs = None, n_neighbors = 8, p = 2,
   weights = 'uniform'
)
classes = {0:'setosa',1:'versicolor',2:'virginicia'}
x_new = [[1,1,1,1],[4,3,1.3,0.2]]
y_predict = rnc.predict(x_new)
print(classes[y_predict[0]])
print(classes[y_predict[1]])
输出
virginicia
virginicia
完整的可运行/可执行程序
from sklearn.datasets import load_iris
iris = load_iris()
print(iris.target_names)
print(iris.data.shape)
X = iris.data[:, :4]
y = iris.target

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.30)

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)

print(X_train.shape)
print(X_test.shape)

from sklearn.neighbors import KNeighborsClassifier

from sklearn import metrics

Range_k = range(1,15)
scores = {}
scores_list = []
for k in range_k:
   classifier = KNeighborsClassifier(n_neighbors=k)
   classifier.fit(X_train, y_train)
   y_pred = classifier.predict(X_test)
   scores[k] = metrics.accuracy_score(y_test,y_pred)
   scores_list.append(metrics.accuracy_score(y_test,y_pred))
result = metrics.confusion_matrix(y_test, y_pred)
print("Confusion Matrix:")
print(result)
result1 = metrics.classification_report(y_test, y_pred)
print("Classification Report:",)
print (result1)
%matplotlib inline
import matplotlib.pyplot as plt
plt.plot(k_range,scores_list)
plt.xlabel("Value of K")
plt.ylabel("Accuracy")

classifier = KNeighborsClassifier(n_neighbors=8)
classifier.fit(X_train, y_train)

classes = {0:'setosa',1:'versicolor',2:'virginicia'}
x_new = [[1,1,1,1],[4,3,1.3,0.2]]
y_predict = rnc.predict(x_new)
print(classes[y_predict[0]])
print(classes[y_predict[1]])

