
数据结构 - 算法基础
算法是一个循序渐进的过程,它定义了一组按特定顺序执行以获得所需输出的指令。算法通常独立于底层语言创建,即一个算法可以用多种编程语言实现。
从数据结构的角度来看,以下是一些重要的算法类别 −
搜索 − 在数据结构中搜索项目的算法。
排序 −按特定顺序对项目进行排序的算法。
插入 − 在数据结构中插入项目的算法。
更新 − 在数据结构中更新现有项目的算法。
删除 − 从数据结构中删除现有项目的算法。
算法的特征
并非所有过程都可以称为算法。算法应具有以下特征 −
无歧义 − 算法应该清晰明确。其每个步骤(或阶段)及其输入/输出都应该清晰,并且必须只有一个含义。
输入 − 算法应该有0个或多个明确定义的输入。
输出 − 算法应该有1个或多个明确定义的输出,并且应该与期望的输出匹配。
有限性 − 算法必须在有限数量的步骤后终止。
可行性 − 应该在现有资源下可行。
独立性 −算法应该有逐步说明,并且独立于任何编程代码。
如何编写算法?
编写算法没有明确的标准。相反,它取决于具体问题和资源。算法从不是为了支持特定的编程代码而编写的。
众所周知,所有编程语言都共享一些基本的代码结构,例如循环(do、for、while)、流程控制(if-else)等。这些通用结构可用于编写算法。
我们以逐步的方式编写算法,但情况并非总是如此。算法编写是一个过程,是在明确问题域之后执行的。也就是说,我们应该了解我们正在设计解决方案的问题领域。
示例
让我们尝试通过一个例子来学习算法编写。
问题 − 设计一个算法,将两个数字相加并显示结果。
步骤 1 − 开始
步骤 2 − 声明三个整数 a、b 和 c
步骤 3 − 定义 a 和 b 的值
步骤 4 − 将 a 和 b 的值相加
步骤 5 −将步骤 4的输出存储到c
步骤 6 − 打印 c
步骤 7 − 停止
算法告诉程序员如何编写程序。或者,算法可以写成 −
步骤 1 − 开始添加
步骤 2 − 获取 a 和 b 的值
步骤 3 − c ← a + b
步骤 4 − 显示 c
步骤 5 − 停止
在算法设计和分析中,通常使用第二种方法来描述算法。它使分析师能够轻松地分析算法,忽略所有不必要的定义。他可以观察正在使用的操作以及流程的流程。
编写步骤编号是可选的。
我们设计一种算法来获得给定问题的解决方案。一个问题可以通过多种方式解决。
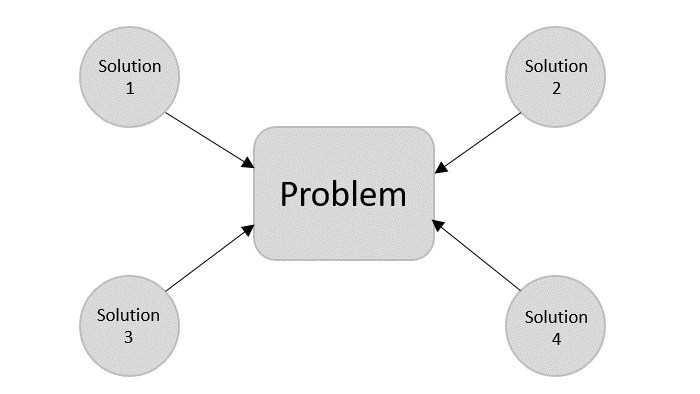
因此,对于给定问题可以推导出许多求解算法。下一步是分析这些提出的求解算法,并实现最合适的解决方案。
算法分析
算法的效率可以在两个不同的阶段进行分析:实施前和实施后。它们如下: −
先验分析 − 这是对算法的理论分析。算法的效率是通过假设所有其他因素(例如处理器速度)保持不变且对实现没有影响来衡量的。
后验分析 − 这是对算法的实证分析。所选算法使用编程语言实现。然后在目标计算机上执行。在此分析中,会收集实际统计数据,例如运行时间和所需空间。
我们将学习先验算法分析。算法分析涉及各种操作的执行或运行时间。操作的运行时间可以定义为每次操作执行的计算机指令数。
算法复杂度
假设X是一种算法,n是输入数据的大小,则算法X所使用的时间和空间是决定其效率的两个主要因素。
时间因素 − 时间是通过计算排序算法中关键操作(例如比较)的数量来衡量的。
空间因素 −空间是通过计算算法所需的最大内存空间来衡量的。
算法的复杂度 f(n) 给出了算法所需的运行时间和/或存储空间,其中 n 是输入数据的大小。
空间复杂度
算法的空间复杂度表示算法在其生命周期内所需的内存空间量。算法所需的空间等于以下两个部分的总和 −
固定部分是指存储某些数据和变量所需的空间,这些数据和变量与问题的大小无关。例如,使用的简单变量和常量、程序大小等。
变量部分是指变量所需的空间,其大小取决于问题的大小。例如,动态内存分配、递归堆栈空间等。
任何算法 P 的空间复杂度 S(P) 都是 S(P) = C + SP(I),其中 C 是算法的固定部分,S(I) 是算法的可变部分,取决于实例特征 I。以下是一个简单的示例,试图解释 − 的概念。
算法:SUM(A, B)
步骤 1 − 开始
步骤 2 − C ← A + B + 10
步骤 3 − 停止
这里我们有三个变量 A、B 和 C 以及一个常量。因此 S(P) = 1 + 3. 现在,空间取决于给定变量和常量类型的数据类型,并且会相应地成倍增加。
时间复杂度
算法的时间复杂度表示算法运行完成所需的时间。时间需求可以定义为数值函数 T(n),其中 T(n) 可以用步数来衡量,前提是每一步都消耗常数时间。
例如,两个 n 位整数的加法需要 n 步。因此,总计算时间为 T(n) = c ∗ n,其中 c 是两位加法所需的时间。这里,我们观察到 T(n) 随着输入大小的增加而线性增长。

