
分治算法
使用分治法,将手头的问题分解成更小的子问题,然后分别求解每个问题。当我们不断将子问题分解成更小的子问题时,最终可能会达到无法再进行进一步分解的阶段。由于计算时间更短,因此这些最小的子问题会使用原始解进行求解。所有子问题的解最终合并,以获得原始问题的解。
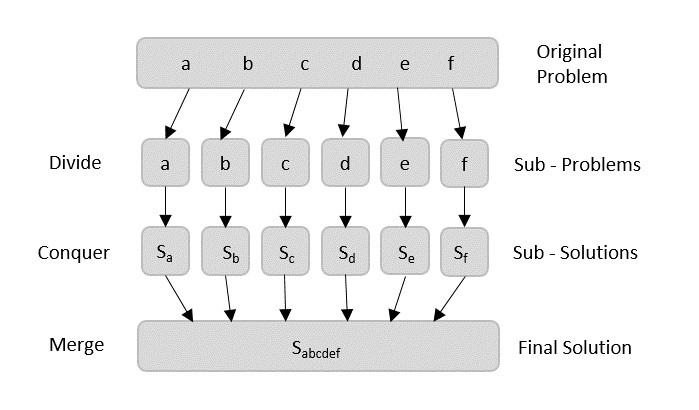
广义上,我们可以将分而治之方法理解为三个步骤。
划分/拆分
此步骤涉及将问题分解为更小的子问题。子问题应该代表原始问题的一部分。此步骤通常采用递归方法对问题进行划分,直到没有子问题可以进一步划分。在此阶段,子问题的尺寸变得很小,但仍然代表着实际问题的某些部分。
征服/解决
此步骤接收许多较小的子问题需要解决。通常,在此级别,这些问题本身就被视为"已解决"。
合并/组合
当较小的子问题得到解决后,此阶段会递归地将它们组合起来,直到它们形成原始问题的解。这种算法方法以递归方式运行,并且征服和合并步骤非常接近,以至于它们看起来像一个整体。
数组作为输入
各种算法可以通过多种方式获取输入,以便使用分治技术进行求解。数组就是其中之一。在需要列表形式输入的算法中,例如各种排序算法,数组数据结构是最常用的。
在下面的排序算法的输入中,数组输入被拆分成多个子问题,直到无法再拆分为止。
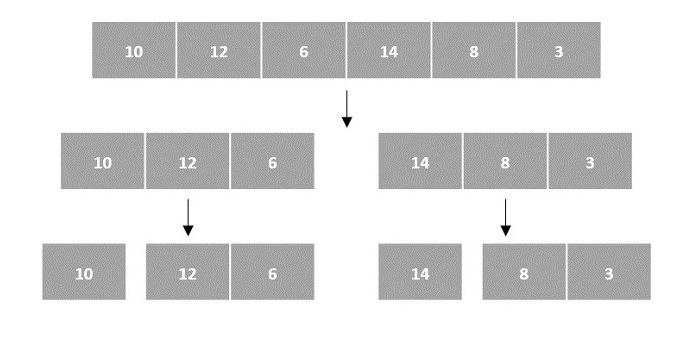
然后,对子问题进行排序(征服步骤),并合并以形成原始数组的解(合并步骤)。
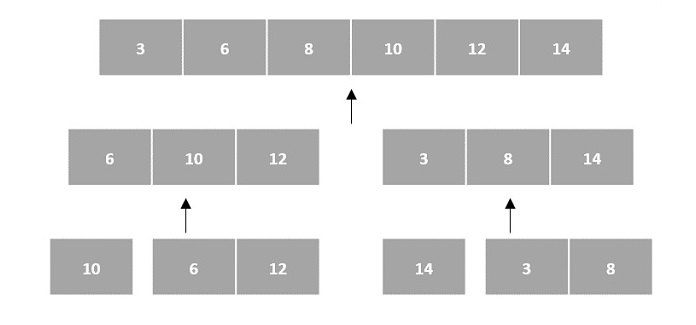
由于数组是索引和线性数据结构,因此排序算法最常使用数组数据结构来接收输入。
链表作为输入
另一种可用于分治算法输入的数据结构是链表(例如,使用链表进行归并排序)。与数组类似,链表也是按顺序存储数据的线性数据结构。
考虑链表上的归并排序算法;遵循非常流行的龟兔赛跑算法,对链表进行划分,直到无法再划分为止。
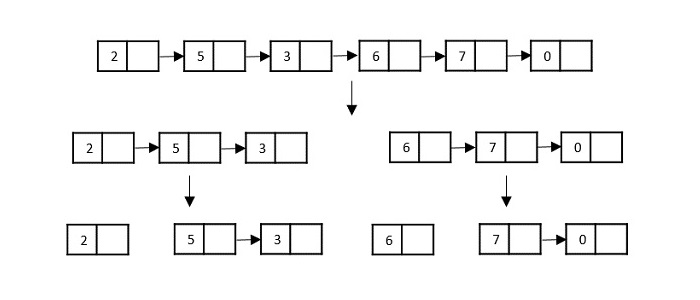
然后,对列表中的节点进行排序(归并排序)。然后,这些节点以递归方式组合(或合并),直到获得最终解决方案。
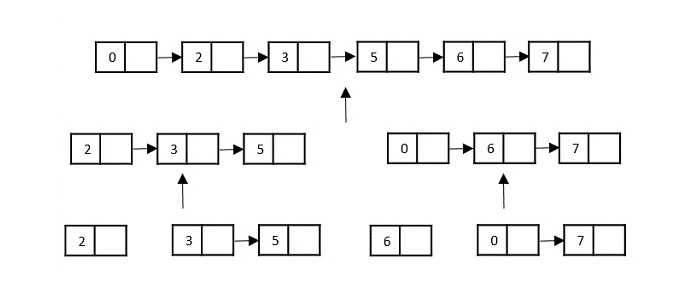
由于链表不是索引线性数据结构,因此可以使用略有不同的技术在链表数据结构上执行各种搜索算法。它们必须使用列表节点中可用的指针来处理。
分治法的优缺点
分治法支持并行,因为子问题是独立的。因此,使用此技术设计的算法可以在多处理器系统或不同的机器上同时运行。
在这种方法中,大多数算法都是使用递归设计的,因此内存管理非常高。对于递归函数,需要使用堆栈来存储函数状态。
分治法示例
以下计算机算法基于分治编程方法 −
解决任何计算机问题的方法有很多种,但上述方法就是分而治之的一个很好的例子。

