
数据结构 - 渐近分析
渐近分析
算法的渐近分析是指定义其运行时性能的数学基础/框架。利用渐近分析,我们可以很好地推导出算法的最佳情况、平均情况和最坏情况。
渐近分析是输入受限的,即如果算法没有输入,则推断其运行时间为常数。除"输入"外,所有其他因素均视为常数。
渐近分析是指以数学计算单位计算任何操作的运行时间。例如,一个操作的运行时间计算为 f(n),而另一个操作的运行时间计算为 g(n2)。这意味着第一个操作的运行时间将随着 n 的增加而线性增加,而第二个操作的运行时间将随着 n 的增加而呈指数增加。同样,如果 n 非常小,则两个操作的运行时间将几乎相同。
通常,算法所需的时间分为三种类型 −
最佳情况 − 程序执行所需的最短时间。
平均情况 − 程序执行所需的平均时间。
最坏情况 −程序执行所需的最大时间。
渐近符号
算法的执行时间取决于指令集、处理器速度、磁盘 I/O 速度等。因此,我们用渐近的方式估计算法的效率。
算法的时间函数用 T(n) 表示,其中 n 是输入的大小。
不同类型的渐近符号用于表示算法的复杂度。以下渐近符号用于计算算法的运行时间复杂度。
O − 大 O 符号
Ω −大 Omega 符号
θ − 大 Theta 符号
o − 小 Omega 符号
ω − 小 Omega 符号
大 O,O:渐近上界
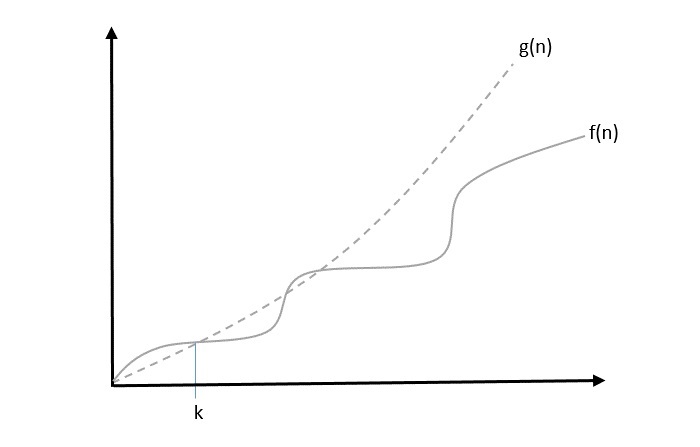
符号 Ο(n) 是表示算法运行时间上限的正式方式。是最常用的符号。它衡量的是最坏情况的时间复杂度,即算法完成所需的最长时间。
如果存在正整数n的值为n0,并且存在正常数c,使得−
,则函数f(n)可以表示为g(n)的阶,即O(g(n))。当$n > n_{0}$时,$f(n)\leqslant c.g(n)$始终成立
因此,函数g(n)是函数f(n)的上限,如下所示g(n) 的增长速度比 f(n) 快。
示例
考虑一个给定函数,$f(n) = 4.n^3 + 10.n^2 + 5.n + 1$
设 $g(n) = n^3$,
对于所有 $n > 2$ 的值,$f(n)\leqslant 5.g(n)$
因此,f(n) 的复杂度可以表示为 $O(g(n))$,即 $O(n^3)$
大欧米茄,Ω:渐近下界
符号Ω(n) 是表示算法运行时间下界的正式方式。它衡量的是最佳情况的时间复杂度,即算法完成所需的最佳时间。
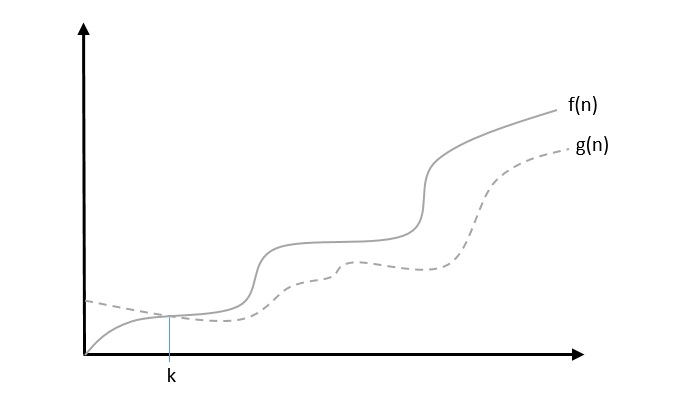
当存在常数c,使得对于所有足够大的n值,$f(n)\geqslant c.g(n)$时,我们称 $f(n) = \Omega (g(n))$。其中n为正整数。这意味着函数g是函数f的下界;在 n> 达到某个值之后,f 永远不会低于 g。
示例
考虑一个给定函数,$f(n) = 4.n^3 + 10.n^2 + 5.n + 1$。
设 $g(n) = n^3$,则对于所有 $n > 0$ 的值,$f(n)\geqslant 4.g(n)$。
因此,f(n) 的复杂度可以表示为 $\Omega (g(n))$,即 $\Omega (n^3)$。
Theta,θ:渐近紧界
符号 θ(n) 是表示算法运行时间下限和上限的正式方式。有些人可能会将 Theta 符号与平均情况的时间复杂度混淆;虽然大 Theta 符号可以几乎准确地用于描述平均情况,但也可以使用其他符号。
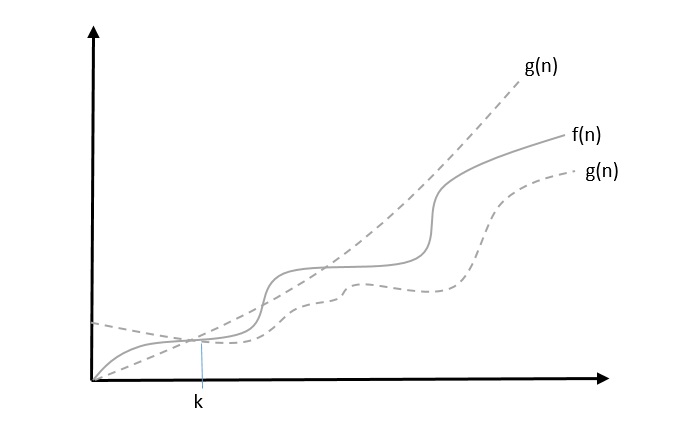
当存在常数 c1 和 c2,使得对于所有足够大的 n 值,$c_{1}.g(n) \leqslant f(n) \leqslant c_{2}.g(n)$ 时,我们称 $f(n) = heta(g(n))$。这里 n 是一个正整数。
这意味着函数 g 是函数 f 的紧界。
示例
考虑一个给定函数,$f(n) = 4.n^3 + 10.n^2 + 5.n + 1$
设 $g(n) = n^3$,对于 n 的所有较大值,$4.g(n) \leqslant f(n) \leqslant 5.g(n)$。
因此,f(n) 的复杂度可以表示为 $heta(g(n))$,即 $heta(n^3)$。
小 Oh, o
O-notation 提供的渐近上界可能渐近紧,也可能不渐近紧。上界 $2.n^2 = O(n^2)$ 是渐近紧的,但上界 $2.n = O(n^2)$ 却不是。
我们使用 o-符号 来表示非渐近紧的上界。
我们正式定义 o(g(n))(n 的 g 的小 oh)为集合 f(n) = o(g(n)),其中任意正常数 $c > 0$,存在一个值 $n_{0} > 0$,使得 $0 \leqslant f(n) \leqslant c.g(n)$。
直观地,在 o-符号 中,函数 f(n) 相对于g(n) 当 n 趋近于无穷大时;即:
$$\lim_{n ightarrow \infty}\left(\frac{f(n)}{g(n)} ight) = 0$$
示例
考虑同一个函数,$f(n) = 4.n^3 + 10.n^2 + 5.n + 1$
设 $g(n) = n^{4}$,
$$\lim_{n ightarrow \infty}\left(\frac{4.n^3 + 10.n^2 + 5.n + 1}{n^4} ight) = 0$$
因此,f(n)的复杂度可以表示为 $o(g(n))$,即: $o(n^4)$。
小 Omega,ω
我们使用 ω-notation 来表示非渐近紧的下界。然而,正式地,我们将 ω(g(n))(n 的 g 的小 Omega)定义为集合 f(n) = ω(g(n)),其中任意正常数 C > 0 且存在一个值 $n_{0} > 0$,使得 $0 \leqslant c.g(n) < f(n)$。
例如,$\frac{n^2}{2} = \omega (n)$,但 $\frac{n^2}{2} eq \omega (n^2)$。关系 $f(n) = \omega (g(n))$ 意味着存在以下极限
$$\lim_{n ightarrow \infty}\left(\frac{f(n)}{g(n)} ight) = \infty$$
也就是说,当 n 趋于无穷大时,f(n) 相对于 g(n) 变得任意大。
示例
考虑同一个函数,$f(n) = 4.n^3 + 10.n^2 + 5.n + 1$
设 $g(n) = n^2$,
$$\lim_{n ightarrow \infty}\left(\frac{4.n^3 + 10.n^2 + 5.n + 1}{n^2} ight) = \infty$$
因此,f(n) 的复杂度可以表示为 $o(g(n))$,即 $\omega (n^2)$。
常见渐近符号
以下列出了一些常见的渐近符号 −
| constant | − | O(1) |
| logarithmic | − | O(log n) |
| linear | − | O(n) |
| n log n | − | O(n log n) |
| quadratic | − | O(n2) |
| cubic | − | O(n3) |
| polynomial | − | nO(1) |
| exponential | − | 2O(n) |
Apriori 和 Apostiari 分析
Apriori 分析是指在特定系统上运行之前进行分析。此分析是使用某些理论模型定义函数的阶段。因此,我们只需查看算法本身,即可确定其时间和空间复杂度,而无需在具有不同内存、处理器和编译器的特定系统上运行它。
算法的 Apostiari 分析是指我们仅在系统上运行算法后才对其进行分析。它直接依赖于系统,并且会因系统而异。
在工业界,我们无法进行 Apostiari 分析,因为软件通常是为匿名用户开发的,而匿名用户会在与工业界不同的系统上运行该软件。
在 Apriori 分析中,我们使用渐近符号来确定时间和空间复杂度,因为它们在不同计算机中有所不同;然而,它们的渐近性是相同的。

