
二分查找算法
二分查找是一种快速的查找算法,运行时复杂度为Ο(log n)。该算法基于分治原则,在搜索之前将数组一分为二。为了使该算法正常工作,数据集合应为排序后的数据。
二分查找通过比较集合中最中间的项来查找特定的键值。如果匹配,则返回该项的索引。但如果中间项的值大于键值,则搜索中间项的右侧子数组。否则,搜索左侧子数组。此过程递归进行,直到子数组的大小减小到零。
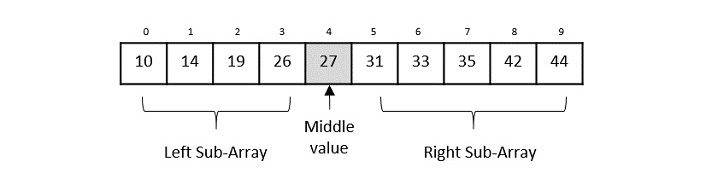
二分查找算法
二分查找算法是一种区间搜索方法,仅按区间进行搜索。二分查找算法的输入必须始终位于已排序的数组中,因为它会根据较大值或较小值将数组划分为子数组。该算法遵循以下步骤 −
步骤 1 − 选择数组中的中间项,并将其与要搜索的键值进行比较。如果匹配,则返回中位数的位置。
步骤 2 − 如果与键值不匹配,则检查键值是否大于或小于中位数。
步骤 3 − 如果键值大于中位数,则在右侧子数组中执行搜索;如果键值小于中位数,则在左侧子数组中执行搜索。
步骤 4 − 重复步骤 1、2 和 3,直到子数组的大小变为 1。
步骤 5 − 如果数组中不存在键值,则算法返回搜索失败。
伪代码
二分查找算法的伪代码如下所示 −
Procedure binary_search
   A ← sorted array
   n ← size of array
   x ← value to be searched

   Set lowerBound = 1
   Set upperBound = n

   while x not found
      if upperBound < lowerBound
         EXIT: x does not exists.

      set midPoint = lowerBound + ( upperBound - lowerBound ) / 2

      if A[midPoint] < x
         set lowerBound = midPoint + 1

      if A[midPoint] > x
         set upperBound = midPoint - 1

      if A[midPoint] = x
         EXIT: x found at location midPoint
   end while
end procedure
分析
由于二分查找算法是迭代搜索,因此计算时间复杂度不如线性查找算法那么简单。
输入数组在每次迭代失败后都会被划分成多个子数组,从而进行迭代搜索。因此,形成的递归关系是一个除法函数。
简单来说,
第一次迭代时,会在整个数组中搜索元素。因此,数组长度 = n。
第二次迭代时,只搜索原始数组的一半。因此,数组长度 = n/2。
第三次迭代时,会搜索前一个子数组的一半。这里,数组的长度 = n/4。
类似地,在第 i 次迭代中,数组的长度将变为 n/2i
为了成功搜索,最后一次迭代后数组的长度必须为 1。因此,
n/2i = 1
这样我们就得到了 −
n = 2i
对两边应用对数,
log n = log 2i
log n = i. log 2
i = log n
二分查找算法的时间复杂度为 O(log n)
示例
二分查找必须对目标数组进行排序才能进行。我们将通过一个图示示例来学习二分查找的过程。以下是我们已排序的数组,假设我们需要使用二分查找来查找值 31 的位置。
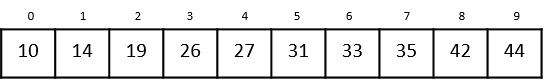
首先,我们使用公式 − 确定数组的一半。
mid = low + (high - low) / 2
这里是 0 + (9 - 0) / 2 = 4(整数值 4.5)。因此,4 是数组的中间值。
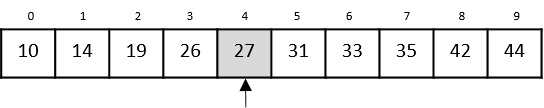
现在,我们将存储在位置 4 的值与正在搜索的值(即 31)进行比较。我们发现位置 4 的值为 27,不匹配。由于该值大于 27,并且我们有一个排序好的数组,因此我们也知道目标值必须位于数组的上半部分。
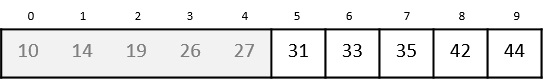
我们将低位改为中位 + 1,然后再次找到新的中位值。
低位 = 中位 + 1
中位 = 低位 + (高位 - 低位) / 2
新的中位现在是 7。我们将存储在位置 7 的值与目标值 31 进行比较。
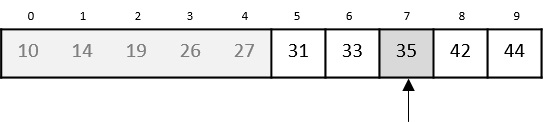
存储在位置 7 的值不匹配,而是小于我们要查找的值。因此,该值必须位于该位置的下半部分。
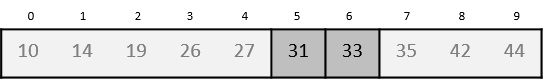
因此,我们再次计算中间值。这次是 5。
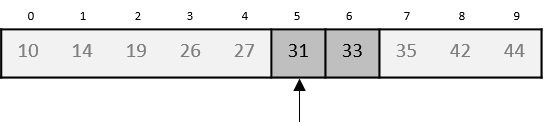
我们将存储在位置 5 的值与目标值进行比较。我们发现它匹配。
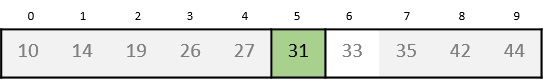
我们得出结论,目标值 31 存储在位置 5。
二分查找将可搜索项减半,从而将比较次数减少到非常少。
实现
二分查找是一种快速搜索算法,运行时复杂度为 Ο(log n)。该搜索算法遵循分治原则。为了使该算法正常工作,数据集合应为排序形式。
#include<stdio.h>
void binary_search(int a[], int low, int high, int key){
   int mid;
   mid = (low + high) / 2;
   if (low <= high) {
      if (a[mid] == key)
         printf("Element found at index: %d
", mid);
      else if(key < a[mid])
         binary_search(a, low, mid-1, key);
      else if (a[mid] < key)
         binary_search(a, mid+1, high, key);
   } else if (low > high)
      printf("Unsuccessful Search
");
}
int main(){
   int i, n, low, high, key;
   n = 5;
   low = 0;
   high = n-1;
   int a[10] = {12, 14, 18, 22, 39};
   key = 22;
   binary_search(a, low, high, key);
   key = 23;
   binary_search(a, low, high, key);
   return 0;
}
输出
Element found at index: 3
Unsuccessful Search
#include <iostream>
using namespace std;
void binary_search(int a[], int low, int high, int key){
   int mid;
   mid = (low + high) / 2;
   if (low <= high) {
      if (a[mid] == key)
         cout << "Element found at index: " << mid << endl;
      else if(key < a[mid])
         binary_search(a, low, mid-1, key);
      else if (a[mid] < key)
         binary_search(a, mid+1, high, key);
   } else if (low > high)
      cout << "Unsuccessful Search" <<endl;
}
int main(){
   int i, n, low, high, key;
   n = 5;
   low = 0;
   high = n-1;
   int a[10] = {12, 14, 18, 22, 39};
   key = 22;
   binary_search(a, low, high, key);
   key = 23;
   binary_search(a, low, high, key);
   return 0;
}
输出
Element found at index: 3
Unsuccessful Search
import java.io.*;
import java.util.*;
public class BinarySearch {
   static void binary_search(int a[], int low, int high, int key) {
      int mid = (low + high) / 2;
      if (low <= high) {
         if (a[mid] == key)
            System.out.println("Element found at index: " + mid);
         else if(key < a[mid])
            binary_search(a, low, mid-1, key);
         else if (a[mid] < key)
            binary_search(a, mid+1, high, key);
      } else if (low > high)
         System.out.println("Unsuccessful Search");
   }
   public static void main(String args[]) {
      int n, key, low, high;
      n = 5;
      low = 0;
      high = n-1;
      int a[] = {12, 14, 18, 22, 39};
      key = 22;
      binary_search(a, low, high, key);
      key = 23;
      binary_search(a, low, high, key);
   }
}
输出
Element found at index: 3
Unsuccessful Search
def binary_search(a, low, high, key):
   mid = (low + high) // 2
   if (low <= high):
      if(a[mid] == key):
         print("The element is present at index:", mid)
      elif(key < a[mid]):
         binary_search(a, low, mid-1, key)
      elif (a[mid] < key):
         binary_search(a, mid+1, high, key)
   if(low > high):
      print("Unsuccessful Search")

a = [6, 12, 14, 18, 22, 39, 55, 182]
n = len(a)
low = 0
high = n-1
key = 22
binary_search(a, low, high, key)
key = 54
binary_search(a, low, high, key)
输出
The element is present at index: 4
Unsuccessful Search

