
后缀数组算法
后缀数组是一种数据结构,它按字典顺序存储给定字符串的所有后缀。它可用于各种字符串处理问题,例如模式匹配、搜索、查找最长公共前缀等等。该数组可以在较大的文本中快速找到模式的位置。
后缀数组的工作原理?
假设文本为"Carpet"。要构建其后缀数组,请按照以下步骤 −
生成给定文本的所有后缀。在本例中,可能的后缀可能是"carpet"、"arpet"、"rpet"、"pet"、"et"和"t"。
对所有后缀进行排序。所有后缀按排序顺序排列为"arpet"、"carpet"、"et"、"pet"、"rpet"和"t"。
因此,后缀数组如下:[1, 0, 4, 3, 2, 5]。
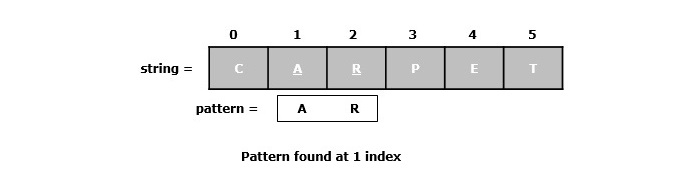
要使用此后缀数组进行模式匹配,我们可以对排序后的后缀执行二分查找,以找到以该模式开头的后缀范围。例如,以上面的字符串"Carpet"为例,我们想要找到模式"ar",我们可以将它与后缀数组中的中间后缀"pet"进行比较。
由于"ar"小于这个后缀,我们可以丢弃后缀数组的右半部分,继续在左半部分进行二分查找。最终,我们会发现以"ar"开头的后缀在原始字符串中的位置为"1"。
我们来看看后缀数组 − 的输入输出场景
输入:
字符串:"AABABCEDBABCDEB"
输出:
Pattern found at index: 3
Pattern found at index: 9
Pattern found at index: 1
示例
以下示例演示了后缀数组在模式匹配中的工作原理。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
// 后缀的结构
struct Suffix {
   int index;
   char suff[100];
};
//比较两个后缀进行排序的函数
int strCompare(const void* a, const void* b) {
   struct Suffix* s1 = (struct Suffix*)a;
   struct Suffix* s2 = (struct Suffix*)b;
   return strcmp(s1->suff, s2->suff);
}
// 填充后缀数组的函数
int* fillSuffixArray(char* txt, int n) {
    struct Suffix* suffixes = (struct Suffix*) malloc(n * sizeof(struct Suffix));
    // 将后缀及其索引存储在数组中
   for (int i = 0; i < n; i++) {
      suffixes[i].index = i;
      strncpy(suffixes[i].suff, &(txt[i]), n - i);
      suffixes[i].suff[n-i] = '\0';
   }
   // 对后缀进行排序
   qsort(suffixes, n, sizeof(struct Suffix), strCompare);
   // 将所有已排序后缀的索引存储在后缀数组中
   int* suffixArr = (int*) malloc(n * sizeof(int));
   for (int i = 0; i < n; i++)
      suffixArr[i] = suffixes[i].index;

   // 释放动态内存
   free(suffixes);
   return suffixArr;
}
// 对后缀数组进行二分查找,查找所有出现的模式
void suffixArraySearch(char* pat, char* txt, int* suffixArr, int n) {
    int m = strlen(pat);
    // 使用构建的后缀数组在文本中进行二分查找
   int l = 0, r = n - 1;
   while (l <= r) {
      int mid = l + (r - l) / 2;
      char substr[100];
      strncpy(substr, &(txt[suffixArr[mid]]), m);
      substr[m] = '\0';
      int res = strncmp(pat, substr, m);
      if (res == 0) {
         printf("Pattern found at index: %d
", suffixArr[mid]);
         //移至中间左侧
         int temp = mid - 1;
         while (temp >= 0 && strncmp(pat, &(txt[suffixArr[temp]]), m) == 0) {
            printf("Pattern found at index: %d
", suffixArr[temp]);
            temp--;
         }
         // 移至中间右侧
         temp = mid + 1;
         while (temp < n && strncmp(pat, &(txt[suffixArr[temp]]), m) == 0) {
            printf("Pattern found at index: %d
", suffixArr[temp]);
            temp++;
         }
         return;
      }
      if (res < 0) r = mid - 1;
      else l = mid + 1;
    }
    printf("Pattern not found
");
}
int main() {
   char txt[] = "AAAABCAEAAABCBDDAAAABC";
   // 要搜索的模式
   char pat[] = "AAABC";
   int n = strlen(txt);
   int* suffixArr = fillSuffixArray(txt, n);
   suffixArraySearch(pat, txt, suffixArr, n);
   free(suffixArr);
   return 0;
}
#include <iostream>
#include <algorithm>
#include <cstring>
using namespace std;
// 后缀的结构
struct Suffix {
   int index;
   string suff;
};
// 用于比较两个后缀以进行排序的函数
bool strCompare(Suffix a, Suffix b) {
    return a.suff < b.suff;
}
// 用于填充后缀数组的函数
int* fillSuffixArray(string txt, int n) {
   Suffix* suffixes = new Suffix[n];
   // 将后缀和索引存储在数组中
   for (int i = 0; i < n; i++) {
      suffixes[i].index = i;
      suffixes[i].suff = txt.substr(i, n - i);
   }
   // 对后缀进行排序
   sort(suffixes, suffixes+n, strCompare);
   // 将所有已排序后缀的索引存储在后缀数组中
   int* suffixArr = new int[n];
   for (int i = 0; i < n; i++)
      suffixArr[i] = suffixes[i].index;
   // 释放动态内存
   delete[] suffixes;
   return suffixArr;
}
// 对后缀数组进行二分搜索,找到所有出现的模式
void suffixArraySearch(string pat, string txt, int* suffixArr, int n) {
   int m = pat.length();
   // 二分查找模式
   int l = 0, r = n - 1;
   while (l <= r) {
      int mid = l + (r - l) / 2;
      string substr = txt.substr(suffixArr[mid], m);
      if (pat == substr) {
         cout << "Pattern found at index: " << suffixArr[mid] << endl;
         //移至中间左侧
         int temp = mid - 1;
         while (temp >= 0 && txt.substr(suffixArr[temp], m) == pat) {
            cout << "Pattern found at index: " << suffixArr[temp] << endl;
            temp--;
         }
         // 移至中间右侧
         temp = mid + 1;
         while (temp < n && txt.substr(suffixArr[temp], m) == pat) {
            cout << "Pattern found at index: " << suffixArr[temp] << endl;
            temp++;
         }
         return;
      }
      if (pat < substr) r = mid - 1;
      else l = mid + 1;
   }
   cout << "Pattern not found" << endl;
}
int main() {
   string txt = "AAAABCAEAAABCBDDAAAABC";
   // 要搜索的模式
   string pat = "AAABC";
   int n = txt.length();
   int* suffixArr = fillSuffixArray(txt, n);
   suffixArraySearch(pat, txt, suffixArr, n);
   delete[] suffixArr;
   return 0;
}
import java.util.Arrays;
public class Main {
   // 后缀的结构
   static class SuffixCmpr implements Comparable<SuffixCmpr> {
      int index;
      String suff;
      // 构造函数
      public SuffixCmpr(int index, String suff) {
         this.index = index;
         this.suff = suff;
      }
      // 按字母顺序对后缀进行排序
      public int compareTo(SuffixCmpr other) {
         return this.suff.compareTo(other.suff);
      }
   }
   // 构建后缀数组的方法
   public static int[] fillsuffixArray(String s) {
      int n = s.length();
      SuffixCmpr[] suffixes = new SuffixCmpr[n];
      // 创建并排序后缀
      for (int i = 0; i < n; i++) {
         suffixes[i] = new SuffixCmpr(i, s.substring(i));
      }
      Arrays.sort(suffixes);
      // 存储所有已排序后缀的索引
      int[] fillsuffixArray = new int[n];
      for (int i = 0; i < n; i++) {
         fillsuffixArray[i] = suffixes[i].index;
      }
      return fillsuffixArray;
   }
   // 使用后缀数组在文本中搜索模式的方法
   public static void suffixArraySearch(String pattern, String txt, int[] suffArr) {
      int n = txt.length();
      int m = pattern.length();
      // 使用后缀数组对文本中的模式进行二分搜索
      int l = 0, r = n - 1;
      while (l <= r) {
         int mid = l + (r - l) / 2;
         int res = pattern.compareTo(txt.substring(suffArr[mid], Math.min(suffArr[mid] + m, n)));
         if (res == 0) {
            System.out.println("Pattern found at index: " + suffArr[mid]);
            // 移动到排序数组中的上一个后缀
            int temp = mid - 1;
            while (temp >= 0 && txt.substring(suffArr[temp], Math.min(suffArr[temp] + m, n)).equals(pattern)) {
                System.out.println("Pattern found at index: " + suffArr[temp]);
                temp--;
            }
            //移动到排序数组中的下一个后缀
            temp = mid + 1;
            while (temp < n && txt.substring(suffArr[temp], Math.min(suffArr[temp] + m, n)).equals(pattern)) {
                System.out.println("Pattern found at index: " + suffArr[temp]);
                temp++;
            }
            return;
         }
         if (res < 0) r = mid - 1;
         else l = mid + 1;
      }
      System.out.println("Pattern not found");
   }
   public static void main(String[] args) {
      String txt = "AAAABCAEAAABCBDDAAAABC";
      String pattern = "AAABC";
      // 填充后缀数组
      int[] suffArr = fillsuffixArray(txt);
      // 调用方法在后缀数组中搜索模式
      suffixArraySearch(pattern, txt, suffArr);
   }
}
def fill_suffix_array(txt):
    # 元组数组,每个元组存储索引和后缀
    suffixes = [(i, txt[i:]) for i in range(len(txt))]
    # 对后缀进行排序
    suffixes.sort(key=lambda x: x[1])
    # 返回排序后的索引列表
    return [suff[0] for suff in suffixes]

def suffixArraySearch(pat, txt, suffix_arr):
    n = len(txt)
    m = len(pat)
    # 迭代后缀数组
    for i in range(n):
        if txt[suffix_arr[i]:min(suffix_arr[i] + m, n)] == pat:
            print(f"Pattern found at index: {suffix_arr[i]}")

def main():
    txt = "AAAABCAEAAABCBDDAAAABC"
    pat = "AAABC"
    suffix_arr = fill_suffix_array(txt)
    suffixArraySearch(pat, txt, suffix_arr)

if __name__ == "__main__":
    main()
Output
Pattern found at index: 8
Pattern found at index: 1
Pattern found at index: 17
后缀数组的复杂度
使用后缀数组进行模式匹配的优点是它只需要 O(m log n) 的时间复杂度,其中 m 是模式的长度,n 是字符串的长度。缺点是它首先需要 O(n log n) 的时间复杂度和 O(n) 的空间来构建后缀数组。

